在 Harness Engineering 这个概念逐渐流行甚至要过气之后,我终于理解了这个词背后的含义。作为一个笨人,决定用费曼学习法,把 Harness Engineering 这个词讲明白,也算是对自己的一个交代。
从 Prompt Engineering 说起
在 ChatGPT 刚出来的时候,大家面对一个空白的输入框,不知道说什么好,于是我们看到大量的教程、指南和分享中,大家开始提prompt这个词。而随之而来的,便是 Prompt Engineering。
大家希望通过修改自己的 Prompt,来让模型返回不同的内容,从而达成让模型完成不同的工作任务。在 2023 年的时候,Prompt Engineering 作为一个指引,帮助我们把 Prompt 写的更加结构化、更加明确化,向模型描述我们到底希望看到和使用的内容的框架,指引和帮助很多人走上了 AI 之旅。
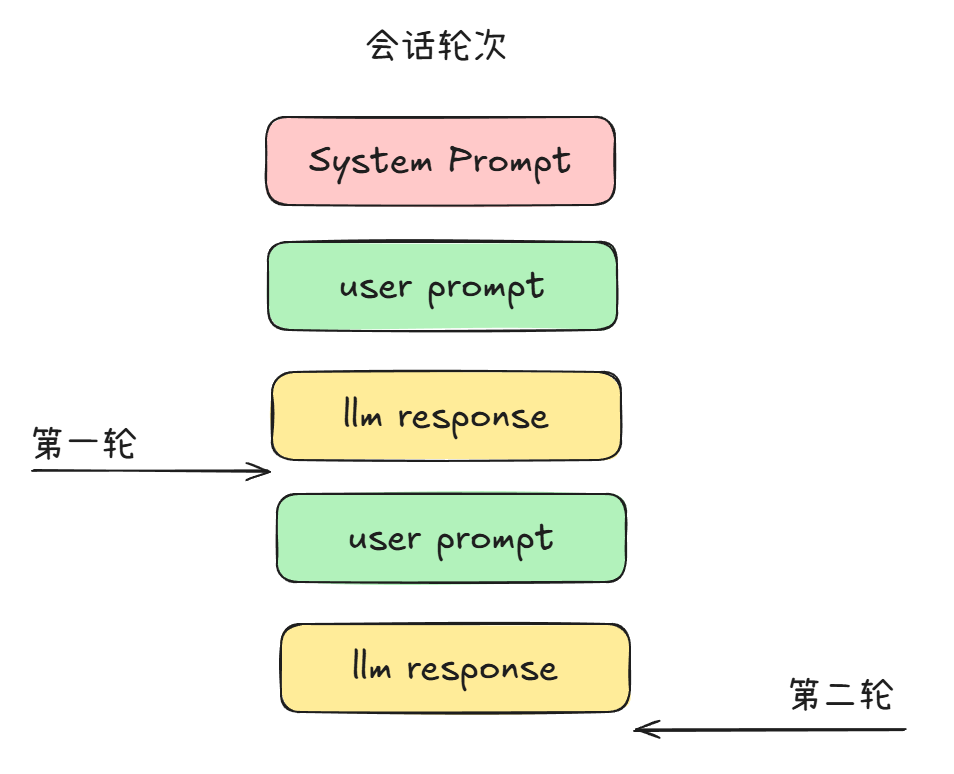
其中的技巧即使在今天,也并非完全失效,在这个阶段,由于应用的形态以 ChatBot 为主,同时 API 主要也是在使用 Chat Completions API 为主,在这个阶段,我们的主要对于上下文的操作就是不断 Append,把用户的输入和模型的输入一起写入到整个会话的 Message。
但只有 Chatbot 是无法满足业务的需求的;我们开始研究使用 LLM 来完成更多的工作,并随着 GPT 3.5 Turbo /GPT4 支持 ToolCall ,LLM 开始可以稳定的输出更多的信息,从而延伸出了更多的功能和能力;我们开始在整个会话轮次中塞入更多的东西。Chat Completions API 在返回 Tool 的 Params 的时候,也需要我们将对应的 Tool 的 Response 一并回传给模型,整个会话的轮次也开始越变越长。
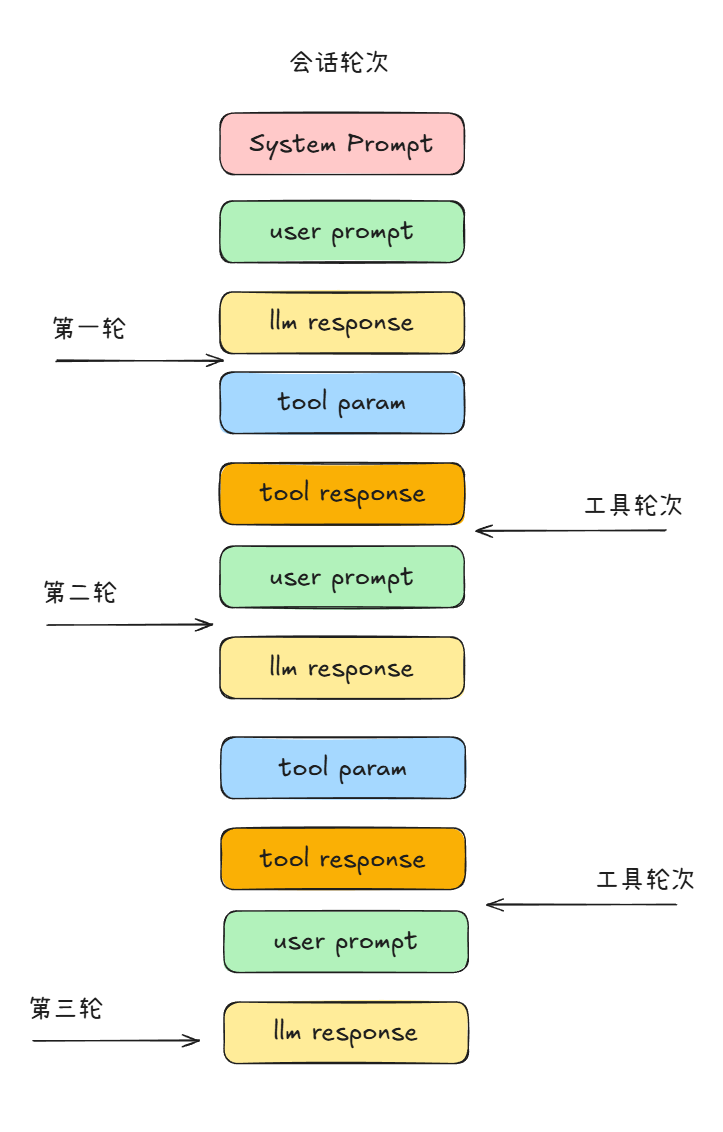
而模型的上下文和注意力机制决定了,模型的注意力预算有限;在这种持续的、长轮次的沟通方式累计下,整个上下文会快速累积(tool 的调用结果、system prompt、历史存储的状态、检索的内容都会进入到整个 Messages 序列里)。我们需要做出一些方式的优化,来确保在每次推理时,从不断增长的信息里,挑出最小但信号最强的那一组 token。
而随着 Agent 的概念开始出现,我们开始对 Agent 本身的能力开始做不同的上下文裁剪的方案,来确保 LLM 能够拿到最重要的信息。直到 2025 年中,Context Engineering 的概念被Karpathy、Tobi Lütke 等人提出,随后 Anthropic 发布 《Effective context engineering for AI agents》,我们开始正式用 Context Engineering 的理念来管理我们的 Agent 行为。
从 Context Engineering 到 Harness Engineering
随着 Context Engineering 的实践逐渐成熟,我们开始能够更有效地管理有限的上下文预算,使 Agent 在复杂任务中保持更好的信息相关性和行为一致性(但这并没有彻底解决长程任务中的可靠性问题)。随之而来的是,我们迎来了 Agent 的时代;Claude Code 的横空出世,Claude 3.5 Sonnet 、Claude 4.0 Sonnet、Claude 4.0 Opus 等模型的推出,我们开始发现 Agent 可以很好的完成工作;
我们开始大量的使用这些 Coding Agent 来完成工作;但我们也不只满足于让 Agent 能完成工作,我们开始思考让 Agent 尝试更加长久的工作,完成长程任务。ReAct 等框架帮助我们初步探索了 Agent 长程任务的可能,但整体来说执行还是非常的不稳定的,依然需要人类介入其中,承担一些中间的粘合、持续推进的动力。
但很显然,我们不希望人类担任这个无价值的 Connector,与此同时,Anthropic 在长程 Agent 实践中展示了一种 Harness 设计方案《Effective harnesses for long-running agents》。不过这一版的 Harness 的定义和我们如今看到的 Harness 定义还是有很多变化的,它还定义了特定的 Feature List。如今我们用的 Claude Code 则是用了 Dynamic workflows 来完成了相同但更强的功能。
2026 年 2 月 5 日,HashiCorp 的 Co-Founder Mitchell Hashimoto 写下了 《My AI Adoption Journey》,在个人实践中明确使用并阐述这一概念,并定义了两种可能的形式:改进 AGENTS.md 和 改进编程工具。
I’m making an earnest effort whenever I see an agent do a Bad Thing to prevent it from ever doing that bad thing again. Or, conversely, I’m making an earnest effort for agents to be able to verify they’re doing a Good Thing.
Mitchell Hashimoto
紧随其后,OpenAI 在 2 月 11 日发布了他们自己的 《Harness engineering: leveraging Codex in an agent-first world》的文章,在这篇文章里, OpenAI 没有定义 Harness Engineering 是什么,但给出了不少他们做的修改的范式,并给出了他们认为重要的部分: 识别缺失的部分,并让 Agent 编写相关的部分。
Humans always remain in the loop, but work at a different layer of abstraction than we used to. We prioritize work, translate user feedback into acceptance criteria, and validate outcomes. When the agent struggles, we treat it as a signal: identify what is missing—tools, guardrails, documentation—and feed it back into the repository, always by having Codex itself write the fix.
Ryan Lopopolo, Member of the Technical Staff of OpenAI
至此,Harness Engineering 的画像变得清晰:不是改进模型本身,而是改进围绕模型的一切环境、产物和工具,通过这些环境和产物以及工具,来让模型正确的工作。
所以,到底什么是 Harness?
我们可以简单的将 Agent 的拆解为 Model + Harness,所有不在 Model 的部分,都在 Harness。当然,这不是严格的系统架构定义,而是一种工程视角上的简化:在模型权重不变的前提下,我们能够主动设计和优化的执行机制、上下文管理、工具调用、状态管理与验证反馈,可以统称为 Harness 的一部分。但这句话的关键不在于拆解方式,而在于解决问题的思路 —— 将目光从改进模型切换为改进 Harness。
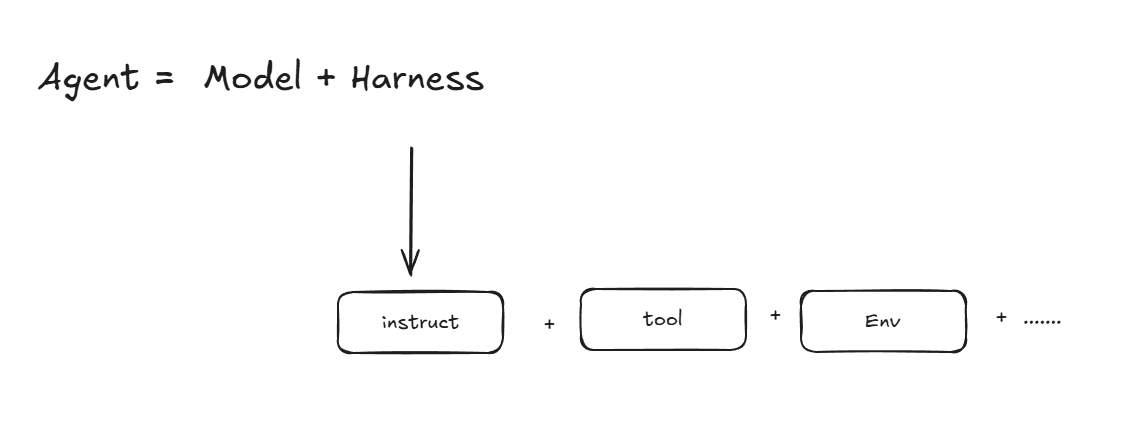
这就好像我们试图让一个人去计算一个很难的题目,由于替换人的难度很大,成本很高,所以我们选择将目光转移到人可以用的工具上。我们可以用算盘去计算一个复杂的题目,但如果我同样还可以使用一个强大的计算器,那自然使用计算器可以更快的到达目的地。而好的工具(Harness),也给了我们让一个更差的模型获得更好的质量的可能。好的模型可以向下兼容算盘,但给它计算器,它才能把精力省下来做更难的部分。
当然,更强的模型往往能够驾驭更复杂的工具,完成更加困难的任务。但 Harness Engineering 的意义,不只是进一步提高模型的能力表现,而是降低任务成功对模型单次推理和执行正确性的依赖。
通过外部工具、状态管理、验证反馈与错误恢复,我们可以把原本需要模型独立完成的部分工作交给工程系统,让同一个模型更加稳定地完成任务。
Harness Engineering 的目标,是将模型具有不确定性的推理与执行能力,转化为可验证、可恢复、可持续的任务交付能力,提高任务的端到端成功率。
举个例子,假设我们希望一个 Coding Agent 完成一次代码重构。它不仅需要修改代码,还需要确保修改没有破坏现有功能。
- 如果没有 Harness,我们只能期待模型记得运行测试、正确理解测试结果,并在失败时尝试修复。
- 但如果我们将编译检查、单元测试、端到端测试和任务状态管理接入 Harness,那么即使模型某次修改出错,系统仍然能够发现问题、提供反馈,并引导 Agent 继续修复。
这并没有改变模型本身的能力,却改变了整个系统完成任务的可靠性,帮助整个系统更加准确的交付结果。
So,为什么模型公司要搞自己的 Harness?
很显然,Harness 存在的目标是帮助模型获得更好的结果。各个模型公司在训练环境的差异,会使得模型公司倾向于通过优化 Harness 来帮助自己获得更好的结果和智能。这也是为什么你会关注到,很多模型的 Benchmark 必须说清楚用的是什么 Harness 得到了这个分数,因为 Harness 就是会影响最终模型的结果。
而不同的模型公司在设计哲学上的变化最终演变出来了不同的 Harness,也让我们看到了不同的分类 —— Claude Code、Codex 、Pi、Deepseek Harness 。每个 Harness 背后都是对应模型公司或应用公司对于 Agent 的重新理解和定义。而对于这件事的理解,让我对于 Harness 的生态位既感到乐观,也感到悲观。
我们如何选择自己的身位?
毫无疑问,我们可以将 Harness 区分为 Base Harness 和 Domain Harness / Business Harness:Base Harness 代表模型公司基于 Agent 能力抽象出来的最小集合;而 Domain Harness 是将特定领域的知识、工具、业务流程和验收标准封装成 Agent 可执行、可验证的工程系统。
我对 Base Harness 的生态位悲观,因为对于模型公司来说,他们会优先适配自己的 Base Harness,来帮助自己以最低成本获得最好的效果,同时,也会分配一部分精力去适配社区使用比较多的 Harness。但另一方面,这种和模型的深度绑定,让 开源的 Base Harness 会在持续发展的阶段中,逐步被抛下(除非你能成为 The One)。这让我们在选择 Base Harness 时要谨慎。
目前来看, Pi 可能会好一点,因为足够简单,和本身设计理念的简单,会让他大概率就算靠模型泛化,不做特定的优化,也能获得不错的结果。其他缺少独特系统能力、只追求复制官方 Agent 产品体验的通用 Harness,长期竞争空间可能被压缩;而和模型厂商绑定的 Harness,则会逐步在自己的 Harness 上拥有最佳表现,顶多再适配一下 Codex / Claude Code。如果一个第三方的 Harness 不够薄、不够可替换,就容易被模型厂商的官方 harness 挤压,最终失去自己的价值(回想我们之前看到的复杂的 Garry Tan 的 Gstack,你还用么?)
同时,我也对 Domain Harness 更加乐观,因为领域知识实在是太深太杂,以至于对于模型公司来说,这些东西可能也会吃下巨大的人力成本。与其花时间去做 Domain Harness,倒不如直接提供更好的开放度(比如 Pi / Deepseek Harness),来帮助领域专家构建 Domain Harness(从这个视角来看,我能理解 Deepseek Harness 的设计理念为何如此激进)。不过这些机会可能并不属于我(虽然我是 EE 背景的人, 但我的领域 Know How 约等于没有,自己的技能都点在互联网 & CS 相关了)。
在这样的生态格局下,我们如何做好 Domain Harness?
当你理解 Harness 的存在价值和设计理念后,接下来就可以动手设计你的 Domain Harness 了,
- 定义你要解决的问题,设计任务集和验收条件:定义领域的真问题和对应的成功标准、验收条件,用于判断 Agent 的行为。
- 选择一个你喜欢 / 熟悉 / 定制方便的 Base Harness,这方面我推荐你看看 Pi 或者 Deepseek Harness, Codex 虽然本身和 GPT 强绑定,但因为 Open Core,你也可以快速找到他的 Base Harness 实现,然后基于此做自己的实现和改造,只是从开放度来讲,前两者还是更好。
- 让 Agent 去尝试完成任务,并在失败的时候停下来分析 Trajectory,在这一步,你要先分析 Agent 的失败原因,到底是缺乏验证机制,导致无法判断对错最终做错了?还是缺乏外部状态,导致模型在长程任务中迷失了自我。
- 如果是缺乏验证机制,那么你需要给到 Agent 一个能够验证对错的方案(可能是一个验证脚本,也可能是一个 Linter),并要求 Agent 看验证的结果再继续推进;并查看 Agent 的行为是否符合预期。
- 如果是缺乏外部状态,那么你需要定义在长程任务中必须要完成的工作,让 Agent 可以自己去跟进状态,并在持续进行长程任务过程中,不会丢失自己的位置(我们看到的 Claude Code 第一版的 Todolist 和后续的 Dynamic workflows都是类似的作用)。
- 如果这两个都不是关键问题,纯粹是 Agent缺乏信息或者外部信息的输入,那么你才需要设计新的工具和引入更多的内容作为 Prompt 来帮助 Agent 获得足够的上下文。
- 至于修改 Prompt 文件,虽是成本最低,最直接的优化手段,但却不应该成为我们的默认选项。
- 当你完成所有的修改后,重新跑一次回归测评,对比成功率、成本、耗时与副作用,来促进下一次优化。
总结
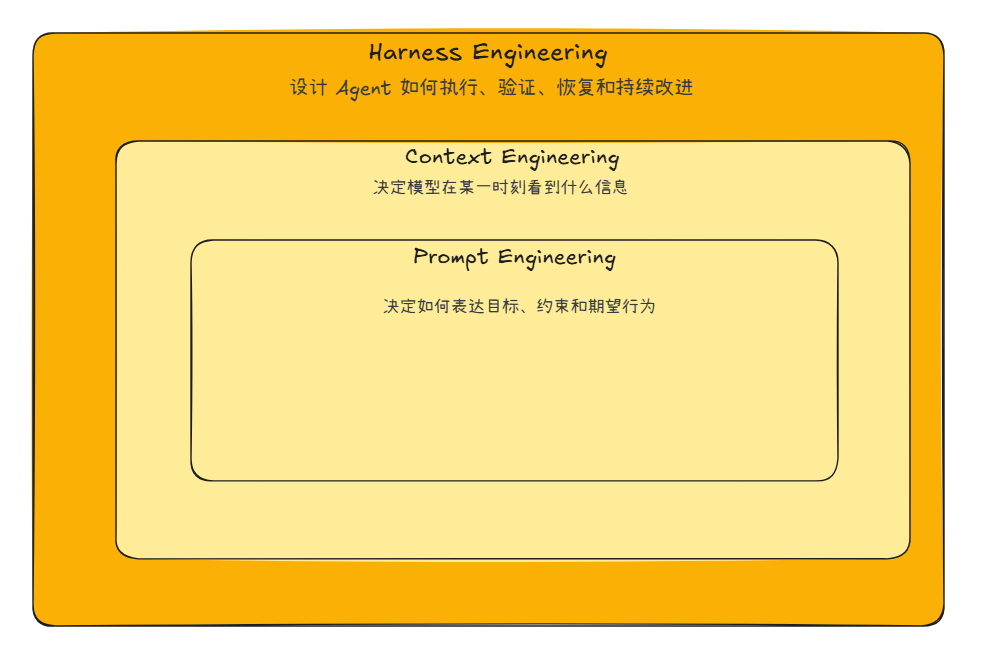
过去,我们花费大量的精力研究如何写出更好的 Prompt,让模型尽可能一次性给出正确的答案。
后来,我们开始研究 Context Engineering,让模型在合适的时间看到合适的信息。
而今天,我们开始研究 Harness Engineering,不再只关注模型在某一次推理中是否正确,而是关注整个系统能否持续、稳定、可验证地完成任务。
从这个角度来看,Harness Engineering 的价值,不是让模型永远不犯错,而是让系统有能力发现错误、修复错误,并从错误中持续改进。
Prompt Engineering 优化的是表达,Context Engineering 优化的是信息,而 Harness Engineering 优化的是完成任务的整个过程。
当模型能力不断提高,我们真正需要积累的,可能不再是某个版本的 Prompt,也不是某个 Agent Framework 的使用技巧,而是那些能够被验证、执行和持续改进的工程经验与业务判断。
模型会不断迭代,Harness 也会不断演进。但如何定义正确、如何验证结果、如何把经验沉淀为可以复用的系统,依然是值得长期投入的事情。
我们正在从教模型如何做事,转向设计一个让模型能够把事情做对的系统。