标签归档:随笔

2026 年9/10 月观影总结

9/10 月份还是看了不少的电影的,不过一直没顾上写总结;于是乎,继续写一下总结;

整个9/10月份一共看了 5 部电影,其中按顺序来分别是:

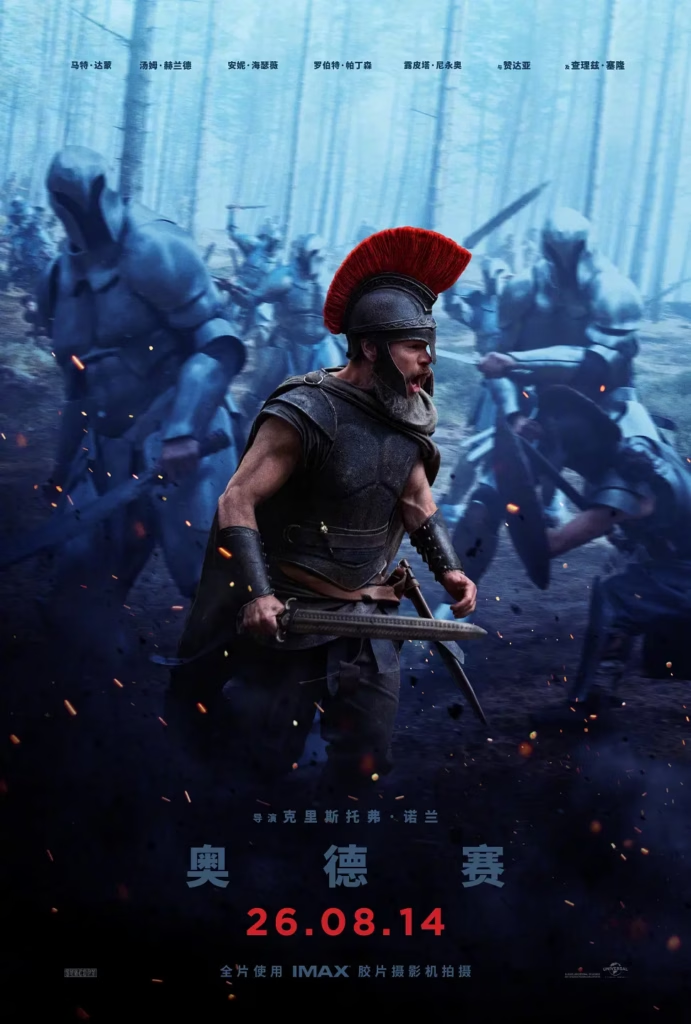
《奥德赛》

奥德赛真的很长,看的我中间还是出去上了趟厕所。不过,我觉得这部剧拍的还不错,特别是马特达蒙的部分,他经历过的事情,真的很考验人性。

看完这部电影的时候,我突然在想:今天 AI 生图、生视频如此盛行,我们为什么不做我们自己的史诗?这部剧是荷马史诗,我们为什么不能拥有中国的史诗?这部电影看得我心生澎湃,我希望同样的状态,可以让海外的人也可以心生澎湃。
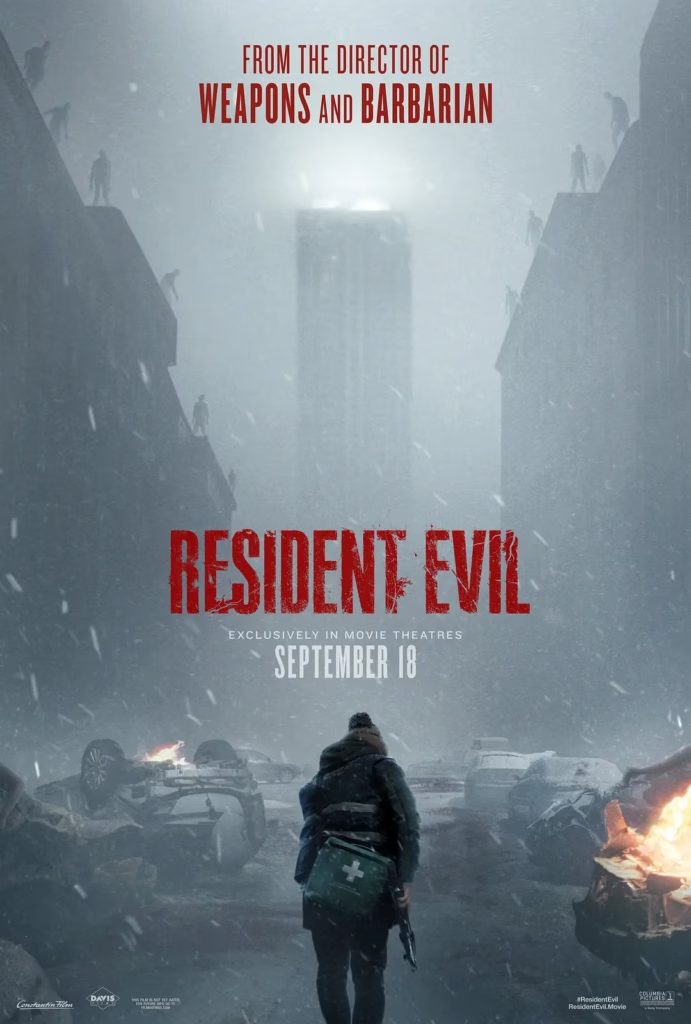
《生化危机:爆发夜》

这部电影我去看的时候,没预期到会被这么吓到|゚Д゚))),整体还是把握吓得一愣一愣的。看这部电影一大感受是 —— 顶楼的实验人员本身不够尊重人和尊重世界,才最终造成了这样的事故,不然或许有改观。

如果你不怕吓,我觉得还行,可以看看。全场最佳的外卖小哥,还挺好玩的。
这个女的真的好可怕。。。

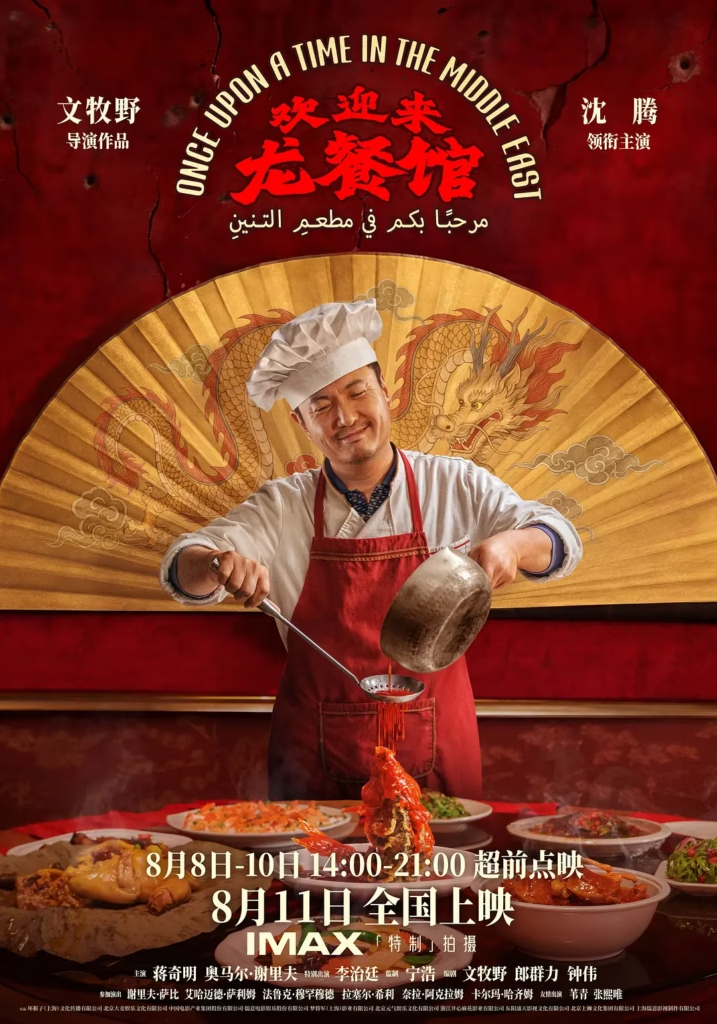
《欢迎来龙餐馆》

龙餐馆听说是反战的,所以来看的时候心里有数,倒也没那么害怕。但我对于人性的残忍还是没有预计到位。。。看到里面的校长做的事情,真的心底对于战争的厌恶又多一分。相比之下,老扎好了很多。

后面在抖音上看到有一些老扎后面的片段,我感觉是二创,但也算是大家对于老扎的认可。
《杀死比尔:血色全传》

我是奔着昆汀来的,杀死比尔 1 看着确实很有昆汀暴力美学的意思 —— 满屋子必须都是血。很刺激;

但是。。。第二部就非常的拉跨了。。。突然峰回路转,感觉昆汀的暴力美学没了,给我一种第二部分是另外一个人拍的。

以及,我最终还是看到的里面的彩蛋《失落的篇章:由纪的复仇》
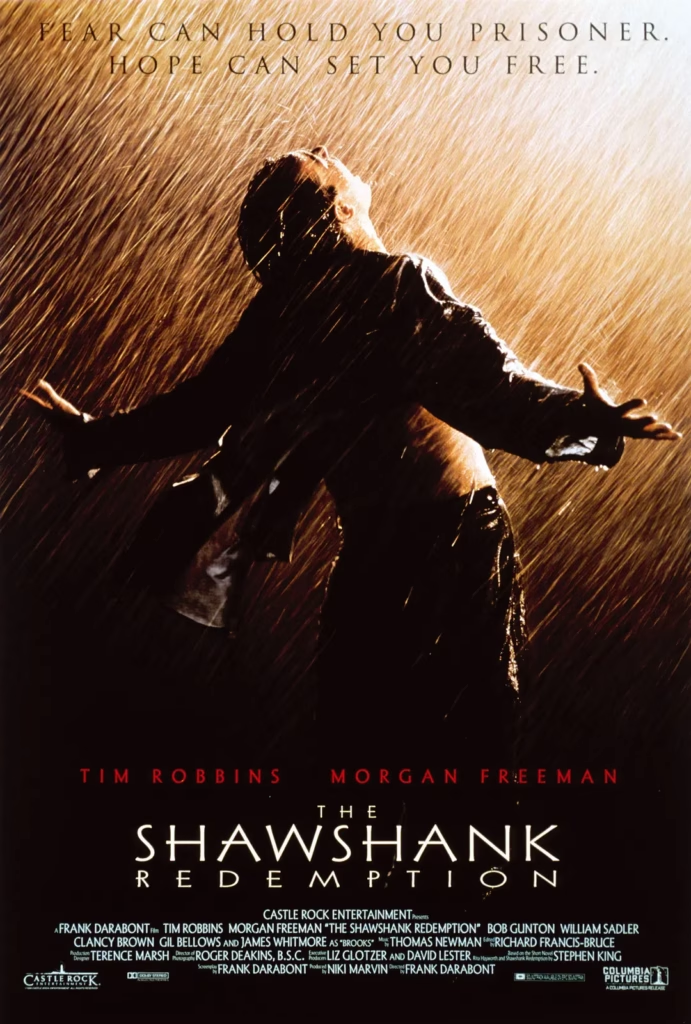
《肖申克的救赎》

肖申克的救赎之前我在电脑上看过,这次重映,我决定到影院去交一张电影票钱,重新回顾一下。好电影不愧是好电影,去电影院看依旧很爽。

而且,真的在看这部电影之后,对于自由和希望的理解,真的是又进一步。
Everything is Harness: 从 Prompt Engineering 到 Context Engineering 再到 Harness Engineering

在 Harness Engineering 这个概念逐渐流行甚至要过气之后,我终于理解了这个词背后的含义。作为一个笨人,决定用费曼学习法,把 Harness Engineering 这个词讲明白,也算是对自己的一个交代。
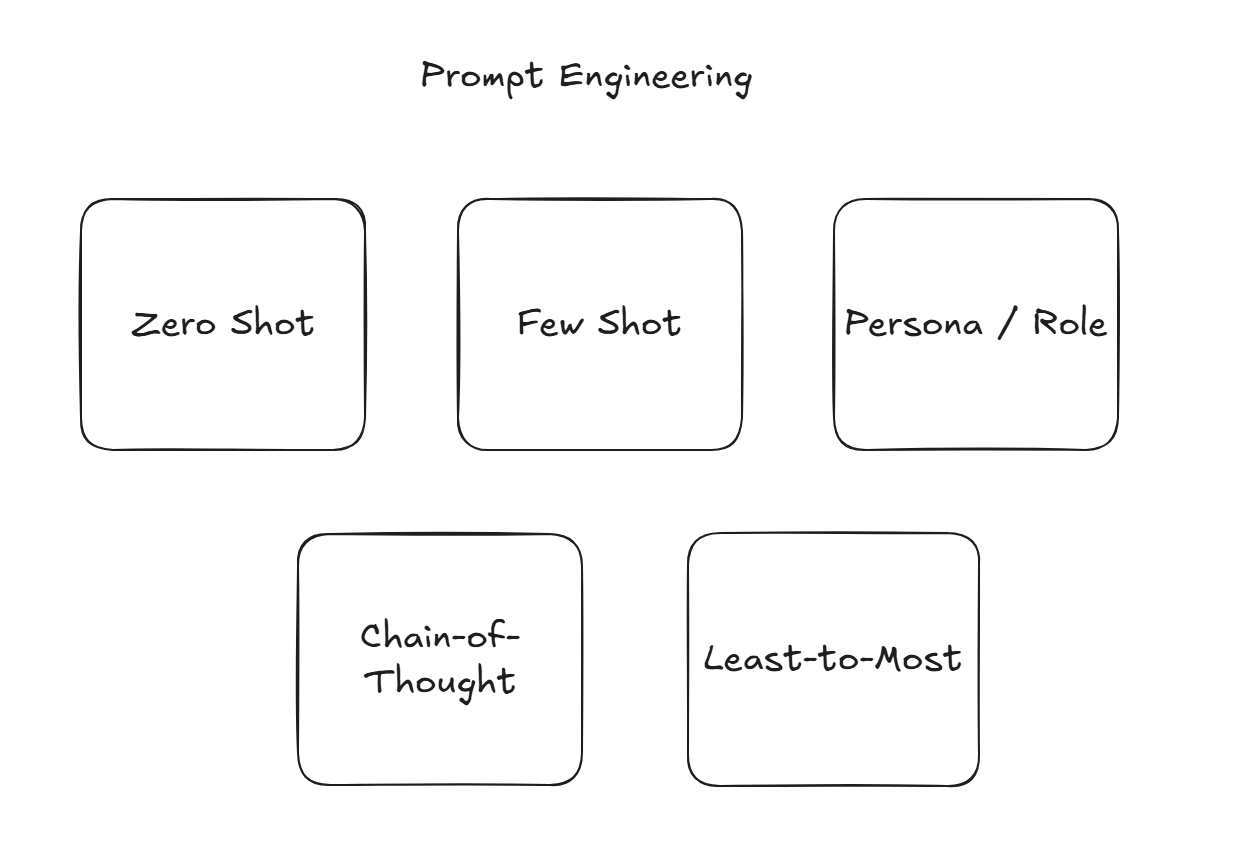
从 Prompt Engineering 说起

在 ChatGPT 刚出来的时候,大家面对一个空白的输入框,不知道说什么好,于是我们看到大量的教程、指南和分享中,大家开始提prompt这个词。而随之而来的,便是 Prompt Engineering。

大家希望通过修改自己的 Prompt,来让模型返回不同的内容,从而达成让模型完成不同的工作任务。在 2023 年的时候,Prompt Engineering 作为一个指引,帮助我们把 Prompt 写的更加结构化、更加明确化,向模型描述我们到底希望看到和使用的内容的框架,指引和帮助很多人走上了 AI 之旅。

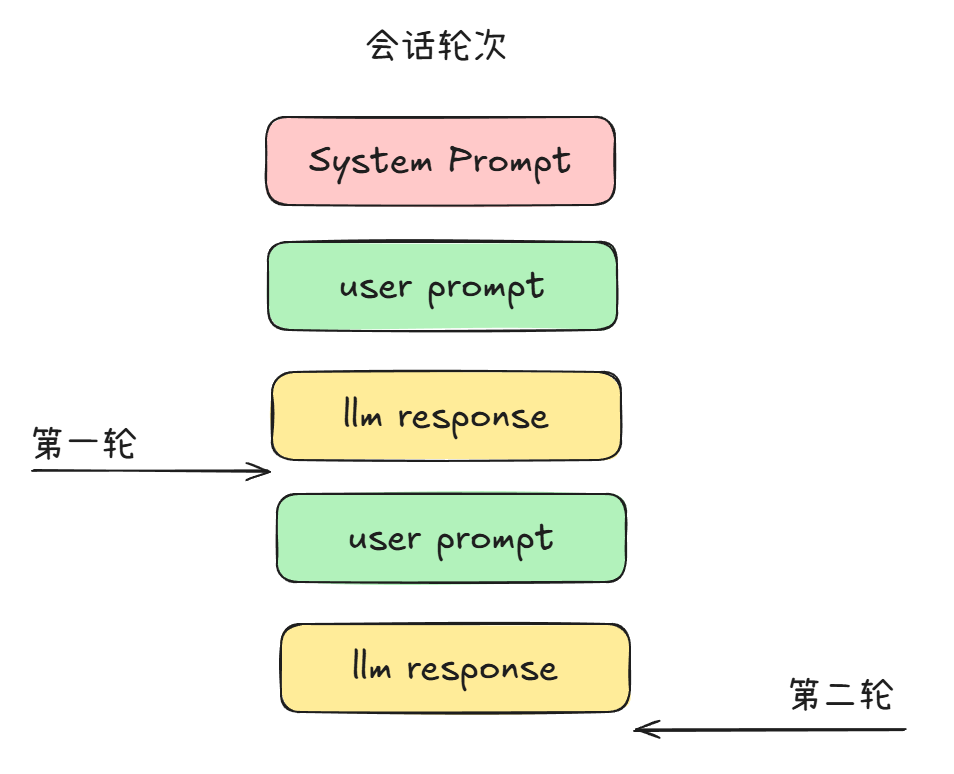
其中的技巧即使在今天,也并非完全失效,在这个阶段,由于应用的形态以 ChatBot 为主,同时 API 主要也是在使用 Chat Completions API 为主,在这个阶段,我们的主要对于上下文的操作就是不断 Append,把用户的输入和模型的输入一起写入到整个会话的 Message。

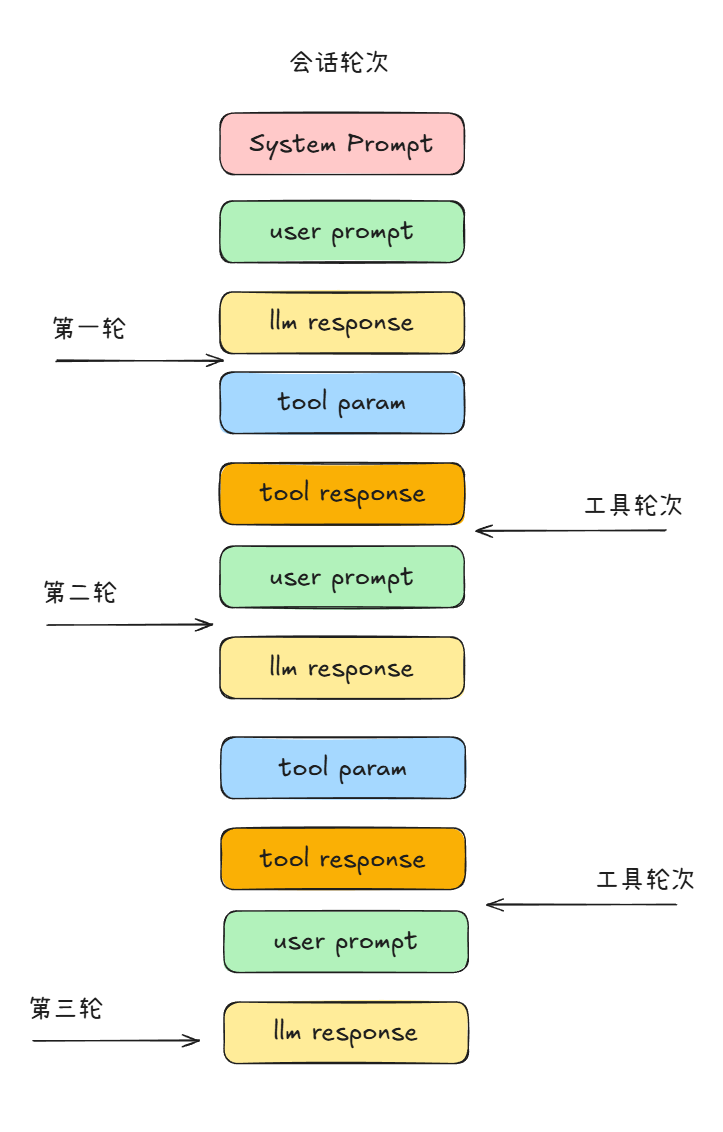
但只有 Chatbot 是无法满足业务的需求的;我们开始研究使用 LLM 来完成更多的工作,并随着 GPT 3.5 Turbo /GPT4 支持 ToolCall ,LLM 开始可以稳定的输出更多的信息,从而延伸出了更多的功能和能力;我们开始在整个会话轮次中塞入更多的东西。Chat Completions API 在返回 Tool 的 Params 的时候,也需要我们将对应的 Tool 的 Response 一并回传给模型,整个会话的轮次也开始越变越长。

而模型的上下文和注意力机制决定了,模型的注意力预算有限;在这种持续的、长轮次的沟通方式累计下,整个上下文会快速累积(tool 的调用结果、system prompt、历史存储的状态、检索的内容都会进入到整个 Messages 序列里)。我们需要做出一些方式的优化,来确保在每次推理时,从不断增长的信息里,挑出最小但信号最强的那一组 token。

而随着 Agent 的概念开始出现,我们开始对 Agent 本身的能力开始做不同的上下文裁剪的方案,来确保 LLM 能够拿到最重要的信息。直到 2025 年中,Context Engineering 的概念被Karpathy、Tobi Lütke 等人提出,随后 Anthropic 发布 《Effective context engineering for AI agents》,我们开始正式用 Context Engineering 的理念来管理我们的 Agent 行为。

从 Context Engineering 到 Harness Engineering

随着 Context Engineering 的实践逐渐成熟,我们开始能够更有效地管理有限的上下文预算,使 Agent 在复杂任务中保持更好的信息相关性和行为一致性(但这并没有彻底解决长程任务中的可靠性问题)。随之而来的是,我们迎来了 Agent 的时代;Claude Code 的横空出世,Claude 3.5 Sonnet 、Claude 4.0 Sonnet、Claude 4.0 Opus 等模型的推出,我们开始发现 Agent 可以很好的完成工作;

我们开始大量的使用这些 Coding Agent 来完成工作;但我们也不只满足于让 Agent 能完成工作,我们开始思考让 Agent 尝试更加长久的工作,完成长程任务。ReAct 等框架帮助我们初步探索了 Agent 长程任务的可能,但整体来说执行还是非常的不稳定的,依然需要人类介入其中,承担一些中间的粘合、持续推进的动力。

但很显然,我们不希望人类担任这个无价值的 Connector,与此同时,Anthropic 在长程 Agent 实践中展示了一种 Harness 设计方案《Effective harnesses for long-running agents》。不过这一版的 Harness 的定义和我们如今看到的 Harness 定义还是有很多变化的,它还定义了特定的 Feature List。如今我们用的 Claude Code 则是用了 Dynamic workflows 来完成了相同但更强的功能。

2026 年 2 月 5 日,HashiCorp 的 Co-Founder Mitchell Hashimoto 写下了 《My AI Adoption Journey》,在个人实践中明确使用并阐述这一概念,并定义了两种可能的形式:改进 AGENTS.md 和 改进编程工具。

I’m making an earnest effort whenever I see an agent do a Bad Thing to prevent it from ever doing that bad thing again. Or, conversely, I’m making an earnest effort for agents to be able to verify they’re doing a Good Thing.

Mitchell Hashimoto

紧随其后,OpenAI 在 2 月 11 日发布了他们自己的 《Harness engineering: leveraging Codex in an agent-first world》的文章,在这篇文章里, OpenAI 没有定义 Harness Engineering 是什么,但给出了不少他们做的修改的范式,并给出了他们认为重要的部分: 识别缺失的部分,并让 Agent 编写相关的部分。

Humans always remain in the loop, but work at a different layer of abstraction than we used to. We prioritize work, translate user feedback into acceptance criteria, and validate outcomes. When the agent struggles, we treat it as a signal: identify what is missing—tools, guardrails, documentation—and feed it back into the repository, always by having Codex itself write the fix.

Ryan Lopopolo, Member of the Technical Staff of OpenAI

至此,Harness Engineering 的画像变得清晰:不是改进模型本身,而是改进围绕模型的一切环境、产物和工具,通过这些环境和产物以及工具,来让模型正确的工作。

所以,到底什么是 Harness?

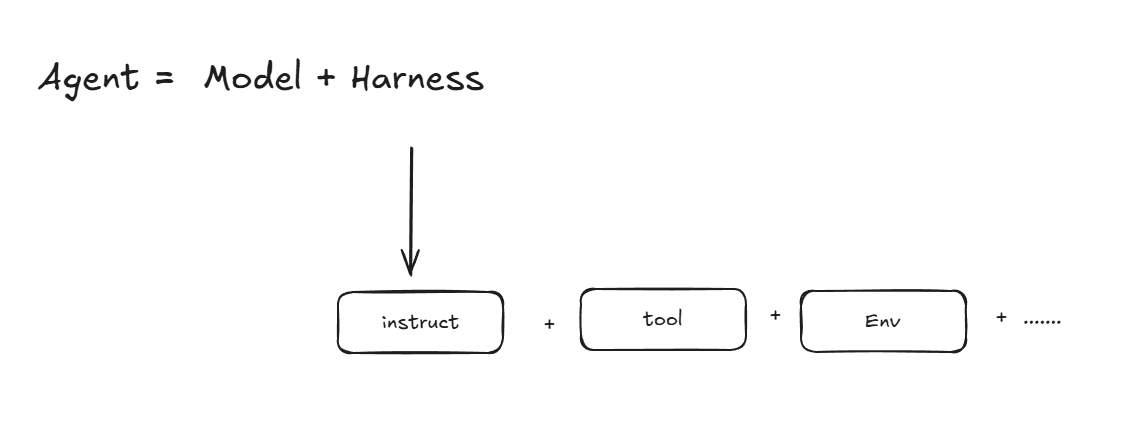
我们可以简单的将 Agent 的拆解为 Model + Harness,所有不在 Model 的部分,都在 Harness。当然,这不是严格的系统架构定义,而是一种工程视角上的简化:在模型权重不变的前提下,我们能够主动设计和优化的执行机制、上下文管理、工具调用、状态管理与验证反馈,可以统称为 Harness 的一部分。但这句话的关键不在于拆解方式,而在于解决问题的思路 —— 将目光从改进模型切换为改进 Harness。

0KhQLXTs3H.png

这就好像我们试图让一个人去计算一个很难的题目,由于替换人的难度很大,成本很高,所以我们选择将目光转移到人可以用的工具上。我们可以用算盘去计算一个复杂的题目,但如果我同样还可以使用一个强大的计算器,那自然使用计算器可以更快的到达目的地。而好的工具(Harness),也给了我们让一个更差的模型获得更好的质量的可能。好的模型可以向下兼容算盘,但给它计算器,它才能把精力省下来做更难的部分。

当然,更强的模型往往能够驾驭更复杂的工具,完成更加困难的任务。但 Harness Engineering 的意义,不只是进一步提高模型的能力表现,而是降低任务成功对模型单次推理和执行正确性的依赖。

通过外部工具、状态管理、验证反馈与错误恢复,我们可以把原本需要模型独立完成的部分工作交给工程系统,让同一个模型更加稳定地完成任务。

Harness Engineering 的目标,是将模型具有不确定性的推理与执行能力,转化为可验证、可恢复、可持续的任务交付能力,提高任务的端到端成功率。

1GX9IttMon.png

举个例子,假设我们希望一个 Coding Agent 完成一次代码重构。它不仅需要修改代码,还需要确保修改没有破坏现有功能。

  • 如果没有 Harness,我们只能期待模型记得运行测试、正确理解测试结果,并在失败时尝试修复。
  • 但如果我们将编译检查、单元测试、端到端测试和任务状态管理接入 Harness,那么即使模型某次修改出错,系统仍然能够发现问题、提供反馈,并引导 Agent 继续修复。

这并没有改变模型本身的能力,却改变了整个系统完成任务的可靠性,帮助整个系统更加准确的交付结果。

所以,为什么模型公司要搞自己的 Harness?

很显然,Harness 存在的目标是帮助模型获得更好的结果。各个模型公司在训练环境的差异,会使得模型公司倾向于通过优化 Harness 来帮助自己获得更好的结果和智能。这也是为什么你会关注到,很多模型的 Benchmark 必须说清楚用的是什么 Harness 得到了这个分数,因为 Harness 就是会影响最终模型的结果。

而不同的模型公司在设计哲学上的变化最终演变出来了不同的 Harness,也让我们看到了不同的分类 —— Claude Code、Codex 、Pi、Deepseek Harness 。每个 Harness 背后都是对应模型公司或应用公司对于 Agent 的重新理解和定义。而对于这件事的理解,让我对于 Harness 的生态位既感到乐观,也感到悲观。

我们如何选择自己的身位?

毫无疑问,我们可以将 Harness 区分为 Base Harness 和 Domain Harness / Business Harness:Base Harness 代表模型公司基于 Agent 能力抽象出来的最小集合;而 Domain Harness 是将特定领域的知识、工具、业务流程和验收标准封装成 Agent 可执行、可验证的工程系统。

我对 Base Harness 的生态位悲观,因为对于模型公司来说,他们会优先适配自己的 Base Harness,来帮助自己以最低成本获得最好的效果,同时,也会分配一部分精力去适配社区使用比较多的 Harness。但另一方面,这种和模型的深度绑定,让 开源的 Base Harness 会在持续发展的阶段中,逐步被抛下(除非你能成为 The One)。这让我们在选择 Base Harness 时要谨慎。

目前来看, Pi 可能会好一点,因为足够简单,和本身设计理念的简单,会让他大概率就算靠模型泛化,不做特定的优化,也能获得不错的结果。其他缺少独特系统能力、只追求复制官方 Agent 产品体验的通用 Harness,长期竞争空间可能被压缩;而和模型厂商绑定的 Harness,则会逐步在自己的 Harness 上拥有最佳表现,顶多再适配一下 Codex / Claude Code。如果一个第三方的 Harness 不够薄、不够可替换,就容易被模型厂商的官方 harness 挤压,最终失去自己的价值(回想我们之前看到的复杂的 Garry Tan 的 Gstack,你还用么?)

同时,我也对 Domain Harness 更加乐观,因为领域知识实在是太深太杂,以至于对于模型公司来说,这些东西可能也会吃下巨大的人力成本。与其花时间去做 Domain Harness,倒不如直接提供更好的开放度(比如 Pi / Deepseek Harness),来帮助领域专家构建 Domain Harness(从这个视角来看,我能理解 Deepseek Harness 的设计理念为何如此激进)。不过这些机会可能并不属于我(虽然我是 EE 背景的人, 但我的领域 Know How 约等于没有,自己的技能都点在互联网 & CS 相关了)。

在这样的生态格局下,我们如何做好 Domain Harness?

当你理解 Harness 的存在价值和设计理念后,接下来就可以动手设计你的 Domain Harness 了,

  1. 定义你要解决的问题,设计任务集和验收条件:定义领域的真问题和对应的成功标准、验收条件,用于判断 Agent 的行为。
  2. 选择一个你喜欢 / 熟悉 / 定制方便的 Base Harness,这方面我推荐你看看 Pi 或者 Deepseek Harness, Codex 虽然本身和 GPT 强绑定,但因为 Open Core,你也可以快速找到他的 Base Harness 实现,然后基于此做自己的实现和改造,只是从开放度来讲,前两者还是更好。
  3. 让 Agent 去尝试完成任务,并在失败的时候停下来分析 Trajectory,在这一步,你要先分析 Agent 的失败原因,到底是缺乏验证机制,导致无法判断对错最终做错了?还是缺乏外部状态,导致模型在长程任务中迷失了自我。
    1. 如果是缺乏验证机制,那么你需要给到 Agent 一个能够验证对错的方案(可能是一个验证脚本,也可能是一个 Linter),并要求 Agent 看验证的结果再继续推进;并查看 Agent 的行为是否符合预期。
    2. 如果是缺乏外部状态,那么你需要定义在长程任务中必须要完成的工作,让 Agent 可以自己去跟进状态,并在持续进行长程任务过程中,不会丢失自己的位置(我们看到的 Claude Code 第一版的 Todolist 和后续的 Dynamic workflows都是类似的作用)。
    3. 如果这两个都不是关键问题,纯粹是 Agent缺乏信息或者外部信息的输入,那么你才需要设计新的工具和引入更多的内容作为 Prompt 来帮助 Agent 获得足够的上下文。
  4. 至于修改 Prompt 文件,虽是成本最低,最直接的优化手段,但却不应该成为我们的默认选项。
  5. 当你完成所有的修改后,重新跑一次回归测评,对比成功率、成本、耗时与副作用,来促进下一次优化。

总结

过去,我们花费大量的精力研究如何写出更好的 Prompt,让模型尽可能一次性给出正确的答案。

后来,我们开始研究 Context Engineering,让模型在合适的时间看到合适的信息。

而今天,我们开始研究 Harness Engineering,不再只关注模型在某一次推理中是否正确,而是关注整个系统能否持续、稳定、可验证地完成任务。

从这个角度来看,Harness Engineering 的价值,不是让模型永远不犯错,而是让系统有能力发现错误、修复错误,并从错误中持续改进。

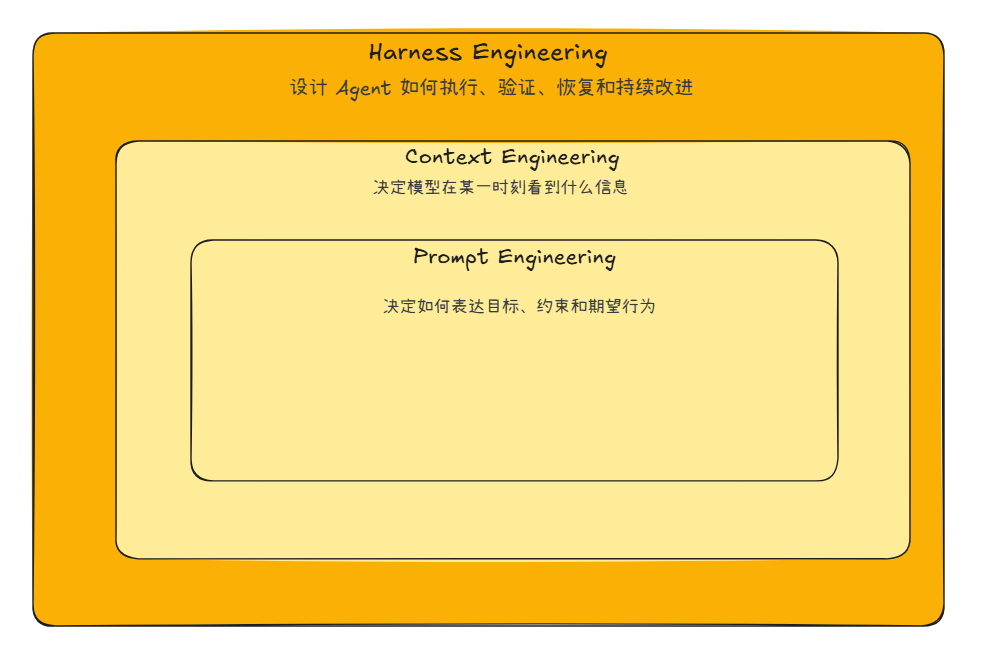
Prompt Engineering 优化的是表达,Context Engineering 优化的是信息,而 Harness Engineering 优化的是完成任务的整个过程。

当模型能力不断提高,我们真正需要积累的,可能不再是某个版本的 Prompt,也不是某个 Agent Framework 的使用技巧,而是那些能够被验证、执行和持续改进的工程经验与业务判断。

模型会不断迭代,Harness 也会不断演进。但如何定义正确、如何验证结果、如何把经验沉淀为可以复用的系统,依然是值得长期投入的事情。

我们正在从教模型如何做事,转向设计一个让模型能够把事情做对的系统。

我把 Apple Watch 半退役了:Google Fitbit Air 可能是最适合 AI 用户的可穿戴设备

我把 Apple Watch 半退役了,身体记录的主力换成了 Fitbit Air。

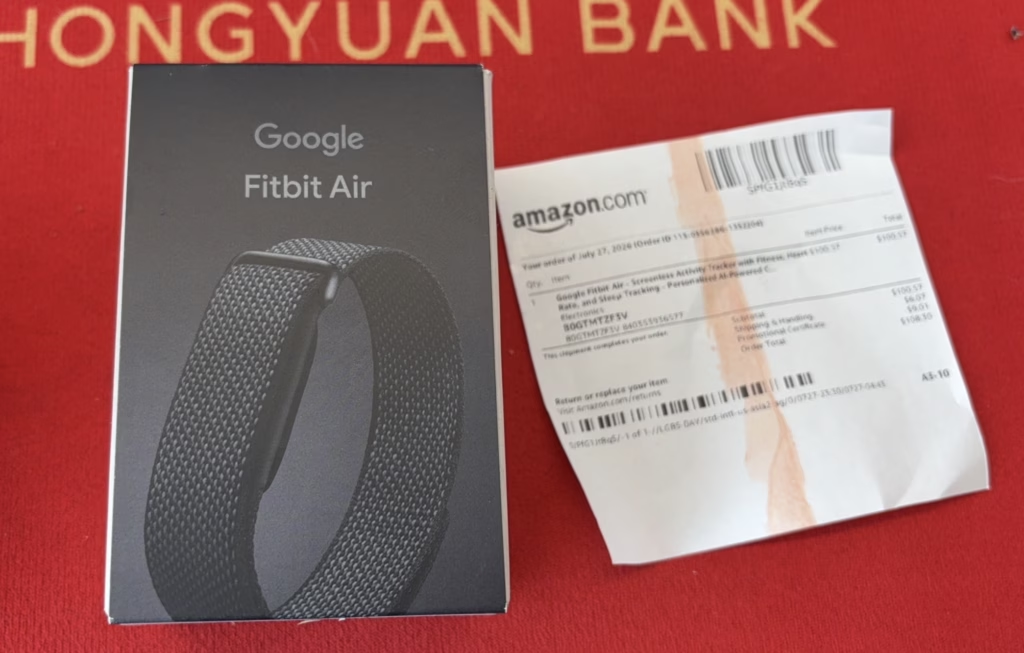
2026 年 8 月 4 日收货;
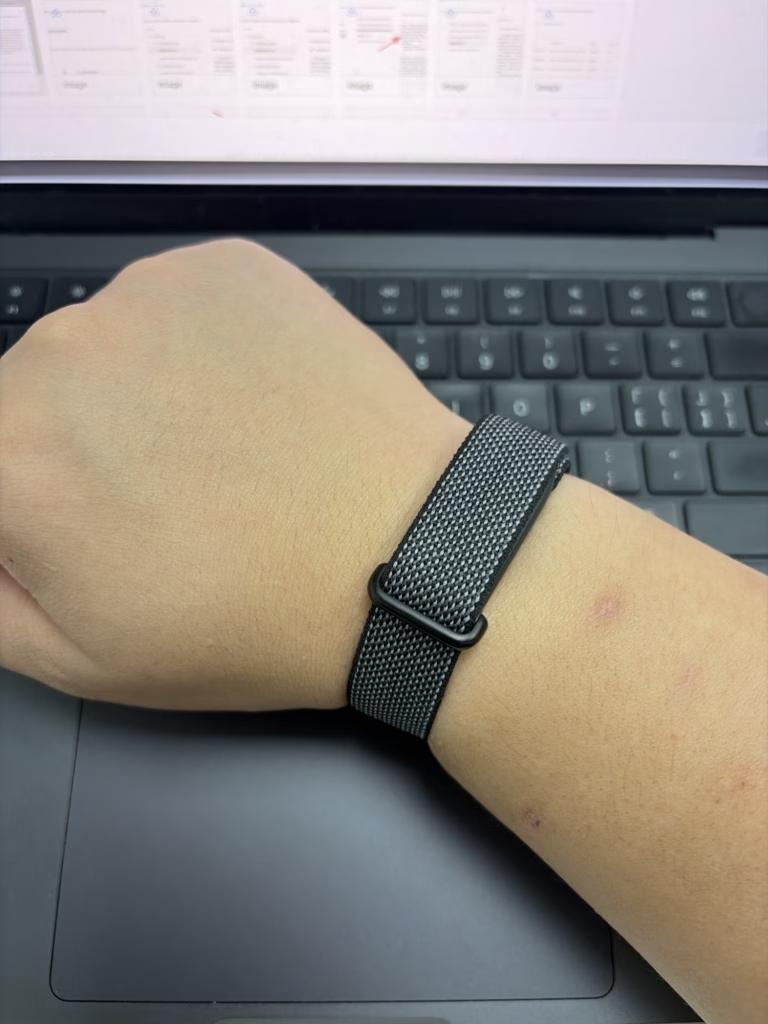
2026 年 10 月 9 日佩戴效果。

什么是 Google Fitbit Air

Google Fitbit Air 是 Google 在收购了 Fitbit 之后,推出的一款无屏手环设备(对标 Whoop),其核心设计理念是在设备上彻底移除数据查看的能力,专注在数据追踪和全天候检测上。

得益于这样的设计思路,Fitbit Air 可以减少手环的最大热源和耗电源 ——屏幕;同时,还可以把整个设备做得更加轻薄,省电,官方标称最长 7 天,我实际大概 8 天。如果你对于 Apple Watch 的每日一充实在顶不住了,那么 Fitbit Air 就是你的最优选。

既然目标是用来做全天候健康检测,Fitbit Air 也集成了不少的传感器,可以满足你的日常需求,具体包含:

  • 光学心率监测器(Optical heart rate monitor)
  • 三轴加速度计 + 陀螺仪(3-axis accelerometer + gyroscope)
  • 用于血氧饱和度 (SpO2) 监测的红光及红外线传感器(Red and infrared sensors for oxygen saturation (SpO2) monitoring)
  • 设备温度传感器(皮肤温度变化可在 Google Health 应用中查看)(Device temperature sensor (skin temperature variation available in the Google Health app))
  • 振动马达(Vibration motor)

对于日常基础监控已足够,大部分时候我们使用 Apple Watch 所监控的基础健康指标也大概是这些了。

详细的技术 Spec 可以查看 https://store.google.com/product/google_fitbit_air_specs?hl=en-US

而且其售价也不算特别贵,相比于小米手环要贵一些(原价 99 美元;亚马逊买大概是 700 元人民币不到),但作为一个含智能属性的装饰品而言,我觉得还是可以接受的。

将 Google Fitbit Air 与 AI Agents 整合起来使用

促使我购入 Google Fitbit Air 的核心原因,是我对于让 AI Agent 参与到我的个人健康数据分析,指引我进一步优化自己的身体健康状态有很强的诉求。

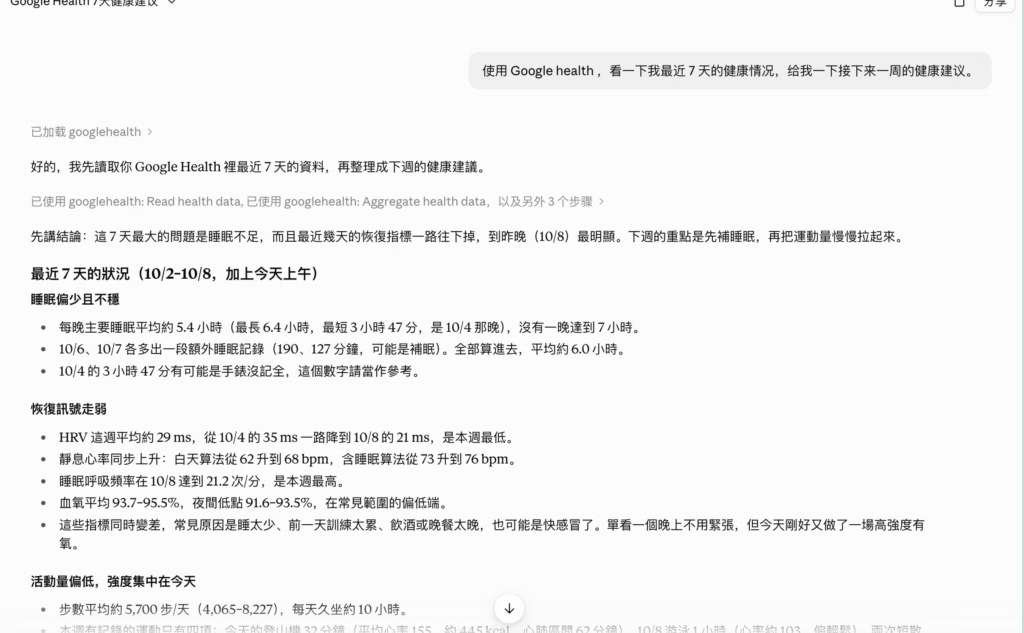
但目前我在用的产品不管是 Apple Watch 还是 Garmin,这方面做的都不够好,我没办法比较随意的将它们接入到 Claude / Grok 等不同的应用,这使得我非常不爽;我已经买了更好的模型,但受限于开放度,没办法把这些数据提供给 AI Agent 帮助我自己提升表现。而 Google Fitbit Air 在买之前,我就了解到它是基于 Google Health 的。而 Google Health 是给用户提供了开放的 Google Health API 的。

这就给了我更进一步分析自己的各种数据的可能性,不管是将其封装成 MCP 给到 AI Agent 使用,还是我把数据拉下来做其他分析,都有了机会。从这个视角来看,我还有个暴论: Google Fitbit Air 可能是迄今为止,最适合 AI User 的可穿戴智能设备。

在 Claude 中使用 Stille Warm 来读取数据。

如果你要购买,且有兴趣把 Fitbit Air 和你的 AI Agent 整合起来,我写了一个开源的程序,可以帮助你把 Google Health API 封装成 MCP 来使用:https://github.com/bestony/google-health-connector 。如果你对这些数据有隐私顾虑,可以直接自己部署一个;如果你懒得自己部署,也可以选择使用我部署好的线上服务:https://www.stillwarm.app/

为什么说 Google Fitbit Air 是一个伪装成装饰品的健康追踪设备

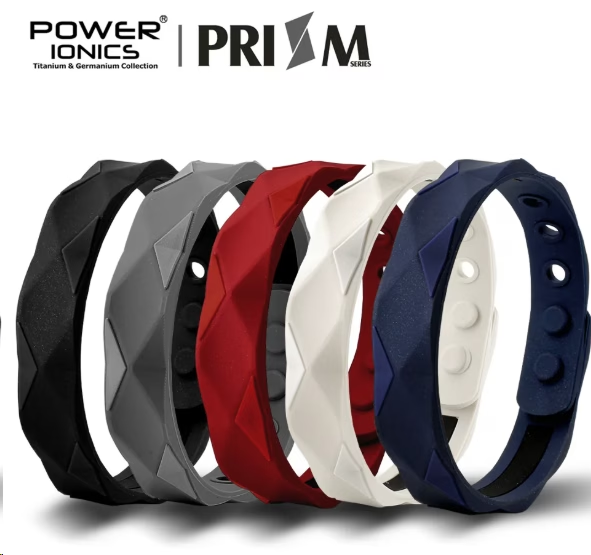
得益于无屏幕的设计,使得 Fitbit Air 更加接近于一个装饰品,你几乎可以把它当成下面这样的硅胶手环来戴(当然,你戴的表带不同决定了实际的体感),如果你能够接受这样的硅胶手环,那么你大概率能接受 Google Fitbit Air。毕竟,Fitbit Air 主机 5.2 克,连上表带也只有 12 克,真的没什么感觉。

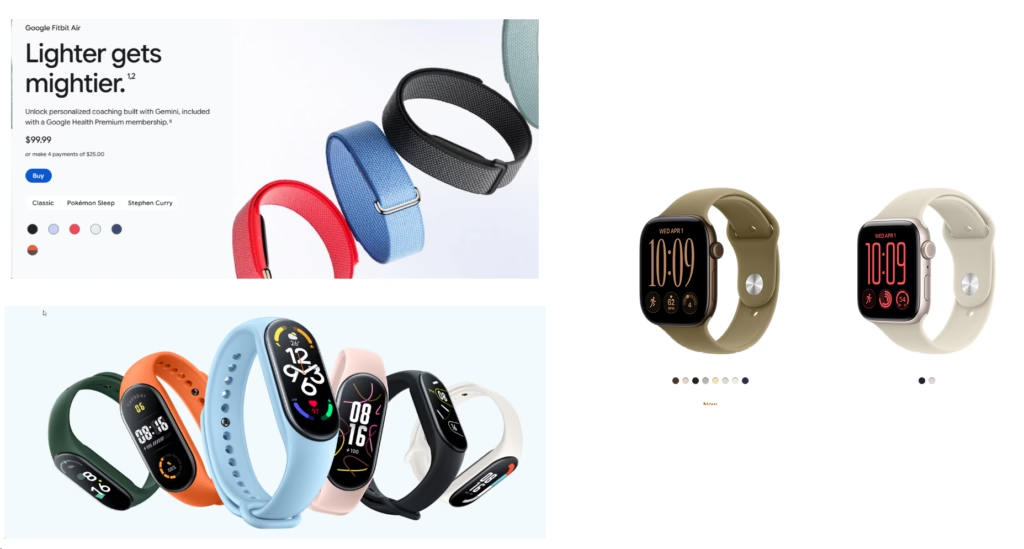
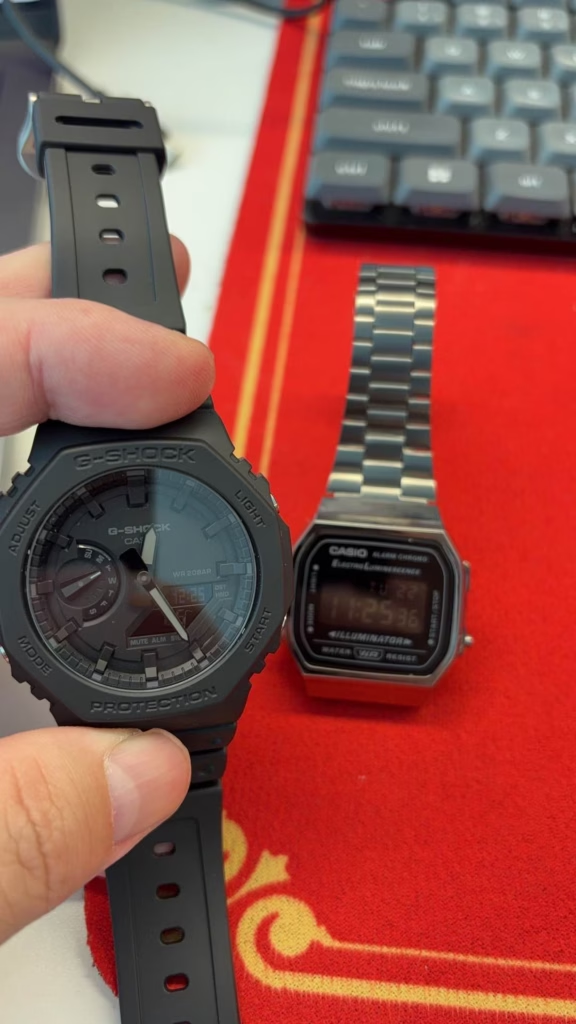
为什么这个无屏幕如此重要?因为无屏幕为用户提供了一种可能性:用极低的侵入感,提供装饰作用,从而让你可以一直戴着它。不管是我们更熟悉的小米手环,还是各种智能手表,你不可避免会遇到的问题是 —— 你的手腕上总是有一截「黑色」,即使是小米手环这样很细的,依然是有一截黑色。如果你还没感觉的话,下面这张图,可能会让你更有对比感;它们从左到右分别是 Fitbit Air、小米手环 7 、Apple Watch S12;

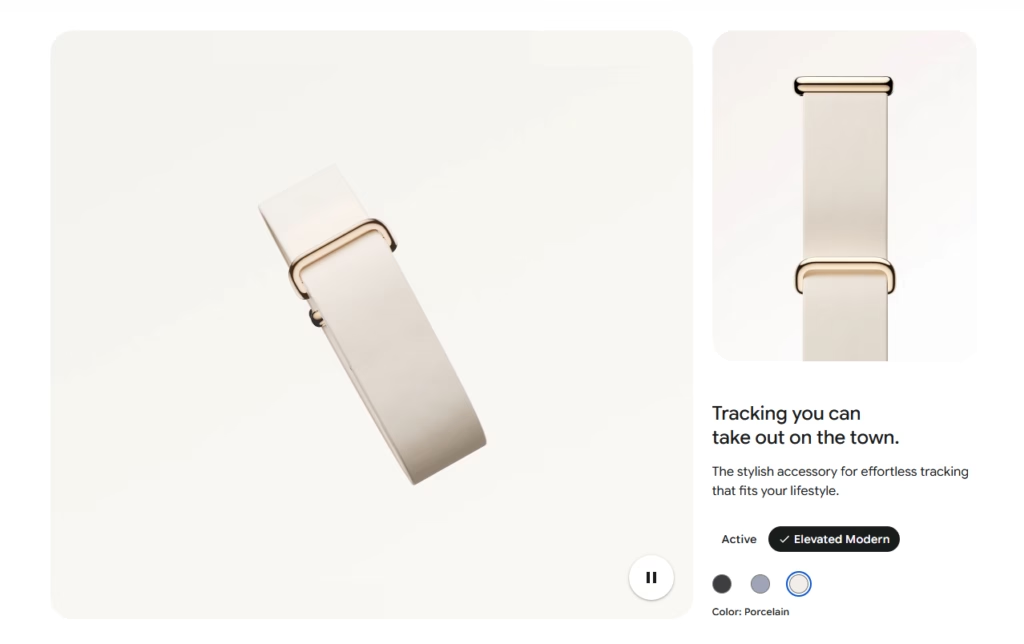
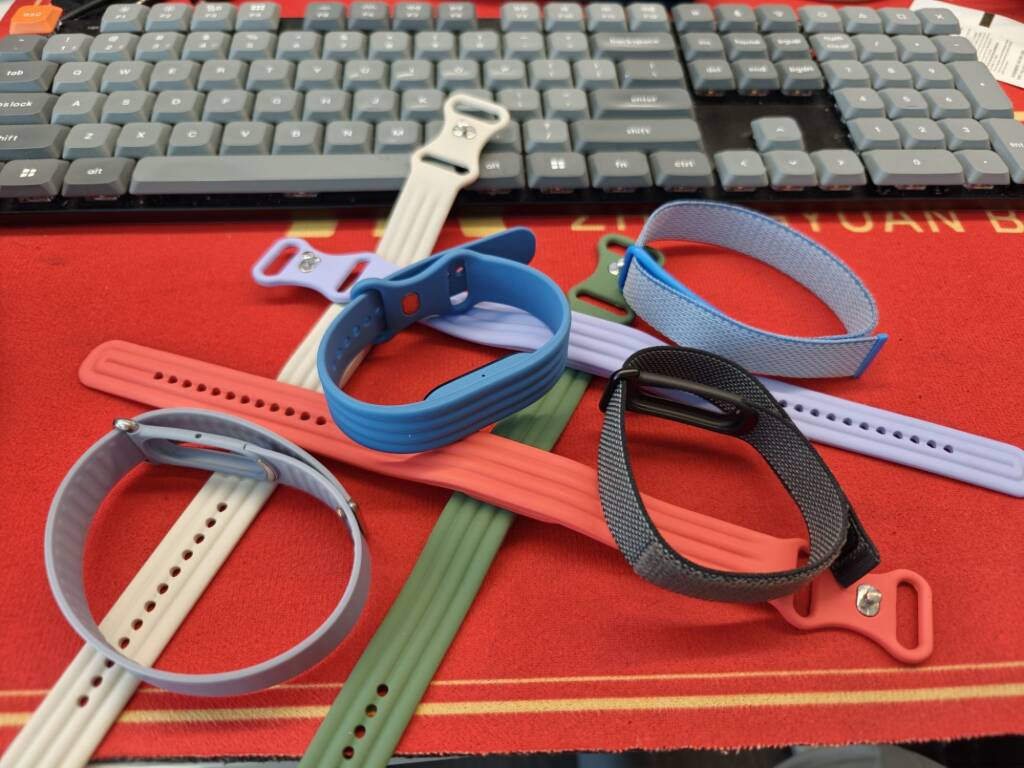
而也因为这种装饰品的属性,让我开始尝试一些更大胆的风格 ——我买了非常多不同的表带,可以根据场景、喜好、穿搭替换不同颜色的表带,来搭配自己的穿衣风格;

我拥有的各色各样的表带

你可以在淘宝上找到各式各样、不同风格和颜色的表带,根据自己的喜好,把它搭配成你自己的风格。而得益于 Google Fitbit Air 以饰品的形态完成了身体指标的追踪,我开始买一些其他的腕表来配合着戴。

Google Fitbit Air 的数字体验 —— Google Health App

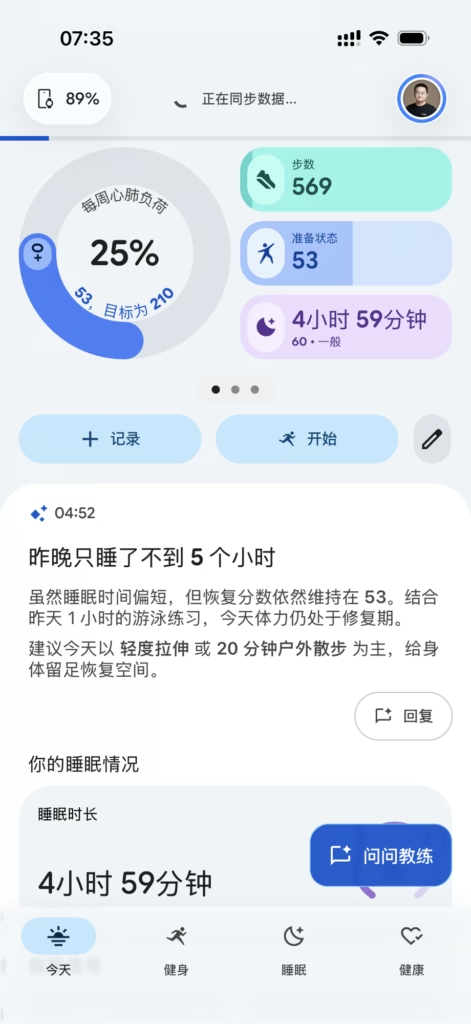
Google Fitbit Air 使用的是 Google Health App,需要单独下载,整个 App 设计的很简约,功能不多,从打开体验上来看,可能比 Apple Health 还好一点点。

在打开的那一刻,你可以快速看到一些你的基础信息,并可以根据这些基础信息来微调自己的规划。在这个界面中,最核心的是左上角的心肺负荷;Google Health 的基础假设是预期你能不断提升自己的心肺负荷,提升心肺能力;所以随着你使用的越久,它就会给你更加完整的心肺负荷的数据,同时帮你动态调整每周的目标。跟着这个目标,你会慢慢提升自己的心肺能力。

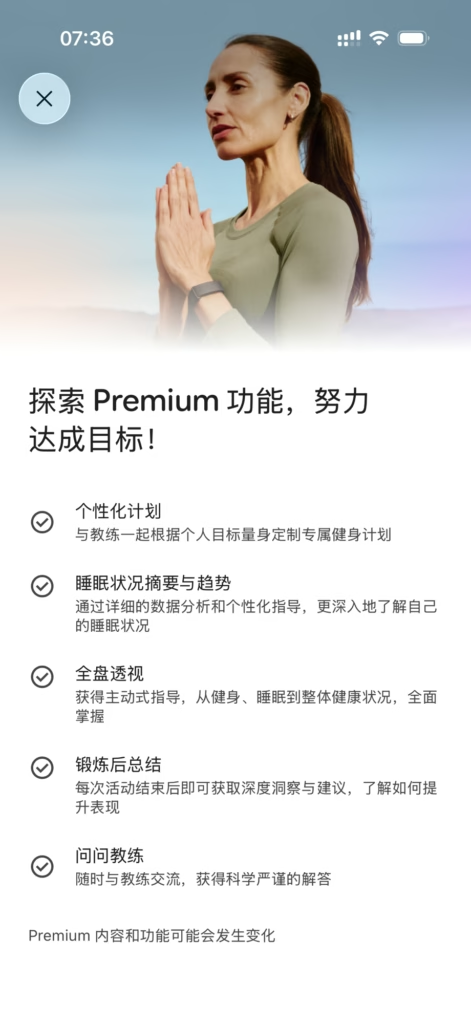
你如果是新买的 Fitbit Air,Google 官方还会给你送免费 3 个月的 Google Health Premium 会员(新用户和回归用户都算,活动截止到 2027-05-26。试用结束后自动按 $9.99/月续费),从而可以在 Google Health 中直接使用 AI 助手。而如果你已经购买了 Google 的 AI Pro 以上的会员,那你的 AI Pro 就包含了 Google Health 的 Premium 会员,可以畅快用 AI Agent 了;

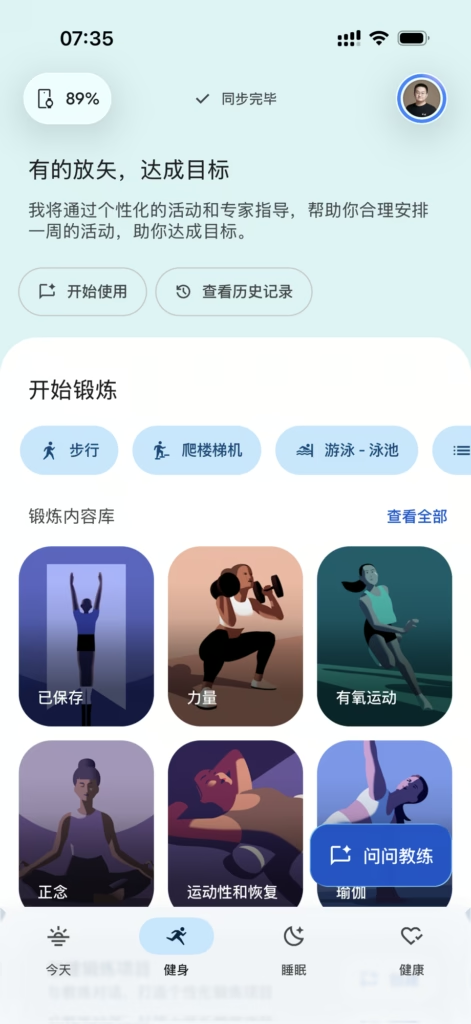
除了基础的数据指标和 AI 助手,Google Health App 里还有类似 Keep 的运动库,你可以直接跟着练习;不过我有自己的训练计划,这部分用的很少;

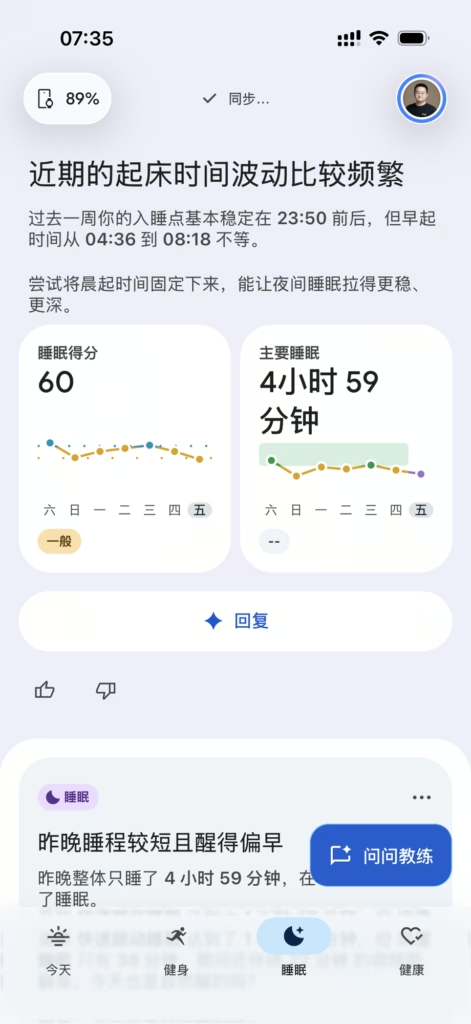
在整个健康检测过程中,睡眠是一个很重要的指标,因此,Google Health 也给睡眠提供了一个单独的 Tab 方便你查看睡眠情况的分析。

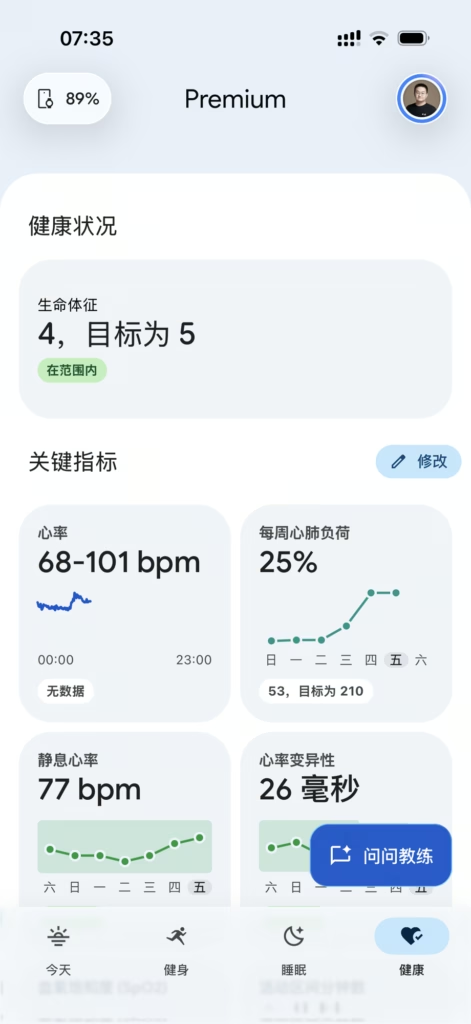
以及独立的健康状态页面,记录你的身体的各项指标;你可以在这里去查看你的各项指标的趋势;

一些很有用的 Google Fitbit Air 的小功能

  • Google Fitbit Air 支持配置闹钟和智能唤醒,依靠腕间震动,来把用户给震醒。很适合有同床人,但只希望叫醒自己的人。
  • 高度可定制化的首页:虽然官方推荐你把心肺负荷放在首页,但你可以根据需要,把自己关注的生命体征调整到前面。这比 Apple Health / Garmin Connect 好太多了。

Google Fitbit Air 不适合什么场景?

上面说了很多适合的,接下来还要说一些不适合的人群

  1. 你有记录运动的习惯,但没有另外一个设备:Google Fitbit Air 不是不能记录运动,但它的记录功能和实时提醒的功能相对较弱,毕竟没有屏幕,所以各项指标你都只能在手机上查看;
  2. 你需要一个手表来看时间并完成记录:这种场景下,Apple Watch、小米手环之类的带屏设备还是更适合你。
  3. 你并不信任Google:毕竟 Google 的主要盈利模式是广告,那么你的数据从某种意义上,也可能会参与到针对你的广告推广当中去。

Google Fitbit Air 用下来让我不爽的点

  • Google Fitbit Air 的数据同步不太及时。数据不会丢,设备本身能存 7 天的分钟级运动数据,只是会晚一点才到 Google Health。
  • 如果你用 AI Agent 的定时任务分析身体指标,就要留意时间:定时任务排得早,起床后最好先打开一下 App,让手环把数据同步上去,不然 Agent 分析的时候可能拿不到昨晚的数据;定时任务排得晚,基本不用管。

总结

我觉得今天的 Google Fitbit Air,是以一个饰品的姿态,做了一台合格的健康追踪器。它轻、续航长、戴着没负担,最关键的是数据开放,可以直接交给 AI Agent 去分析。

如果你和我一样,想让 AI 参与管理自己的身体,又受够了每天充电,它值得一试。

Claude Tag 产品分析

Claude Tag 这个产品市面上的仿品很多,但我看到的绝大多数的产品仿品仿其型而未有仿其神。这背后是本身绝大多数仿品的团队都是 TO C 创业者出身,导致对于他们来说,并未看出背后的很多设计的原因。而作为一个真的干过 TO B 的产品经理,我觉得大家其实做的都还是 TO C 的产品,由于实在看不过眼(觉得在座的都是垃圾),我决定自己写一篇对于 Claude Tag 的拆解,方便大家参考和使用。

对于 Claude Tag 来说,其神在于:

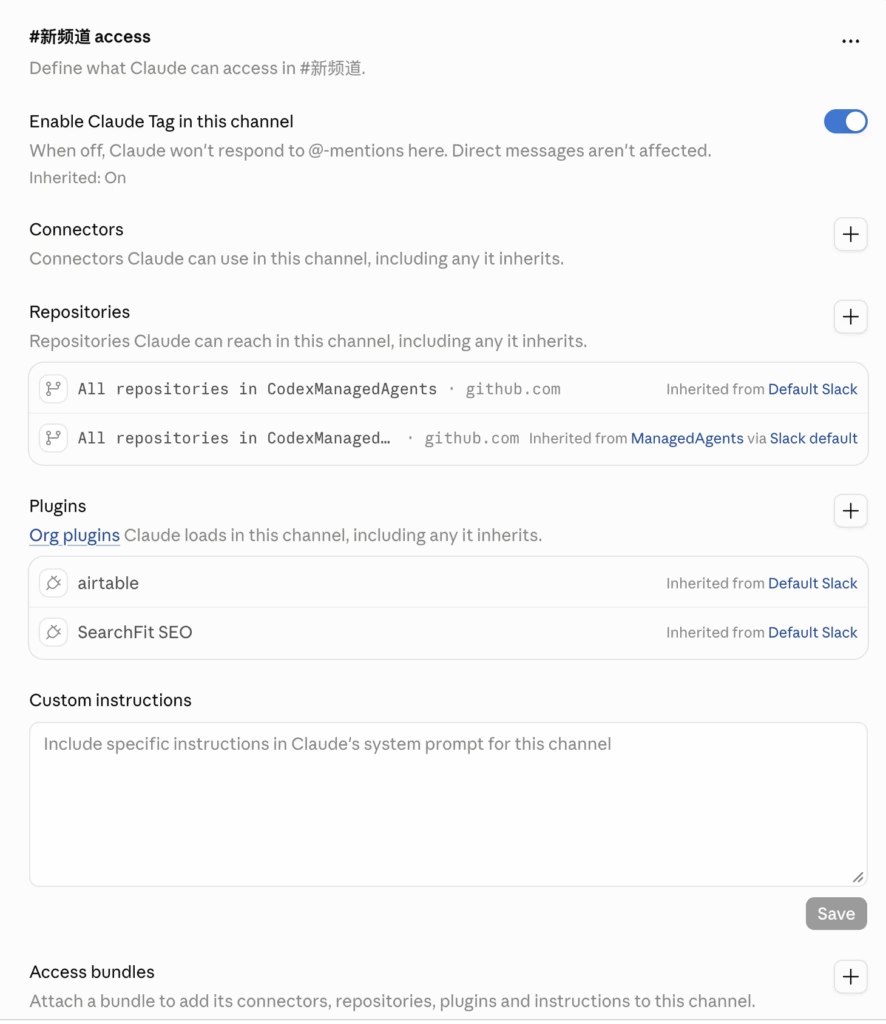
  1. 访问按地方配,不按人配。 配置的单位是 scope——整个组织(Default Slack access)、一个 Workspace、一个 Channel——Access Bundle 挂在 scope 上,往下继承;一个 Channel 拿到的是它自己、它的 Workspace、组织三层 Bundle 的并集
  2. 记忆跟地方走,不跟人走。 Memory 只有两层:Public Channel 里产生的记忆在整个 Workspace 内共享,Private Channel 只读共享层、写自己那一份;
  3. 用组合来在不同地方配置 Agent。你可以通过组合 Access Bundle, 在不同的位置,给 Agent 组合出各种用法的能力,从而让 Agent 真正解决问题。

如何开通 Claude Tag

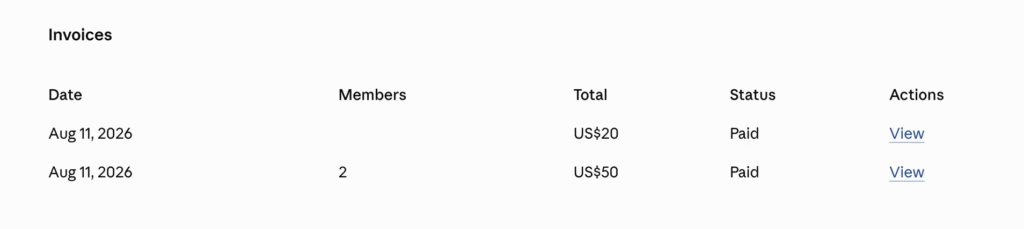
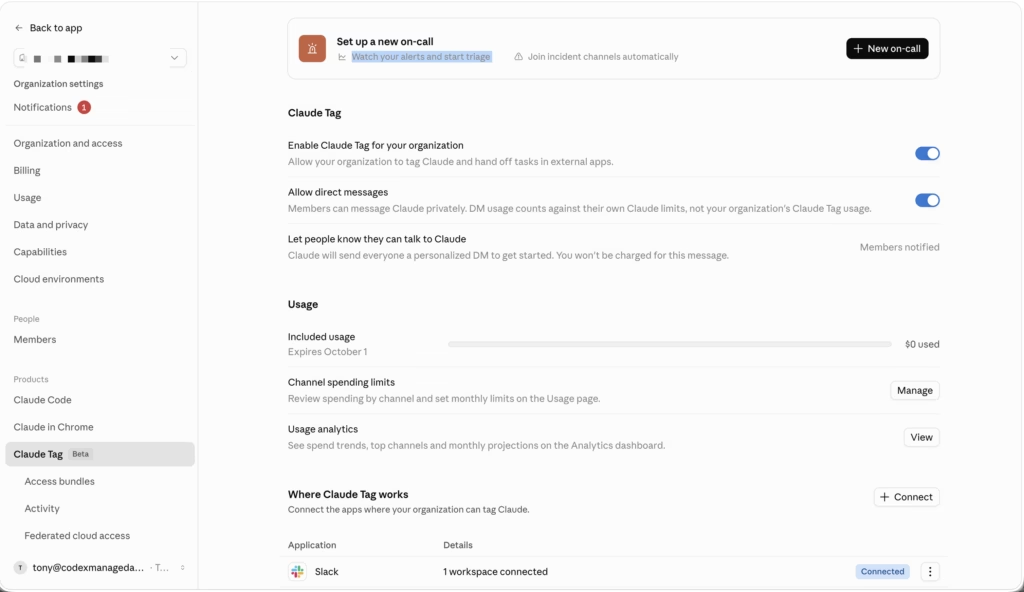
花钱就行,50 刀起步;我花了 70 刀;50 刀是用来开 Claude Teams 权限;剩下 20 刀是 Claude Tag 日常消耗的(我觉得对于很多小公司来说,Claude Tag 的一大痛点可能在于成本太高,因为不是按照订阅算的 Token,而是按照真实的消耗算的 Token,那你可能真的得思考,我真的有必要上 Claude Tag 么?以及会考虑选择使用更便宜的 Sonnet 模型作为 Claude Tag 的主模型)。

Claude Tag 怎么使用

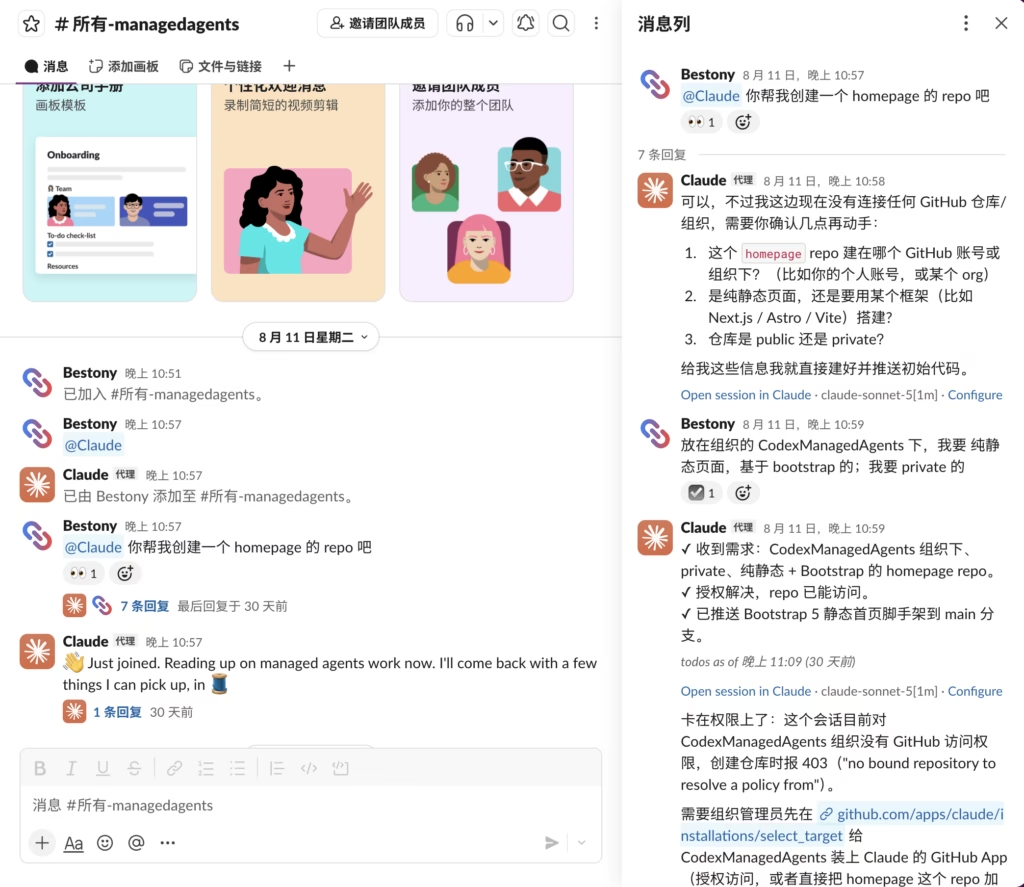
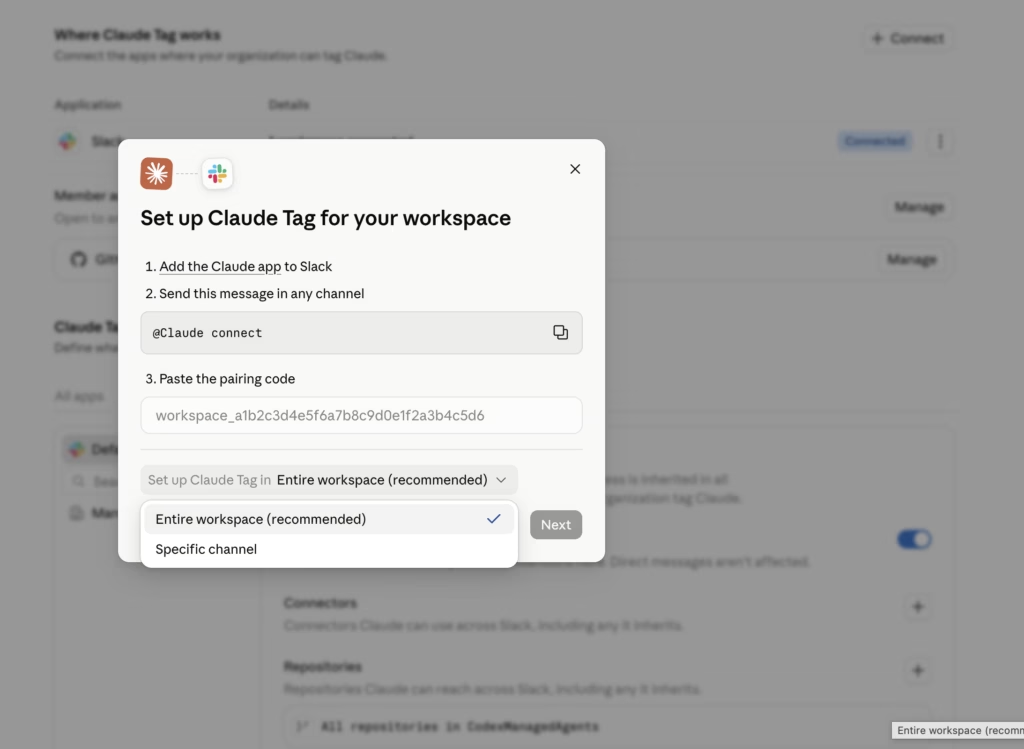
比较简单粗暴,当你完成 Claude Tag 连接之后,接下来直接 at Claude 做事就行;过程中可能会涉及到你要去做一些前置授权等。

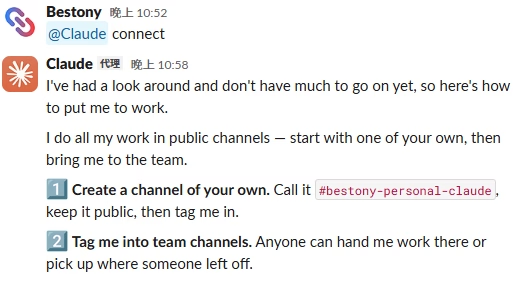
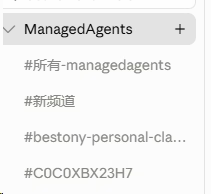
但需要注意的是,目前 Claude Tag 的所有使用必须放在 Channel 中进行;私聊是无法使用 Claude Tag 的,它只能在 Channel 中使用,你需要把它放在任何一个 Channel 中使用;不过好在是,我测试了,其实你可以在 Private Channel 中使用 Claude Tag。所以你依然可以和他一起工作。只是 Private Channel 会在管理后台看不到 Channel Name

私聊 Claude Tag 的响应
看不到名字的 C0C0 隐藏频道

Claude Tag 产品原语

在看 Claude Tag 的细节功能上,我们需要先理解 Claude Tag 的产品原语,以便于我们对齐对于 Claude Tag 的理解,并且让你对于 Claude Tag 的产品理解有一个更加形象的认知,避免快速沉浸到产品的具体功能细节里。同时也更好的帮助理解不同功能的服务层级。

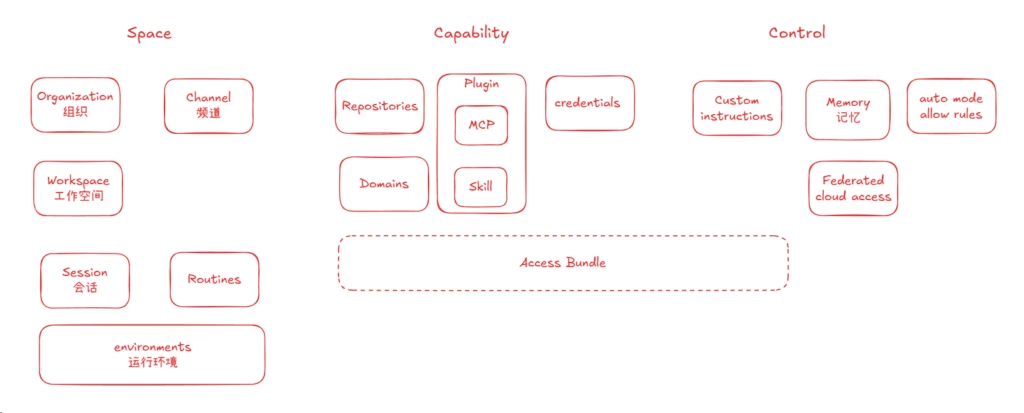
整个 Claude Tag 从产品原语上,你可以定义包括三个大类:Space(任务和行为发生在哪)、Capability(能执行和发生什么样的任务)、Control(如何控制这些任务的发生)。

Space 又可以进一步细分为 Organization、Workspace 和 Channel,后两者可以直接对应到 Slack 的相同概念(Claude Tag 如今还是和 Slack 有较深的绑定),且 Channel 是会话中的最小单元。和 Slack 一一对应可能是源自 Claude 团队自己在用,所以也就没做更多其他品类的兼容。Session 和 Routines 则是会发生在这些 Space 中的具体的会话;Session 是由人类触发的行为,而 Routines 则是由 时间触发的行为。底部的 Environment 则是两个 Session 的运行环境;

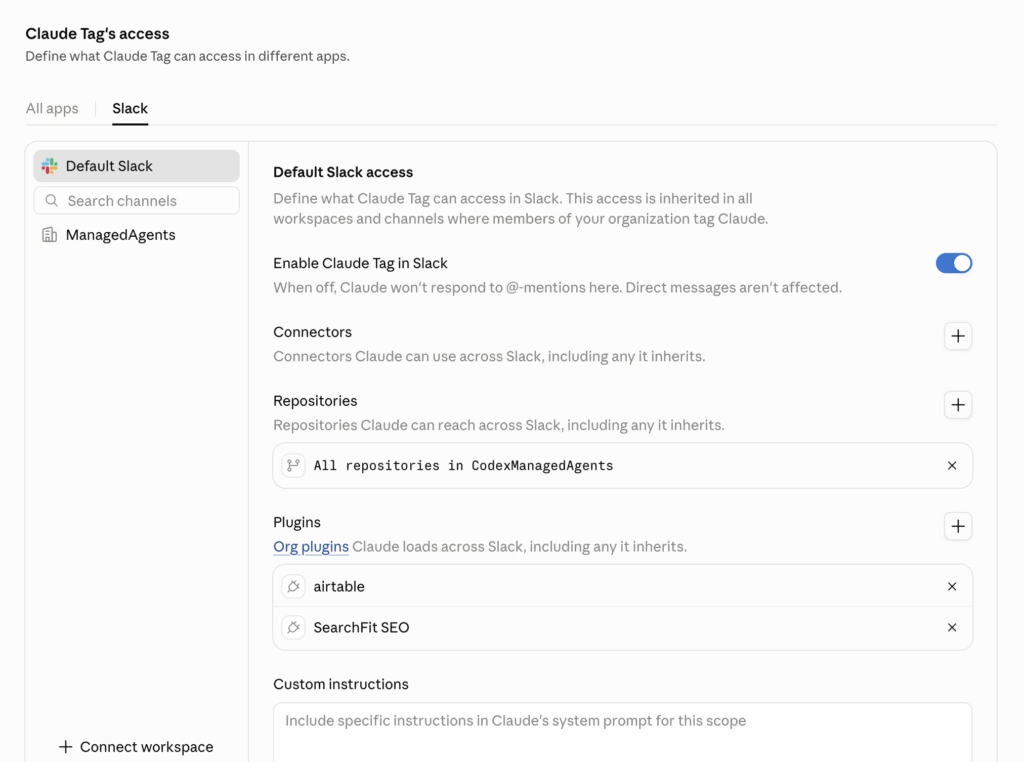
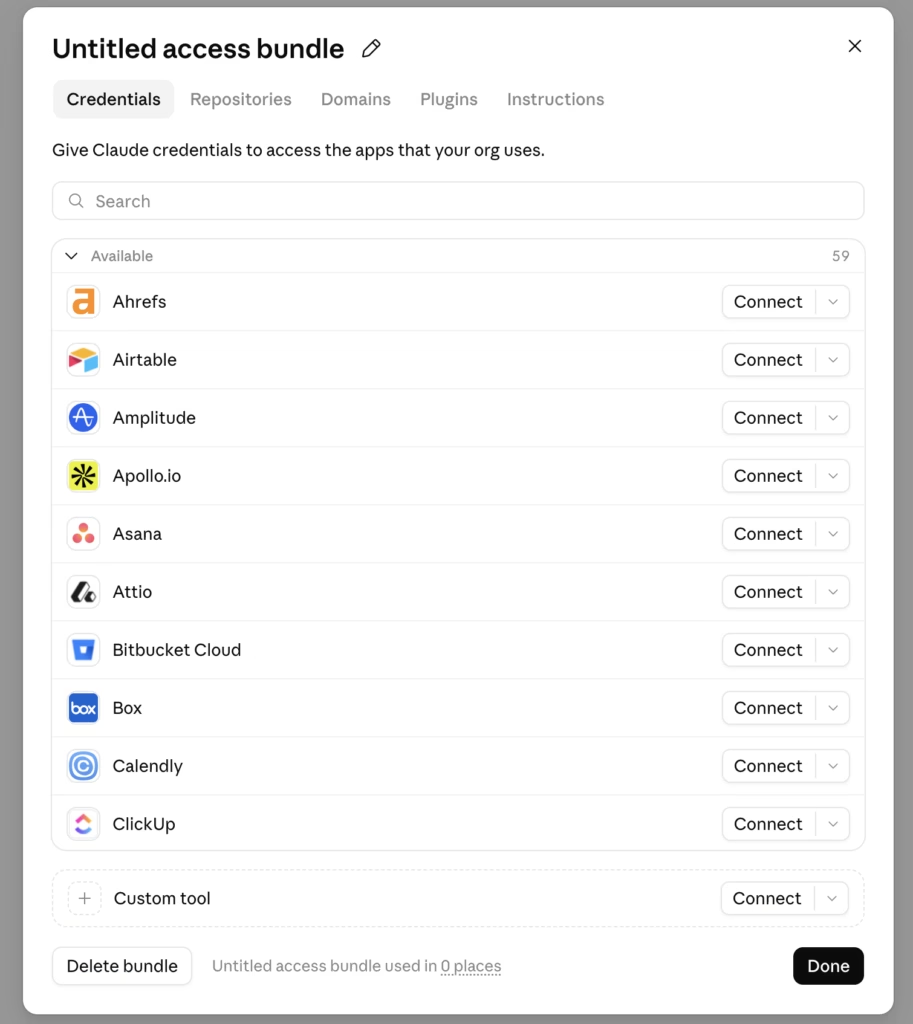
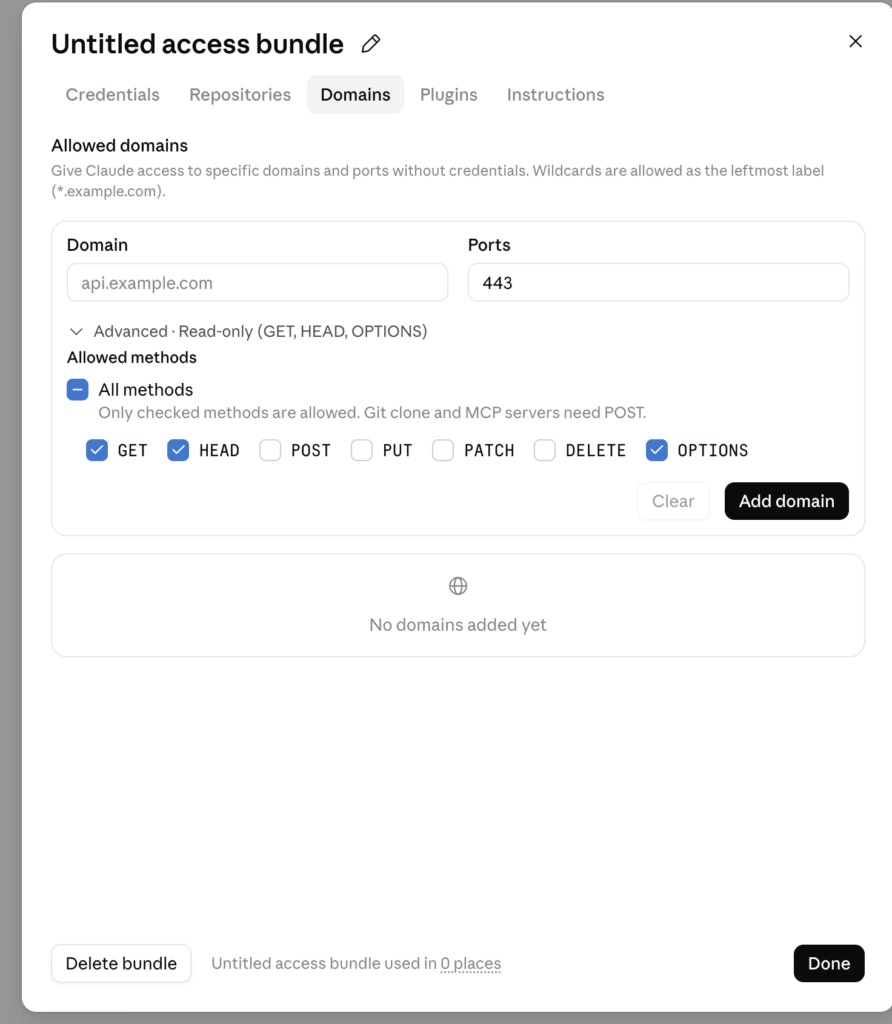
Capability 则可以细分为四个子类:Repositories、Domains、Plugin、Credentials ; Repositories 可以提供让 Claude Tag 访问的权限,你可以同时链接多个不同 Github Org 的多个 Repo,从而让 Agent 可以在多个 Repo 中协作。Domains 则给 Claude Tag 了网络访问权限, 通过 Domains 的配置,让 Claude 可以访问到目标的网站,从而获取到必要的信息,从而确保 Agent 的网络行为是可管控的,避免出现信息异常出网的情况。credentials  则提供了不同 SaaS 服务的链接能力,在完成授权后,Agent 会获取到对应的授权,以及一些预制好的 API 请求方式,从而你可以让 Claude Tag 在整个过程中,可以访问到一些外部的 SaaS,从而搞定所有的工作。Plugin 则是一个我们大家相对熟悉的概念,之前在 Claude Code 当中就有,Claude Tag 使用的 Plugin 基本上是一致的;不同的是 Claude Tag 不会执行其中的 Hook,但对于 Skill 和 MCP 都是完全支持的。

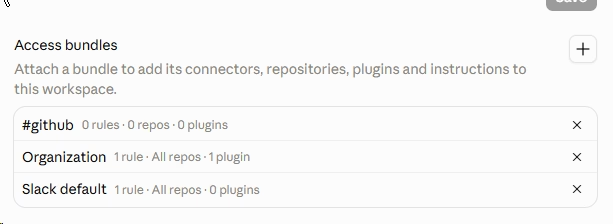
在 Capabilities 最下方,还有一个虚线的 Access Bundle;Access Bundle 是一个 Capabilities 的打包合集,其中包含了Repositories、Domains、Plugin、Credentials、Instructions。你可以在某个 Channel 中找到专属的配置,也可以直接添加一个 Access Bundle,来批量管理这些内容;从而,你可以非常快速的将一组预设好的 Access Bundle 给应用到某个特定的 Channel 上。从而快速完成不同 Channel 的配置。这里有一个特殊的是,Instruction 也是可以放在 Access Bundle 当中一起传递的;不过在产品的原语中,我将他放在了 Control 中。所以这里 Access Bundle 横跨了 Capabilities 和 Control。

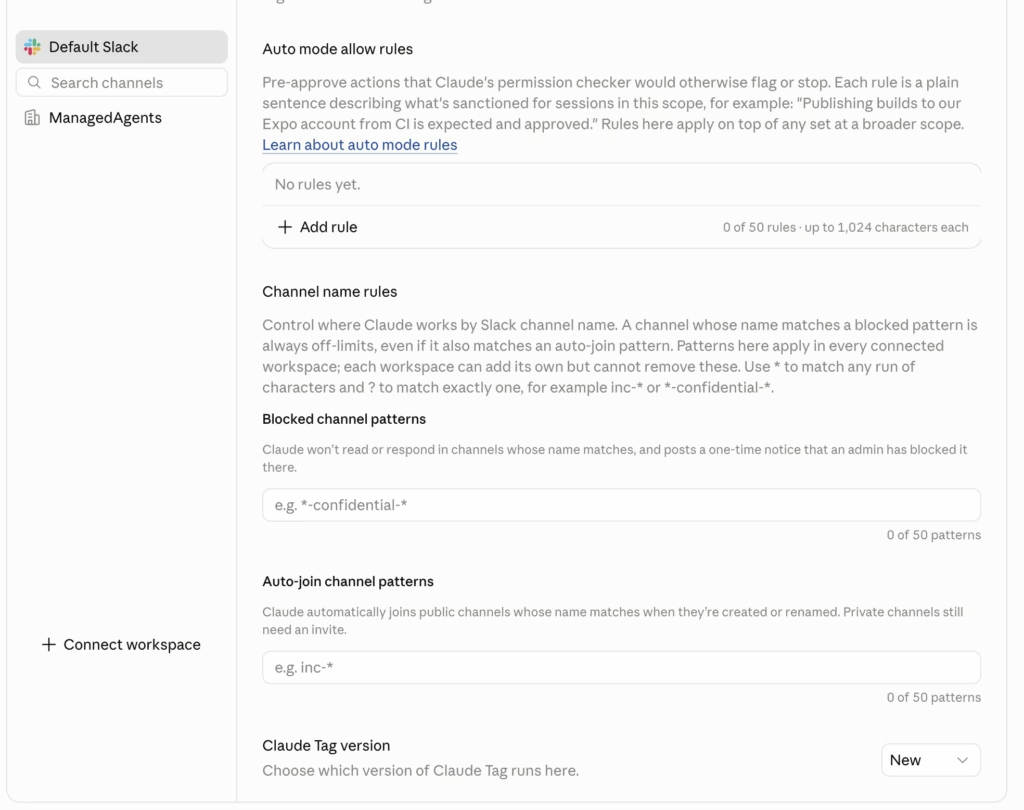
在 Control 中,则汇聚了各种对于 Agent 的控制能力(aka:让 Agent 更好的做事),这里包括了我们刚刚提到的 Custom Instruction、Memory、Auto mode allow rules、Channel name rules、Channel name rulesd等一系列细节产品功能,这里比较重要的是 Custom Instruction 和 Memory。Custome Instrucion 会出现在 Org、Channel 级别的配置当中,对应的描述会出现在 Agent 的 System Prompt当中,引导 Agent 行为。Memory 则记录了你在和 Agent 之间的交互中产生的信息,支持频道级别的 Memory 和 全局的 Memory ,从而可以实现一些很有意思的用法(比如 Claude Tag 宣发中的一个 Case: 不同用户在不同 Channel 中和 Claude 聊同一件事,Claude Tag 会主动告知另外一个用户所做的决策)。其他我们就不再专门讲述,稍后会按照具体的功能细节时再说。

当你了解了 Claude Tag 的产品原语、定位和他们之间的关系之后,我们就可以来看看他的一些底层设计机制和数据状态了,能帮你更好的理解后续的一些功能设计。

Claude Tag 的一些数据设计

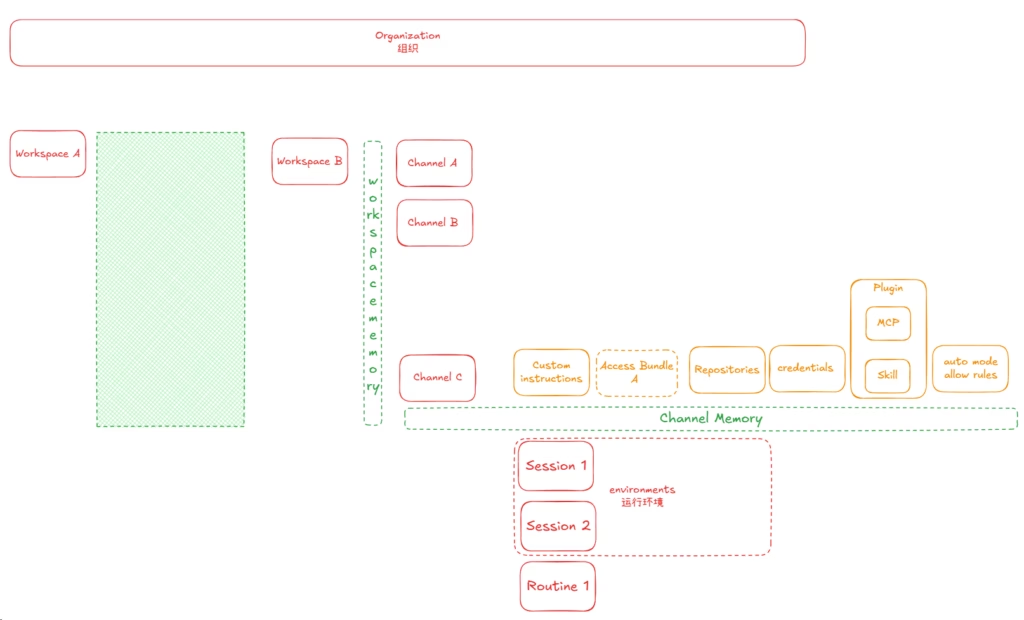
对于整个 Claude Tag 来说,你可以认为数据大概是这个样子的。

  1. 所有的数据都归属于某个特定的组织;组织下可以拆分多个不同的 Workspace(就像你可以是 Openai + 对应的 FDE 组织)。图的上部
  2. 每个 Workspace 里可以有一整套独立的 Channel、Memory 等机制;图的中左部。
  3. 当你进入到每个 Workspace 之后,你会看到 Workspace 内部的 Memory(工作区级别的),然后里面可以有不同的 Channel 来进行日常的沟通和不同工作的分配。比如有的做 A,有的做 B;有的做 C;大家分布在不同的 Channel 里;图的中下部
  4. 每个 Channel 中有自己的 Channel Memory 、Custom Instruction、Access Bundle、Plugin、Credentials、Repository 等一系列 Agent 运行所需要的信息。用户可以根据自己的需要选择合适的内容。图的中右部。
  5. Channel 内部,会同时出现多个 Session 或 Routine。且由于存在自定义 Environment 的能力,可能会出现部分运行在 Anthorpic 的 Runtime 里,部分运行在用户自建的 Runtime 里。

上面的这种数据组织方式,很好的满足企业对于数据的管理诉求:

Claude Tag 的一些产品设计细节

围绕这上述的产品原语、产品数据设计;和面向 To B 的产品设计,里面出现了大量很符合 To B 产品直觉的产品设计。

  • Claude Tag 是组织买给你的,所以组织、Workspace、Channel 当中,都要能够给你的 Channel 设定不同的 Custom Instruction,从而确保你在使用 Claude Tag 做应该做的事情。正常情况下时按照顺序一层层拼接。
  • 一个公司可能会存在不同的部门和分公司;不同的产品团队也可能会使用不同的 Slack Workspace ,从而更好的做好权限管控。因此,要支持一个 Claude Tag 能连接多个 Slack workspace。
  • 一个 Agent 想要完整的完成一系列工作,不是简单的 Prompt 、Skill 就能解决,依赖MCP、鉴权、Skill和一定的指引。如果一个 Agent 要被持续复用(比如做客服 Channel 用),那么提供一个打包的 Access Bundle 就是必要的。
  • 由于每个 Channel 都不是从 Day 1 就开始思考 Access Bundle,和目前这种 Channel 中除了 Access Bundle 还能单独配置 Credentials(在单独Channels 里叫 Connector )、Plugin 的能力,我猜测大概率他们是先有 Channel 级别的单独配置,后面共享多了,干脆提供了单独的 Acess Bundle。目前已经出现每个 Channel,很快可能就会去掉 Channel 级别的配置,直接改 Channel 上的默认的 Acess Bundle 就行。
  • 在让 Agent 工作时,会涉及到一个 Agent 可能有多种职能,因此允许 Access Bundle 的叠加
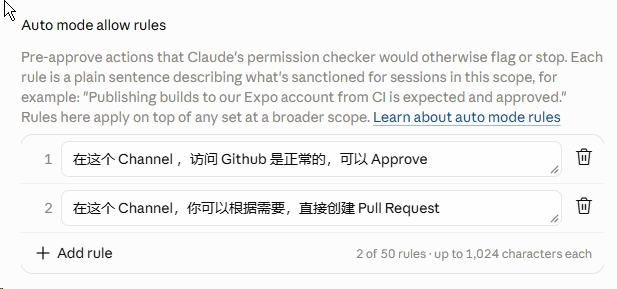
  • 由于在 Slack 的对话式交互中,进行权限审批是一个复杂和不好判断的事情,因此,设计了 Auto mode allow rules,允许用户根据需要,写一些简单的规则,来让 Agent 自己进行 Auto mode 下的判断。一方面相信 Agent 的能力;另一方面,也给了企业足够的控制权。对于 Claude 还不擅长的业务领域,提供了足够的逃生空间。
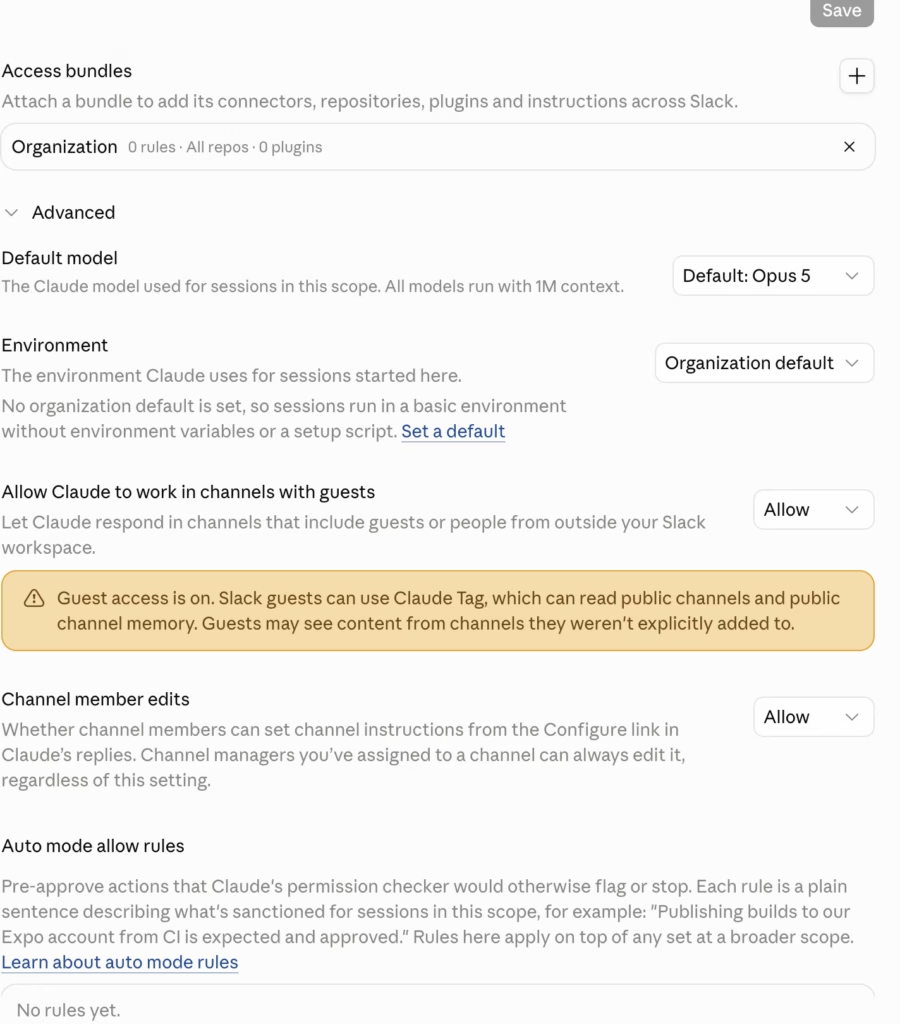
  • 因为要把 Claude Tag 用在对外客服,因此支持 Claude Tag 被 Guest 访问;但对于不把 Claude Tag 用作客服场景的企业来说,可以直接关掉这个 Feature。
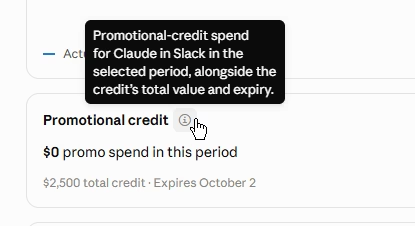
  • Claude Tag 似乎改了一次计费逻辑;在上个月我刚开通的时候,是你充值多少用多少;上个月两个任务花了我 $10 ;我赶紧把默认模型改成了 Sonnet 5 ;但今天写这个 Blog 的时候发现,似乎也变成了 Credit 的机制。如果是这样的话, Claude Tag 还蛮香的。
但最后发现其实是推广活动送了 2500 刀 的 credit
  • 如果是将 Claude Tag 用在客服支持等场景,可能会出现某些特定规则的群名,这些群名可能是希望 Claude Tag 加入或者不加入的,所以这里还会有专门的 Channel Name Rule;有白名单有黑名单;白名单会自动加入;黑名单则是绝不加入。对于一些做客服的场景,完全可以把 Channel 名写成 [Channel Support],然后等 Claude Tag 自己进去做支持。

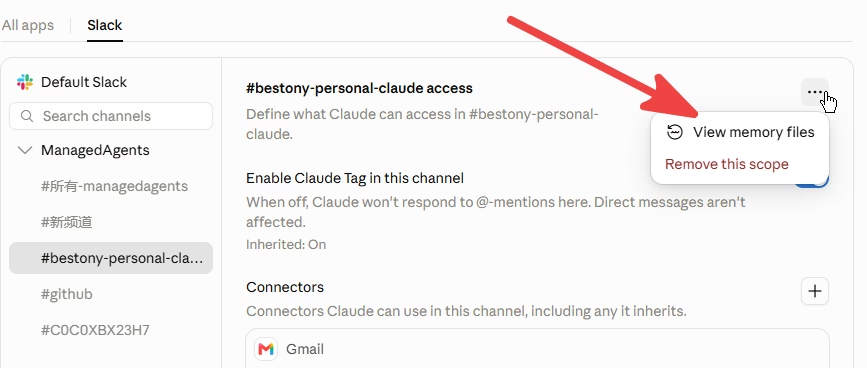
Claude Tag 的 Memory

Memory 是如此的重要,以至于我认为我一定要专门开一章来写它。如果你要做仿品,只做一件事,那我认为就是做这个 Memory 体系。

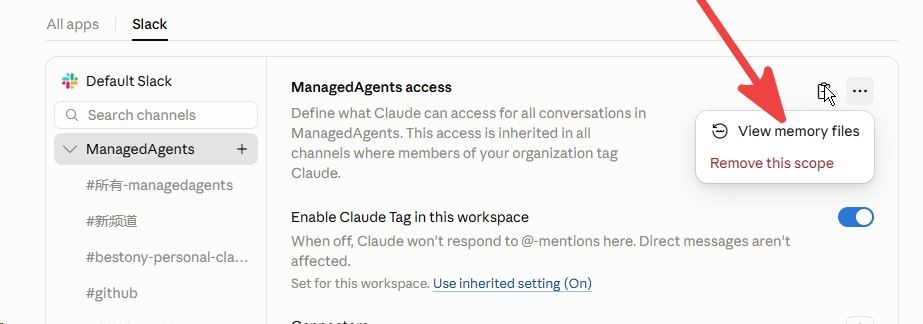
Claude Tag 也为其产品设计了 Memory 的机制,

Workspace 级别入口
Channel 级别入口

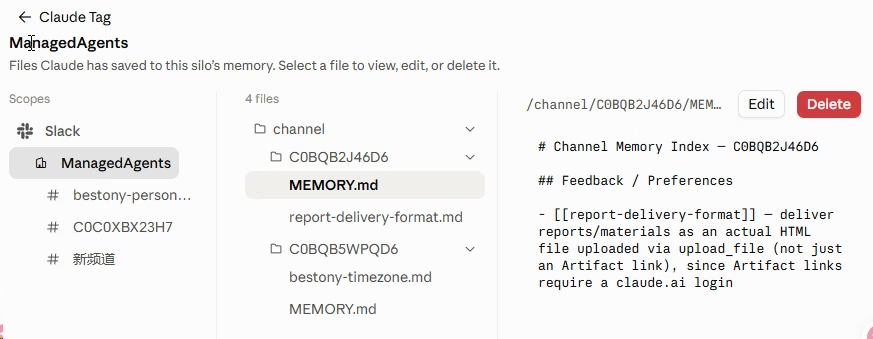
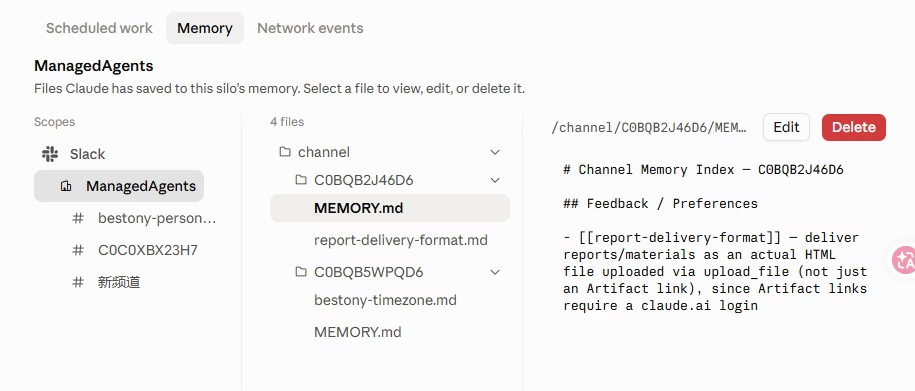
你可以看到,Claude Tag 的 Memory 是以树的形式来组织的:

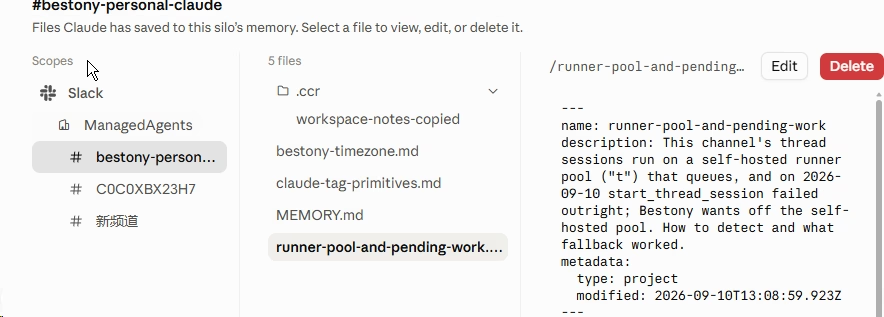
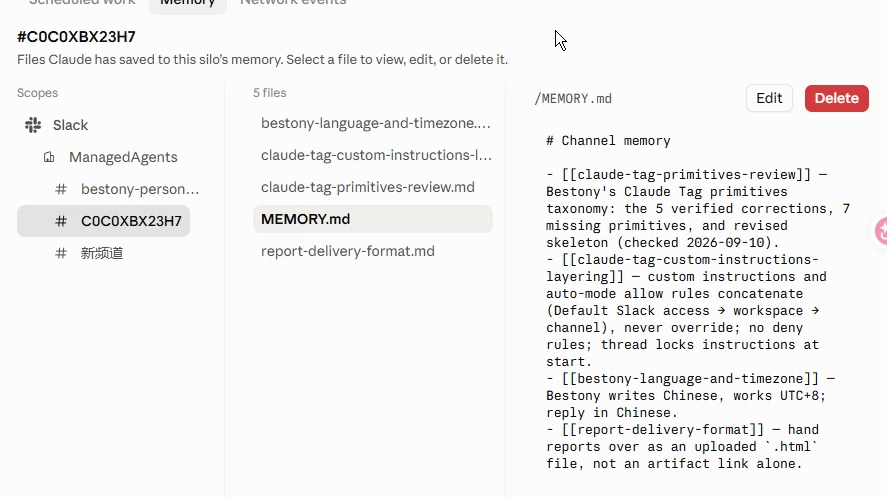
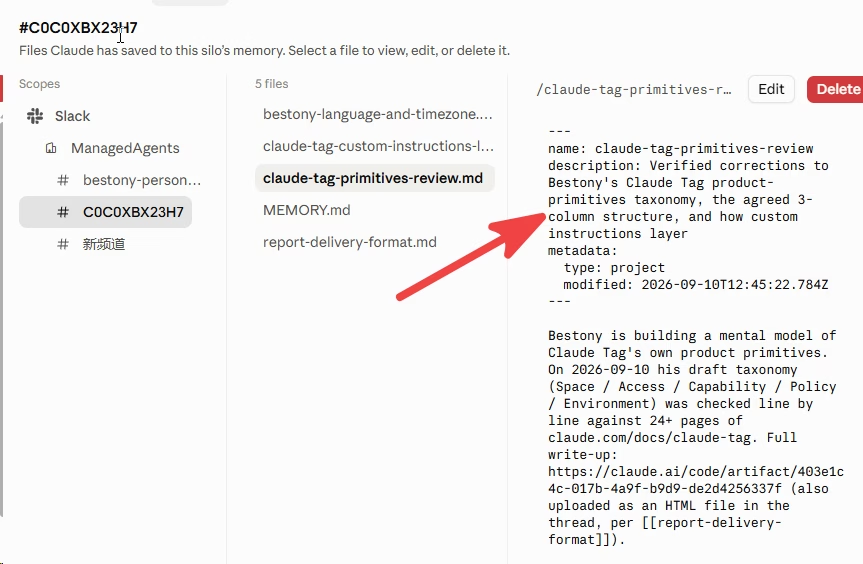
你会先在 workspace 级别的 Memory 中,看到 每个 Channel 中的 Memory ,但这里其实是各 Memory 的 Channel 的总结,更多是一个 Summary;而不是完整的 Memory;

而 Channel 级别的 Memory,你需要切换到 Channel 的选项中,查看详情。

在实际的使用时,memory.md 会作为索引,加载到 System prompt 中,Agent 根据需要,自己加载别的文件

且系统会根据相关性,通过对 Description 的二次判断,正式判断是否需要加载 Memory 当中的细节,并取 前4K 放在 context 中,方便 Agent 进一步自己去读。

Claude 一个 Channel 中可以有多个 Session (每个 Threads 都是一个新的 Session),Claude Tag会在开始处理任务的时候加载 Memory,因此,如果某个 Threads 写入了 Memory,另外一个 Threads 大概率需要到下一次调用时才能加载到。

在写入 Memory 的时候,Claude Tag 是在本地以文件夹和文件的方式组织 Memory, Agent 在必要的时候,写入相关的 Memory,当然,你也可以自己主动和他说。

Claude 会把 Memory 写入到 Channel 和 Silo 文件夹;这两个文件夹的区别主要在于silo存储的是 workspace 级别的 Memory;而 Channel 存储的是本 Channel 自身的 Memory,这样就可以同时兼顾本 Channel 和全局的 Memory,从而确保 Agent 能及时获得必要的 Memory;同时,因为 Agent 可以同时看到两组 Memory,就可以有所取舍,将 memory 放在合适的位置。

===== 我在沙箱里看到的目录(文档未描述) =====
/tmp/claude/memory
`-- team
    |-- channel
    |   |-- .memory-sync
    |   |-- .memory-sync-basis
    |   |-- MEMORY.md
    |   |-- bestony-language-and-timezone.md
    |   |-- claude-tag-custom-instructions-layering.md
    |   |-- claude-tag-primitives-review.md
    |   `-- report-delivery-format.md
    `-- silo
        |-- .memory-sync
        |-- .memory-sync-basis
        `-- channel
            |-- C0BQB2J46D6
            |   |-- MEMORY.md
            |   `-- report-delivery-format.md
            `-- C0BQB5WPQD6
                |-- MEMORY.md
                `-- bestony-timezone.md
7 directories, 13 files

Code language: Bash (bash)

Claude Tag 的审计功能

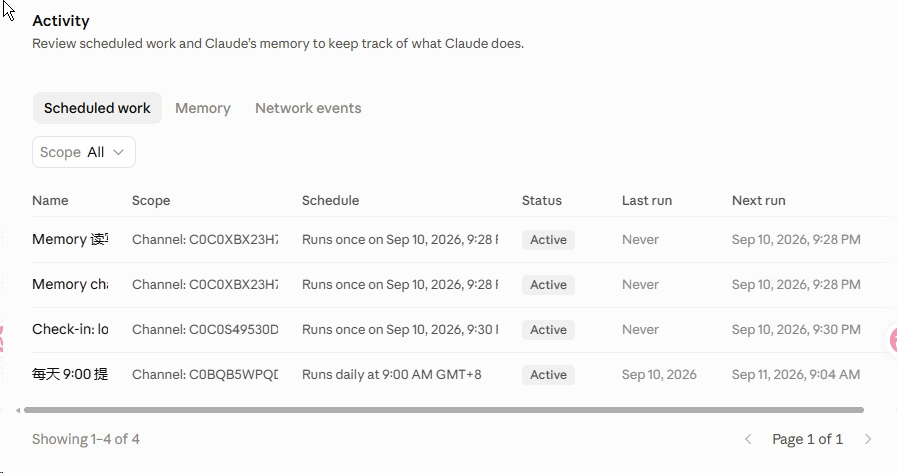
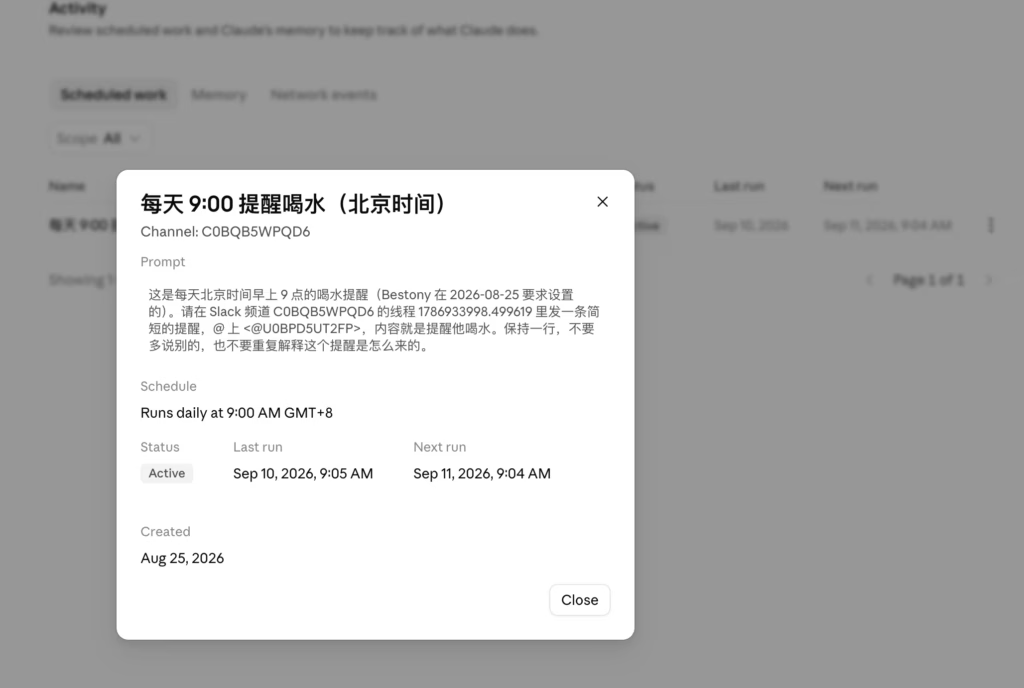
作为一个 To B 的产品,审计功能是必须的。 Claude Tag 也提供了一些基础的审计能力,分三个大类:Scheduled Work、Memory 和 Network Event。

Scheduled Work 能够查看 Agent 的定时任务;不过也会发现 Agent 在执行任务的时候,也会把一次性任务当成 Scheduled Work 录入,从而导致展示在这里。

memory 则是整个 Org 级别 Memory 的展示,你可以根据需要查看和编辑某些 Memory。

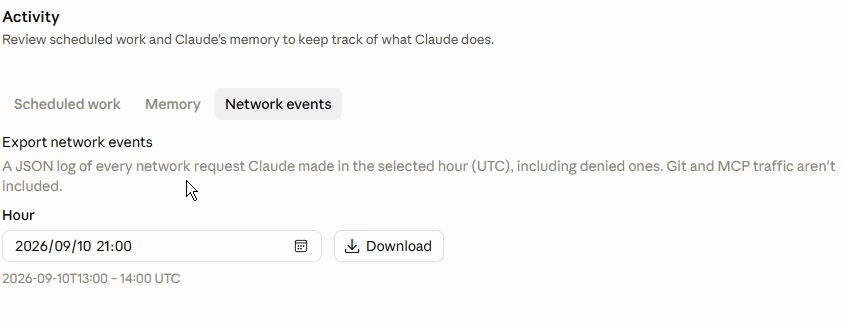
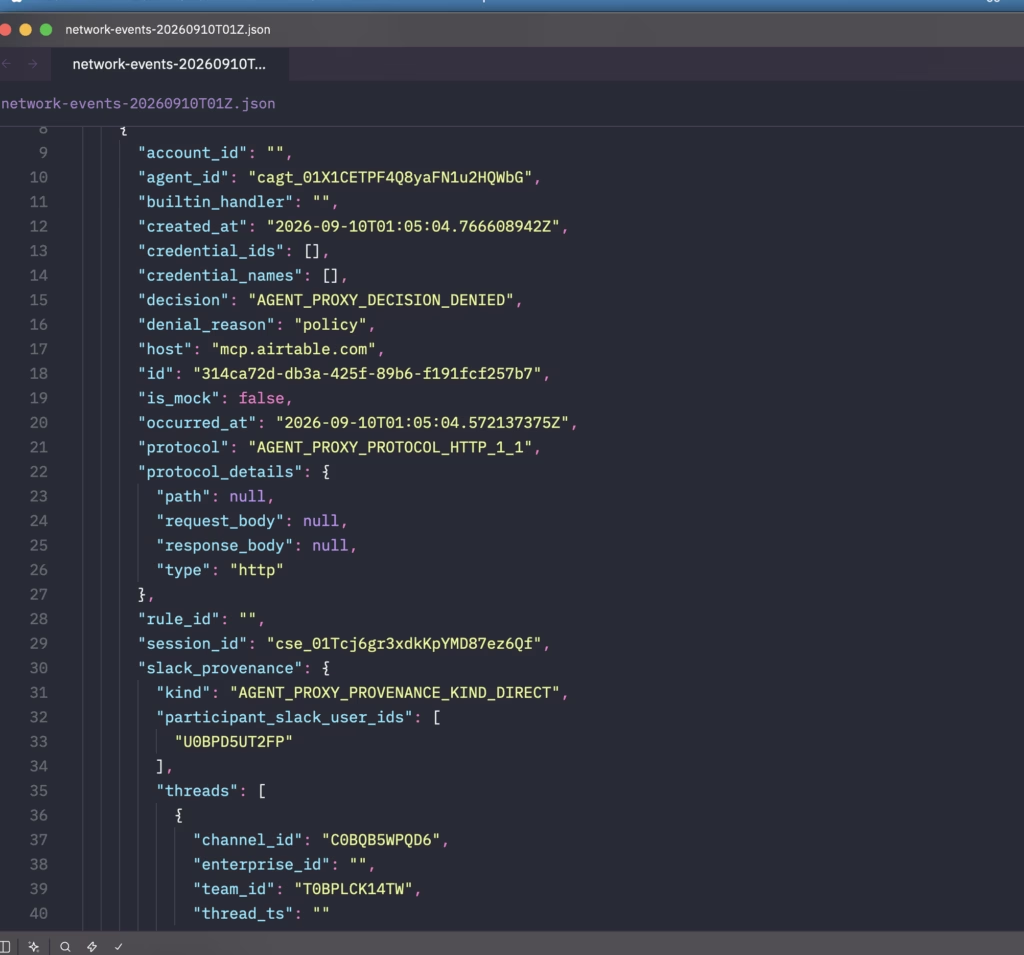
Network Event 则是可以真的查询某个 Agent 对于网络的调用情况(还记得前面配置的 DOMAIN 么?)。

选择要查询的时间范围,就可以查询对应时间范围内的网络请求并分析。

Claude Tag 的 Custom Runtime

作为一个企业级产品,企业肯定会希望能够让运行行为发生在企业可控的网络环境,这样就可以充分利用企业内部的各项资源来完成这个目标。

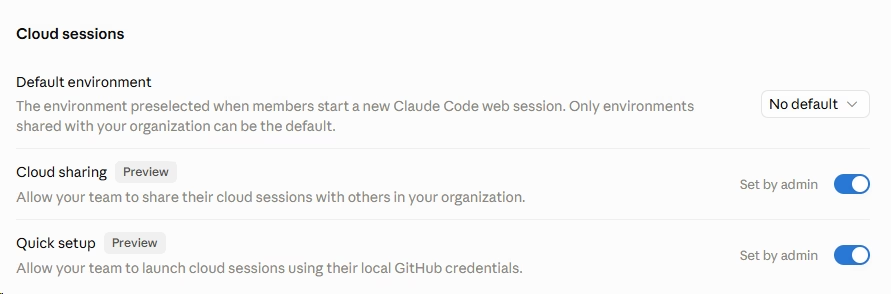
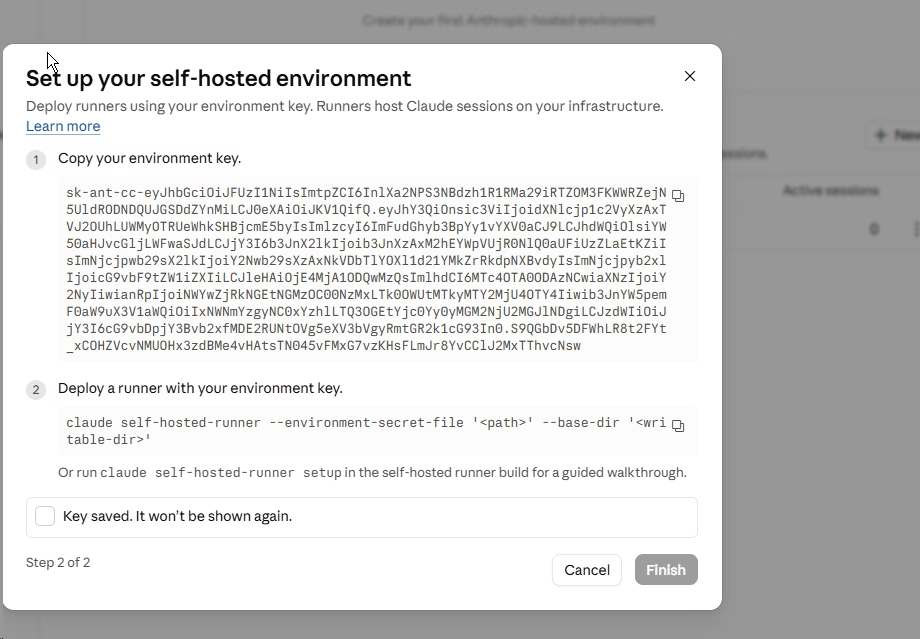
Claude 支持创建一个 Self Hosted Environments ,来控制 Cloud Session 运行在哪个服务上

可以通过后台的配置,创建一个新的 Self Hosted Environment 来配置自己的 Runner,从而在企业内部使用的时候,就可以直接使用内网的设备来运行任务,执行各项内部基建。

再配合 Access Bundle 中的 Domains 的配置,可以开启对内网服务的访问权限。

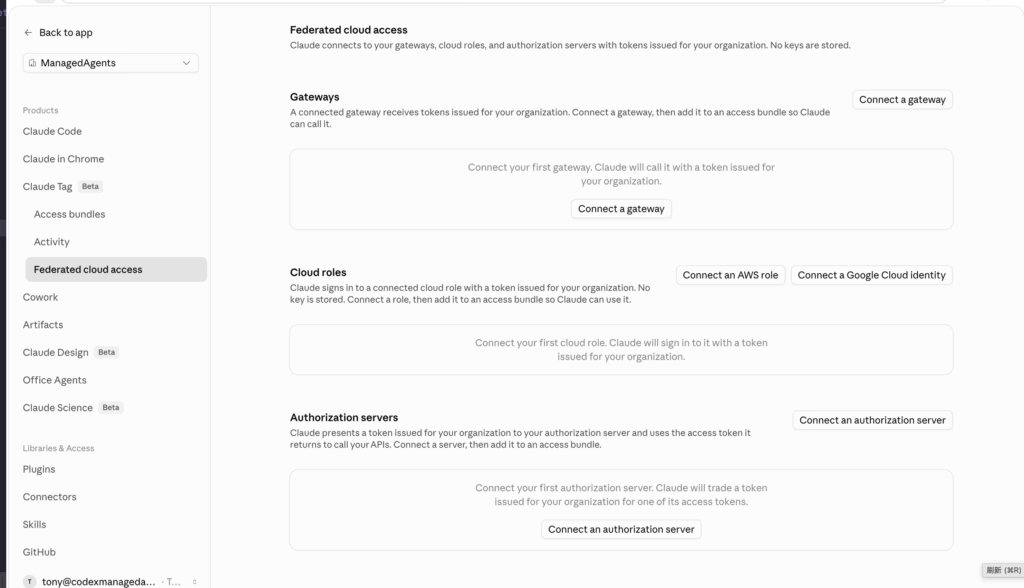
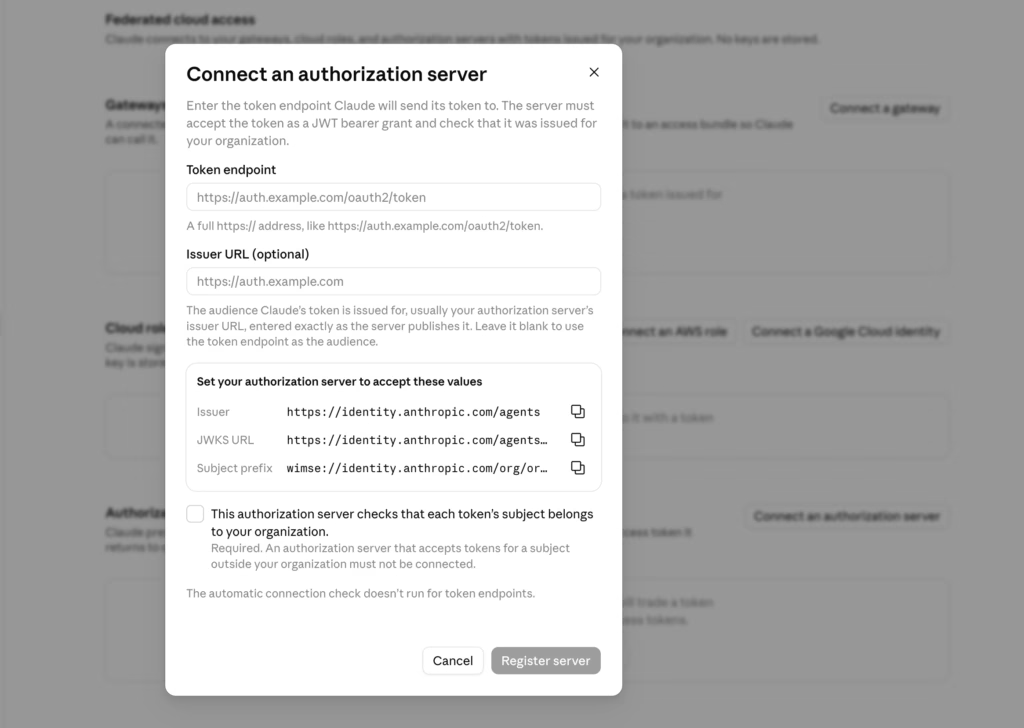
辅以 Federated cloud access 链接到内部的 Gateway、授权服务,来实现整个内部的权限管控、安全控制,从而更好的服务企业,让企业更敢于使用 Claude Tag。

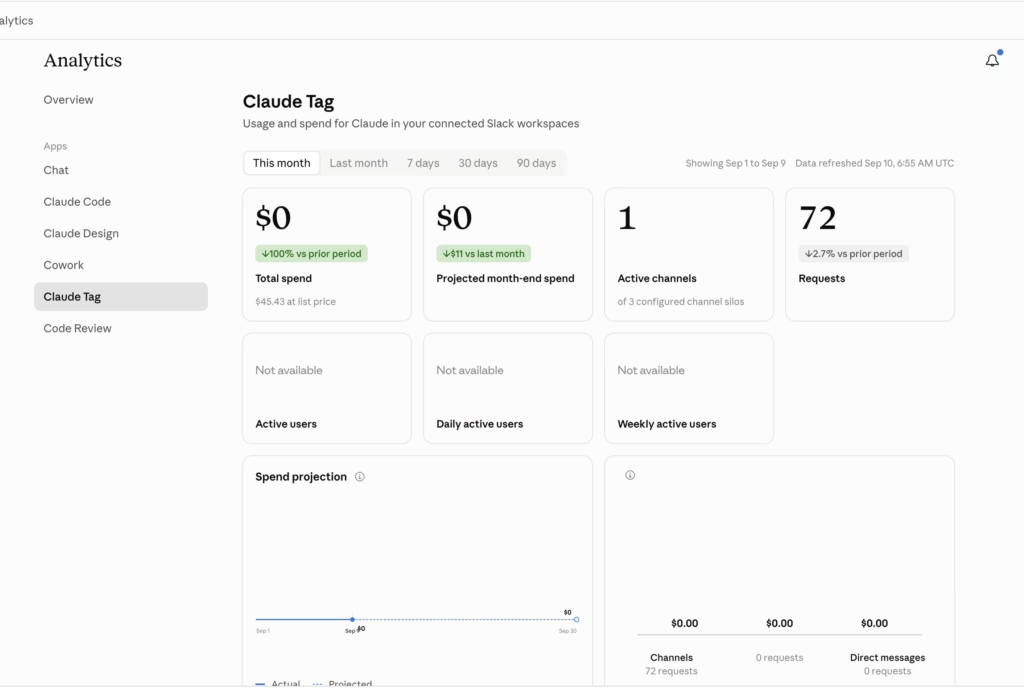
Claude Tag 的统计看板

Claude Tag 为用户提供了一个非常简单的统计看板

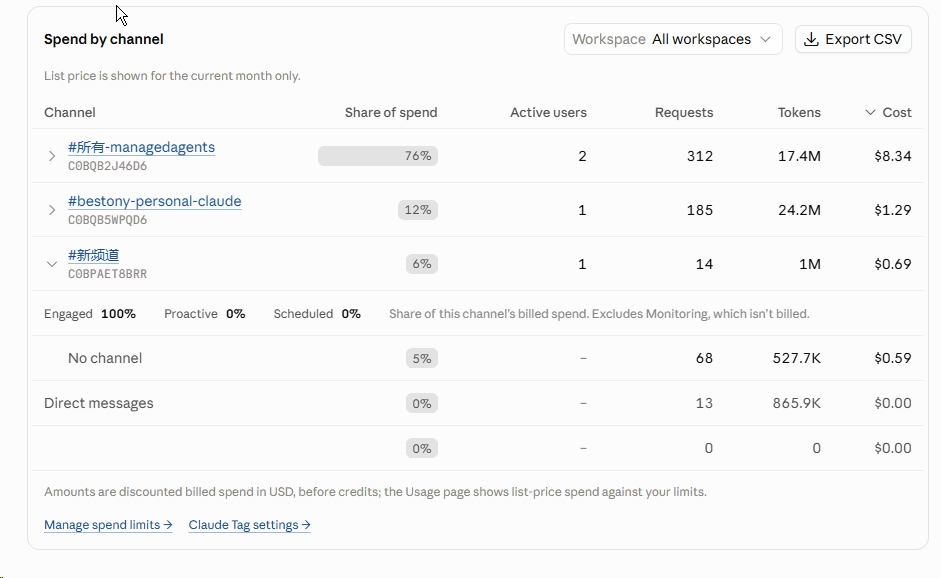
不过,最核心的 —— 哪个 Channel 最烧钱依然是有的

Access Bundle 的一些细节

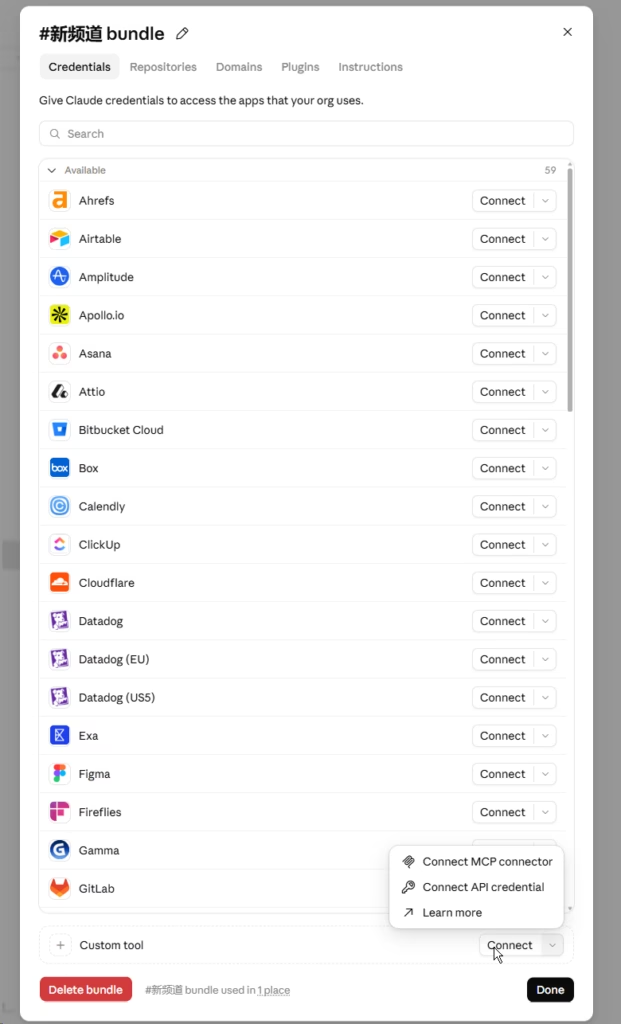
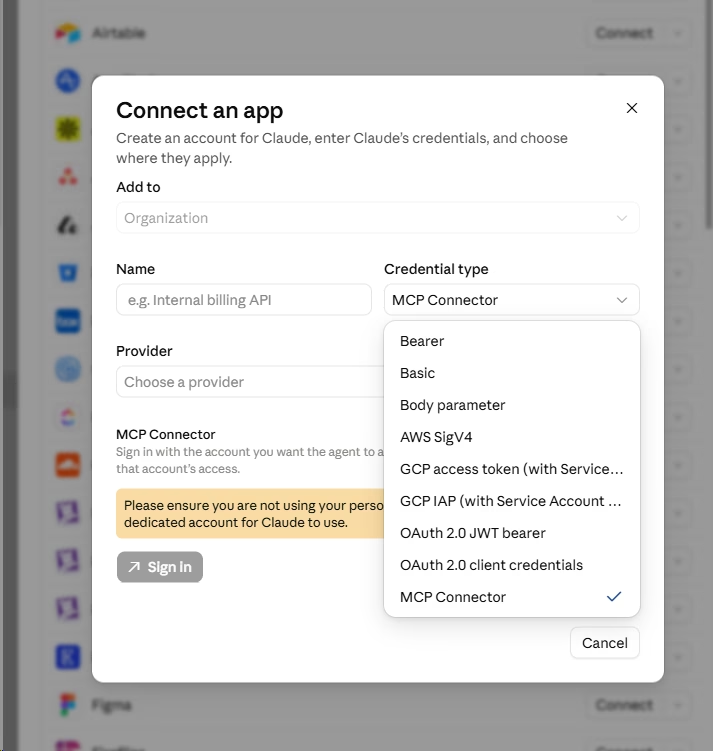
  • Access Bundle 的 Credentials 除了已经提前集成好的服务,还可以加入自己自定义的 MCP 和 API Server

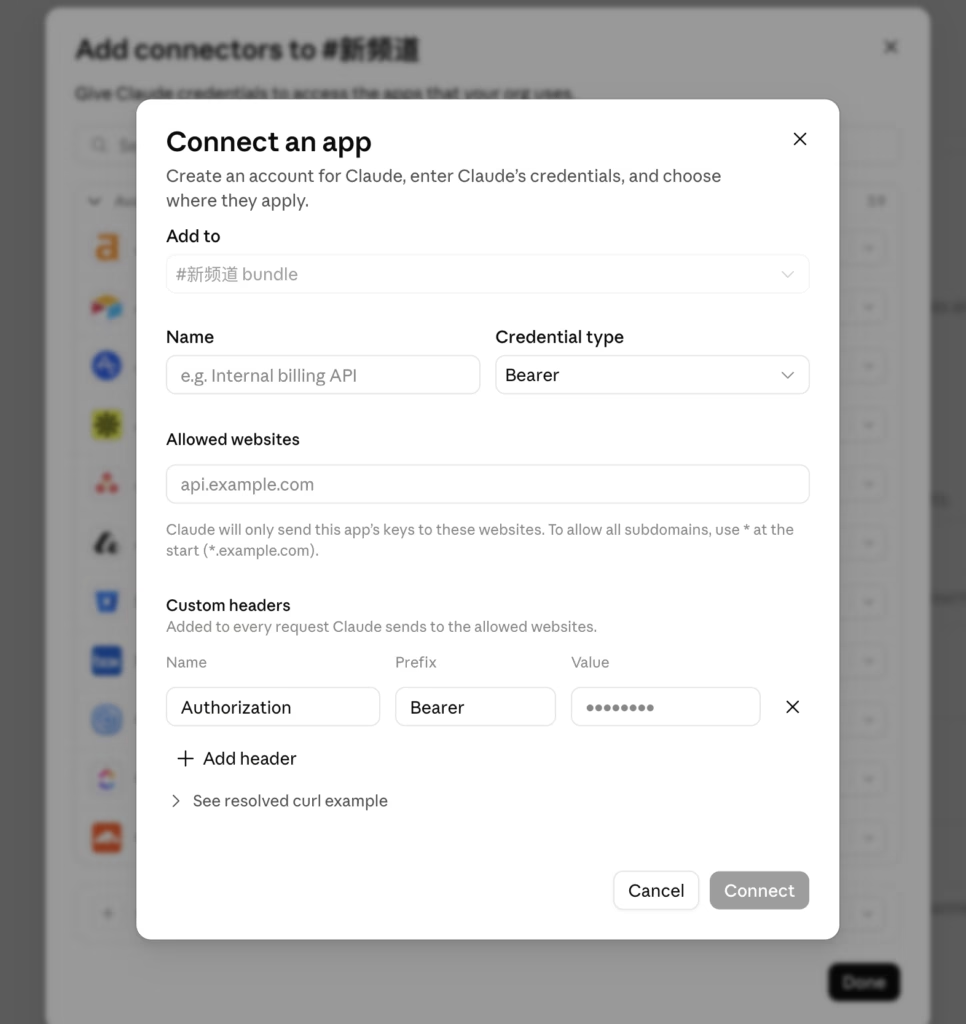
在使用 API & MCP 接入的时候,可以配置多种不同的授权方式,来满足绝大多数常见的业务场景,确保你能接入绝大多数业务。

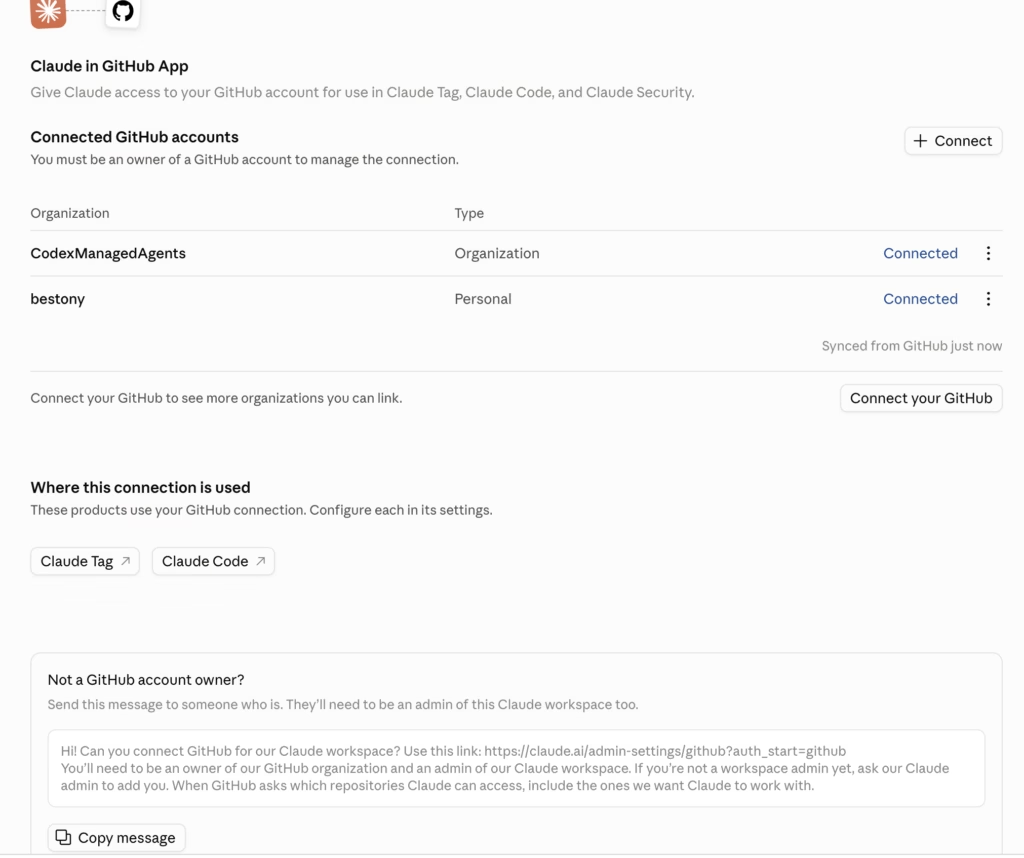
Repositories 的的支持需要你将 Claude 的 App 安装到你的 Org 里,才能使用。

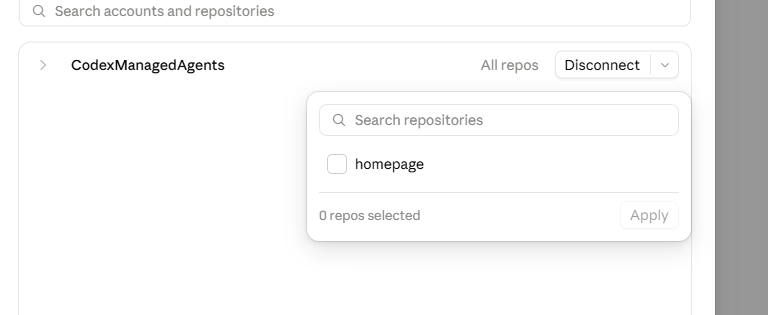
如果你有多个 repo ,也可以配置具体要用哪个 repo

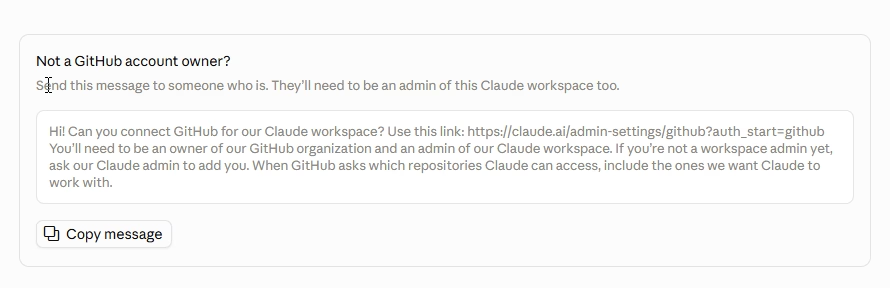
我觉得比较好玩,但觉得很合理的设计包括:给用户一个 prompt,发给 github account owner 来做 link

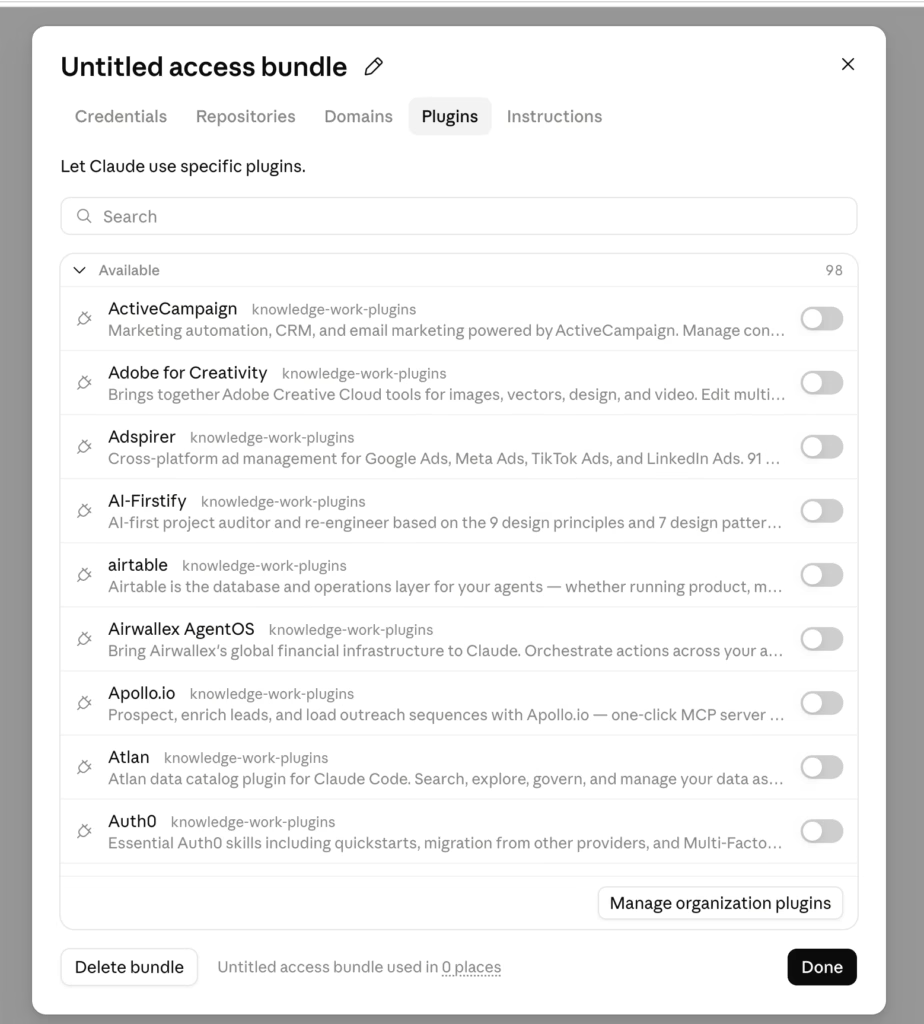
在配置 Plugin 的时候,你可以选择多个 Plugin 放在同一个 Bundle 里,来方便使用和配合。还可以接入组织自己的 Organization,来方便使用组织内部特有的 Skill & MCP。

总结

这篇文章一边写一边截图,花费了将近 3 个小时,希望内容能帮到你,更好的思考 —— Claude Tag 到底给用户提供了什么。绝不是简单的将模型链接到 Slack 上;

背后的功能、实现,对于 TO B 功能的考究,都是很值得学习的。

都看到这了,我猜你肯定想试试看这类产品?那不妨试试我最近参与开发的一个开源项目 —— https://github.com/first-tree-ai/opentag 。我承认,我们还没做到很多这篇文章中提到的 Claude 的功能,但,在路上了,不是么?也欢迎你参考进来一起开发。

如何选择 DeepSeekHarnes / Claude Code/Codex/ Pi

文章将 Agent 工具分为 Coding Agent 产品、Agent SDK 和 Agent Framework,建议先根据使用目的选择类别,再比较具体工具。Coding Agent 的选择取决于预算、模型偏好、自定义需求以及是否想尝试递归自进化。

Agent SDK 适合保留现有 Coding Agent 能力并接入自定义交互界面;Agent Framework 则用于自行定义 memory、工具和 Agent loop。作者认为 DeepSeek Harness 目标宏大、仍在发展,短期不作为主力工具,但其递归自进化方向值得持续关注。

最近会和一些朋友聊到关于不同的工具选型,我发现很多朋友对于不同的 Agent 开始有一些混淆的理解,为了帮助大家更好的选择不同的工具,我写了这篇文章,希望帮助到你做选择。

你要做什么?

大家虽然在聊 Agent,但可能聊的不是同一个 Agent;有的人需要一个开箱即用的 Agent;有的人需要一个能够丰富自定义的 Agent,方便发挥自己的想法;有的人需要感受“未来科技”;还有的人,只是要开发一个自己的 Agent。

这里面会存在不同的需求,对应需要的东西也有所不同;简单来说,你可以在这个表里找到答案

类型目的选择
Coding Agent 产品我想用 AI 写代码Codex
Claude Code
Pi
OpenCode
Grok Build
?DeepSeek Harness
Agent SDK我想编程式调用 Coding AgentCodex Agent SDK
Claude Code Agent SDK
OpenCode SDK
Pi SDK
Agent Framework我想定制一个自己的 Agentpi
?deepseek-harness

这里面每个分类对应的是不同的人,首先,你需要先根据自己的目的,把自己分到对应的分组类型里,然后再在分组类型内部,找合适的配合。

Coding Agent 产品怎么选

Coding Agent 产品也会分不同的人和喜好:

  • 如果你是拿来干活,且预算充足,那么官方的 Claude Code 和 Codex 一定是你最优解,使用最尖端的模型,帮你把事快速干完;如果你想要做一些配置,市场上基本上能看到你所需要的绝大多数教程,应有尽有。Grok Build 是上面二者的平替;如果你是 Twitter(现 X.com)的蓝 V 用户,那么 Grok 还送了你免费额度,也很不错。
  • 如果你是拿来干活,但缺少预算,或者更倾向于使用国内的模型,那么 OpenCode 是一个不错的选择,也是一个成型的产品,拥有不错的 TUI 和交互;能够帮助你快速landing,教程的量级也不错,能够找到绝大多数的教程和说明。
  • 如果你已经体验过了上面的两个 Coding Agent,但同时也有自己的想法,觉得他们太过冗余,或者是有太多你用不上的功能,那么极简,但带有插件机制的 Pi 是你的最优选择。相比于同样拥有插件机制的 dsh,pi 其实拥有更稳定的核心和插件生态,能够帮你快速先构建属于你自己风格的 Coding Agent。
  • 如果你想试试 RSI(Recursive Self-Improvement,递归自进化),那么 DeepSeek Harness 就是一个不错的选择, 你可以让 Agent 给自己写插件,一边开车,一边换轮子。

Agent SDK 产品怎么选

如果你想要使用现存的 Coding Agent,但又不喜欢它们所提供的交互界面,那么你可以考虑使用 Agent SDK,自己构建交互的界面。比如把 OpenCode 接入到你的飞书上,那么就要考虑使用 Agent SDK。它可以帮助你在保留原有 Agent Harness 设计的基础上,让你拥有可编程调用的能力,从而接入你自己实现的交互界面。

在这个部分,选择主要取决于你在用什么 Coding Agent 和其 Harness,选择其官方提供的 Agent SDK 即可;有的是通过 Http Server 调用,有的是通过进程调用,但总体来说,都帮你封装了底层 Harness 的复杂度,你主要围绕 Agent 和 Session 的概念去设计你的交互界面即可。

Agent Framework 怎么选?

到了 Agent Framework,基本上已经比较深了,你可能在定制一个自己的 Agent,比如我最近在定制一个翻译的 Agent,就是要自己去定义它的 memory、tool、agent loop 等不同的方案,这个时候我就需要 Agent Framework;

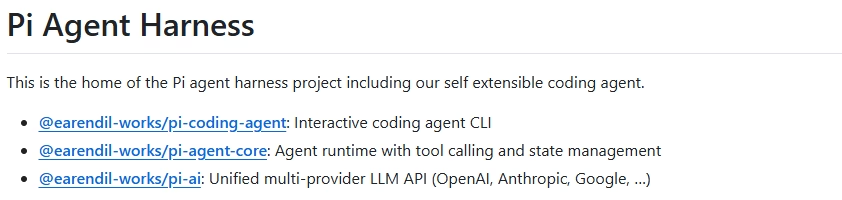
这个时候你可以选择自己手搓一个 Agentloop,或者也可以像我一样,直接引用 Pi 的 agent-core 和 pi-ai 来完成 agent 的开发。

deepseek harness 也是一个不错的选择,社区有插件来帮助你去实现功能。

我自己对于 DeepSeek Harness 的看法

我觉得 DeepSeek Harness(DSH)要解决的问题很宏大,这意味着不会很快;再加上当下 DSH 还是按照一个软件工程产品在开发,所以我短期不会把它用作主力的 Coding Agent;但递归自我改进(Recursive Self-Improvement,RSI)本身是有意思的,是值得关注的,所以 DSH 我会持续关注和尝试,作为一个观测对象来学习。

对平台存在敬畏

我曾经一度对于「平台产品经理」是没感觉的。毕竟大家都是产品经理,做平台有什么了不起的?大家干的不都是产品经理的活么?你有什么差异。

但,后面,发生了一件事,让我记忆犹新,从而对于「平台产品经理」和平台级业务的感知和敬畏加深。

那时我刚加入飞书开放平台,作为飞书开放平台的技术型产品经理,我要去推动一个产品上的 API Breaking Changes。如果在产品发布前就触发了 Breaking Changes,就一定要提前告知客户,不然会直接出现事故,要追责。所以,我就发布了通告,进行客户的告知。

看起来很正常,且做的事情逻辑也对,是么?

但其实那次被定义为事故,事后组织了复盘。

之所以被称为事故,是因为,我的客户告知,进行了一次大面积告知,我的通知告知了所有的开发者客户,但实际上真正可能受影响的客户并没有那么多,我的过度告知反而给平台带来了巨大的解释成本和服务成本。

这个事情很小,但非常明显的体现出了普通产品和平台型产品的很大区别,普通产品大家的影响面可能是非常有限的,但平台型产品,特别是 TO B 的平台型产品,你的影响面可能是数以万计的用户和客户。一个处理不好,可能就是所有人要陪着你一起去跪客户的。

我的 AI Coding Guide

最新更新于 2026 年 6 月 29 日

这个指南是我自己的 AI Coding 的经验总结,我认为在实际使用 AI Coding 的过程中,应该注意和遵循的规则。

这篇文章是我实践后高度总结出来的结论,如果你想看更细致的内容,可以看 从“代码补全”到“全托管 Agent”:我的 2025 AI Coding 进化论 和 半年过去了,我和 AI Coding 的关系有什么变化?

精力管理

当你开始使用 AI Agent 来辅助编程后,你很快会发现,最大的瓶颈是你自己的管理范畴和你的精力管理。

1. Attention Is All You Need

AI 时代,信息的生产变得无比简单,这导致我们看到的信息、要处理的信息进一步爆炸。因此,如何更好地利用 AI Agent,降低我们的决策成本、提升我们的信息信噪比,让我们可以少做决策,做正确的决策。

2. Use the Strongest Model Where It Matters

使用你能接触到的最贵的模型来进行开发;能用 Claude Opus ,就不要用 GPT 5.5 XHigh;能用 GPT 5.5 XHigh,就不要使用 GLM 5.2 。

更贵的模型意味着对于你来说,可以更少的干预和决策,降低你对于 Agent 的管理成本。除非,某个任务对你来说,真的就是一句话任务,或者让他执行一个极其简单的任务。

对于格式化、批量替换、简单脚本、低风险机械任务,可以使用更便宜、更快的模型。

3. Prompt is Spec

你写给 Agent 的 Prompt,本质上就是临时规格说明。模糊的 Prompt 会生产模糊的实现。一个好的任务应该包含:背景、目标、非目标、修改范围、验收标准、验证命令和风险边界。

不要害怕给 Agent 长的 Prompt,相反,你应该尽可能榨干自己的脑子当中的想法,把和你的需求相关的事情全部写下来,即使只是很简单的个人倾向性的描述,也可以有助于帮你更快的完成自己的目标。

4. Plan Before Your Build

所有的工作,除了简单的日常动作(就是那种你觉得丢给随便哪个模型都能干的事情),只要是正常的工程工作(Feat / Bug / CI),都要使用 Plan Mode 先聊一轮。目标是在过程中澄清你的需求,避免似是而非的需求进入到研发队列,浪费你的时间和精力。

把主要精力放在 Review Plan、Review Diff、Review Test Result 和风险项上,而不是逐行 Review Agent 写的每一行代码。你的精力终将不足以支撑传统意义上的全量 Code Review。

对低风险、可逆、影响面小的细节,可以降低审查强度;对数据、权限、计费、迁移、鉴权、删除、生产发布等高风险改动,必须重点审查。

5. Keep YOLO, But in a Reversible Sandbox

作为 AI Agent 的管理者(Manager),你要做的是抓大放小,何为大?架构设计、方案设计;何为小?具体的细节操作的命令。保持使用 YOLO 模式(Codex 的 dangerously skip permissions 模式),可以帮助你减少微操。

但是,不是无脑 YOLO。你需要确保即使是 Agent 在 YOLO 模式下发挥所造成的最灾难的状态,你是可接受的。

可逆沙盒至少意味着:代码已经进入版本控制;Agent 工作在独立 branch 或 worktree;没有生产密钥;没有生产数据库写权限;危险操作有备份或 dry run;部署、数据迁移、删除类操作需要人工确认。

工程管理

和 Vibe Coder 不同,作为工程师,我需要交付的是有价值的产品。所以,还是要让工作尽可能的 Under Control,避免 Coding Agent 帮你办离职。

6. Always Use Version Control and Remote Backup

无论你的项目大还是小,都要上一个版本控制工具。可以是 Git ,可以是 SVN,也可以是 hg,但一定要有。你需要让 Agent 始终工作在版本控制工具的范畴内,即使出现了问题,你也能快速回滚。

此外,一定要放在云上,这样即使是最极端的灾难情况 —— AI Agent 删除了你的所有代码,你也可以从云端找回一个历史的版本。

此外,用好 worktree 之类的功能。

7. Small Batches

让 Agent 以功能 、特性为维度小步快跑,而不是一次性憋个大的。这对于要确认的你不友好;对于 Agent 也不友好。模型的注意力也会涣散,也会出现遗漏重点的问题。

小的步骤配合着版本管理工具,可以帮助你更快的迭代,同时,更稳。

8. Protect Production

除非你知道你在让 Agent 做什么,不然不要试图让 Agent 直接操作你的生产环境;如果实在不知道怎么操作,最好的办法是让 Agent 给你一个操作手册,你跟着操作手册去执行,并要求 Agent 解释每个行为的意义和价值。

我猜你不会想删库跑路的吧?

快速反馈

9. Fail Fast & Feedback Fast

尽可能早的报错,不管是代码,还是逻辑;尽早报错可以帮助 AI Agent 更快的发现问题,从而更快的解决问题。而不是到线上才暴露问题。

从这个视角来看,Typed Lang is better than non-typed lang。Golang、Rust、TypeScript 这类有强静态反馈的技术栈,更适合 AI Agent 协作;纯 JavaScript 这种反馈更晚、更依赖运行时和人工约束的方案,会显著增加 Agent 协作成本。

除此之外,为你的 Coding Agent 构建尽可能多的反馈回路,让他除了写代码之外,还可以通过反馈回路来获得反馈,优化自己的代码和实现。这些反馈回路包括:

  • Type Check
  • Lint
  • Format
  • Testing
  • Cyclomatic Complexity

让你的 Agent 在完成工作后,执行这些工具,尽快获得反馈,并自我修复,避免 Bad code smell 进入你的代码仓库。

git hook 就是一个不错的选择:pre-commit 搞定 type check、lint、format;pre-push 搞定 testing 和 Cyclomatic Complexity。

10. Work With CI/CD

尽可能构建你自己的项目的 CI/CD流程,除了本地的 hook 和检查,你还需要更加强制的校验,确保符合要求的代码才能进入你的代码仓库主分支。

确保你的 CI/CD 流程包含测试、e2e、复杂度、覆盖率分析、安全扫描,让你的代码尽可能的安全。

CI 负责阻止不合格代码进入主分支;CD 负责让可发布版本以可审计、可回滚的方式进入环境。

高并发工作

11. Async Work

由于模型的推理和 Agent 的工作需要时间,所以不要和 Agent 同步工作,而是尽可能的和 Agent 异步工作。通过 Plan 功能,前置让 Agent Review 和设计工作,并在确认后,让确认完的 Agent 工作;

这样你可以有效的让你的 Agent 和模型的工作最大化的利用;这里最重要的是让 Agent 可以在过程中一次性把要确认的快速确认完,然后自己可以兢兢业业干半个小时,甚至更久。你只在他需要你的那一刻投注注意力,剩下的时间,安排好你的注意力。

我最近比较喜欢用的是一个大的屏幕上同时开四个 Codex 干活;如果你是 Windows ,可以使用 wmux, mac 下则可以考虑 cmux 。这些都不错。

对了,一个副作用是,你可能会发现,跑了多个 Agent 之后,你会需要一台更强悍的电脑(所以我买了 2026年的 MBP M5 MAX)

12. Parallel Work

和人类不同,Agent 每一个线程都是完全独立的;只要你的 message 是独立清晰的;Agent 是可以并行工作的。而唯一能限制你并行度的,就是你自己对于工作的拆分和理解。

一个比较合理的方案是使用 git worktree 并行开发;同时尽可能避免让多个 Agent 处理同一个模块的事情,减少最后在合并回主分支时冲突的发生。

但是,需要注意,尽量不要跨项目并发工作,你自己的上下文会不足以支撑切换。

13. Sleep Work

对于人类来说,睡眠是一个很好的休息的时间,但对于 Agent 来说,不是的。 Agent 不需要休息,但很显然,休息状态时,你不太可能去跟进 Agent 的决策,确保他的产出是符合你的预期的,所以,你需要一些能够深夜自动工作的任务,从而帮助你利用好你的睡眠时间。

我一般会在深夜让 Agent 做这些事情:

  1. 写测试 & 补全测试:这些事情白天也能干,但白天可能在高频迭代,晚上让 Agent 补测试是个不错的选择。
  2. 代码重构:如果你的项目测试基建是足够好的,那么你的睡眠时间非常适合让 Agent 做自主重构,消解技术债务,帮助你的项目获得整体的高质量。

代码是你的,不是 Agent 的。

14. KISS(Keep it Simple Stupid)

AI Agent 在写代码时,会很容易出现复杂,你无法理解的写法,导致代码对你而言,彻底无法维护。这个是一定要避免的,你需要学着控制你的项目的复杂度,让 Agent 写完后跑 Cyclomatic Complexity 检查,超标必须重构,避免项目过于复杂,导致你无法维护。

即使你的代码是 Agent 写的,更加简单易于理解的逻辑,也会让你获得更好的结果。毕竟,你可能绝大多数的时候都能借助 AI Agent 搞定工作,但最终还是要确保自己有救济途径;可以接管 Agent 的工作。

15. /init, but not only init

无论是 Claude Code 还是 Codex,其实都有 /init 功能,来快速建立 AGENTS.md 和 CLAUDE.md 来帮助你建立一个项目级别的 Profile ,用来引导 Agent 执行;但实际在使用过程中,Agent 生成的文件是无法完整覆盖你对于这个项目的完整定义的。因此,你要学会配合使用不同的层级的 AGENTS.md 来帮助你做好架构。

比如,我会同时使用全局的 AGENTS.md 和 项目级别的 AGENTS.md 来管理我的 AGENT 的行为。我会在全局(~/.codex/AGENTS.md) 中,会加入一些纲领性的指引,比如下面这个例子;

# 基本设定

- 交流使用中文;代码、注释、标识符、提交信息及代码块用 English;技术文档使用 English。
- 处理 Github 相关操作优先使用 `gh` cli。

# 核心原则
- 约束优先级:显式规则 > 正确性/安全性 > 业务边界 > 可维护性 > 性能 > 代码长度 / 局部优雅。
- 在写代码时,你会尽可能多的把可能后续 DEBUG 时所需的日志全部通过日志的方式打印出来,方便后续排查问题;并做好 Level 管理,方便在生产环境时通过 Level 只看最核心的日志。
- 在写代码时,如果你发现单个文件过于复杂或太长,不利于维护,你会适当的拆解合适的模块。

# 表达与风格
- 重点放在设计清晰设计、抽象、正确性、稳定性、性能与可维护性


## 提交与协作

- 提交信息遵循 Conventional Commits:`<type>[optional scope]: <description>`,例如 `feat(repos): add owner filter`。
- 每次执行任务前,都先使用 git pull,确保 main 分支已经是最新。
- 小步提交,完成一个任务后就提交(一个任务的范畴是未来可能一起回滚的),只 stage 自己相关的改动。每次完成任务记得提交;
- 不要提交真实 `.env`、密钥、数据库连接串、OAuth token 或本地私有配置。
- 当前项目会使用 .gitlock 来作为 git 锁;如果你准备 commit ,就要创建一个 .gitlock 文件到项目根目录;如果你 commit 完成,就删除这个文件。如果你准备 commit 时发现有这个文件,就等待 30 秒后再检查直至这个文件删除后再执行 commit
Code language: PHP (php)

然后,在项目级的 AGENTS.md ,我就不会再使用 commits 的约束,并更多的精力放在项目本身的描述上。

以及如果你的项目最近架构发生了变化,记得重新生成 AGENTS.md 文件,避免旧的架构文件错误引导 Agent 工作。

总结

使用 AI Agent 编程,本质上是一次角色转变:你不再是那个逐行写代码的人,而是那个定义目标、划定边界、审查结果的 Manager。

Agent 的能力上限,取决于你给它的上下文质量;你的精力上限,取决于你把注意力放在哪里。

把决策权留给自己,把执行权交给 Agent,把验证权交给工具链。这三件事做对了,你的生产力才真正被放大——而不是被 Agent 带着跑。

代码是你的,不是 Agent 的。

2026 欧洲之旅:在意大利打车

在意大利无法像在其他国家那样使用Uber X等网约车服务,需要下载专门的本地应用。appTaxi在佛罗伦萨覆盖率较高,而ItTaxi适用于罗马等地,范围更广。

计费从司机接单驶向乘客时便开始,上车前可能已有费用产生。司机通过专用设备接单,信息有限,需再次确认目的地。可以使用信用卡支付,前往车站则应提前预约车辆。

看到标题,你可能会好奇,诶?为什么是【在意大利打车】?在意大利打车和其他地方有什么不同么?

是的,不同的。在意大利,你并不能像我们在国内这样方便的使用 App 打车!在法国,你可以直接使用 Uber 打车,但在意大利,不行,你没办法打 Uber X(我们一般意义上的网约车)

https://x.com/i/grok/share/aa3d083c7f8248e58c2e8a47dc837a71

So,如何打车?

想要在意大利打车,你需要下载当地的 App,比如我下载了 appTaxi 和 ItTaxi 这两个 App 来专门打车;

其中 appTaxi主要是在佛罗伦萨比较强,如果你是在佛罗伦萨,那么可能 appTaxi 能够更快的打到车;

而 iTTaxi 我们则是在罗马使用的,他的覆盖范围也会更广一点。

使用注意

单纯 App 倒也没啥,我们可以说一些重要的注意事项

  1. 计费逻辑不同:不管是 appTaxi 还是 itTaxi ,实际上对接的都是当地的专业的 Taxi;他们的计费逻辑是从他们接到你的订单,开始朝你这里开的时候,就会开始计费。所以有些时候你上车的时候,会看到已经有一些费用就是这个原因。
  2. 当地 Taxi 通过专用设备接单:和国内大家普遍使用手机接单不同,当地的 Taxi 往往都是有专用的设备来接单的,就是下图这个设备。你可以看到,里面的信息相当有限,因此,大概率你上车后,要和司机再 Double Check 一下你得目的地。
  3. 可以使用信用卡支付:国外确实信用卡是刚需,你打车也可以使用信用卡来支付,非常方便,不用带太多的现金了。
  4. 如果要去车站,记得提前预约:因为逻辑和司机的量不同,导致你并不一定能很快打到车,如果你要去车站之类的明确有时间限制的地方,那就记得提前预约车辆,并预估大致的时间出发
接单设备

总结

就记得意大利和其他地方不一样~得下载专门的 App 就行~

使用 Docker 部署 Github Actions Self Hosted Runner

近些年来,我的个人项目基本上也是托管在 Github 上的。主要的原因一方面是 Github 身边的 Git Repository 使用起来体感还不错,另一方面,也是很重要的便是 Github 的 Actions。

作为一套开箱即用的 CICD 系统,Github Actions 给所有的 Public repo 提供了免费的运行时长,而对于 Private Repo,则没有那么多;我虽然购买了 Github Pro,每个月有 3000 分钟的额度可以使用,但随着你的项目越来越多,在进行的 CICD 检查越来越多,导致 3000 分钟的额度捉襟见肘,经常月中就没有了。

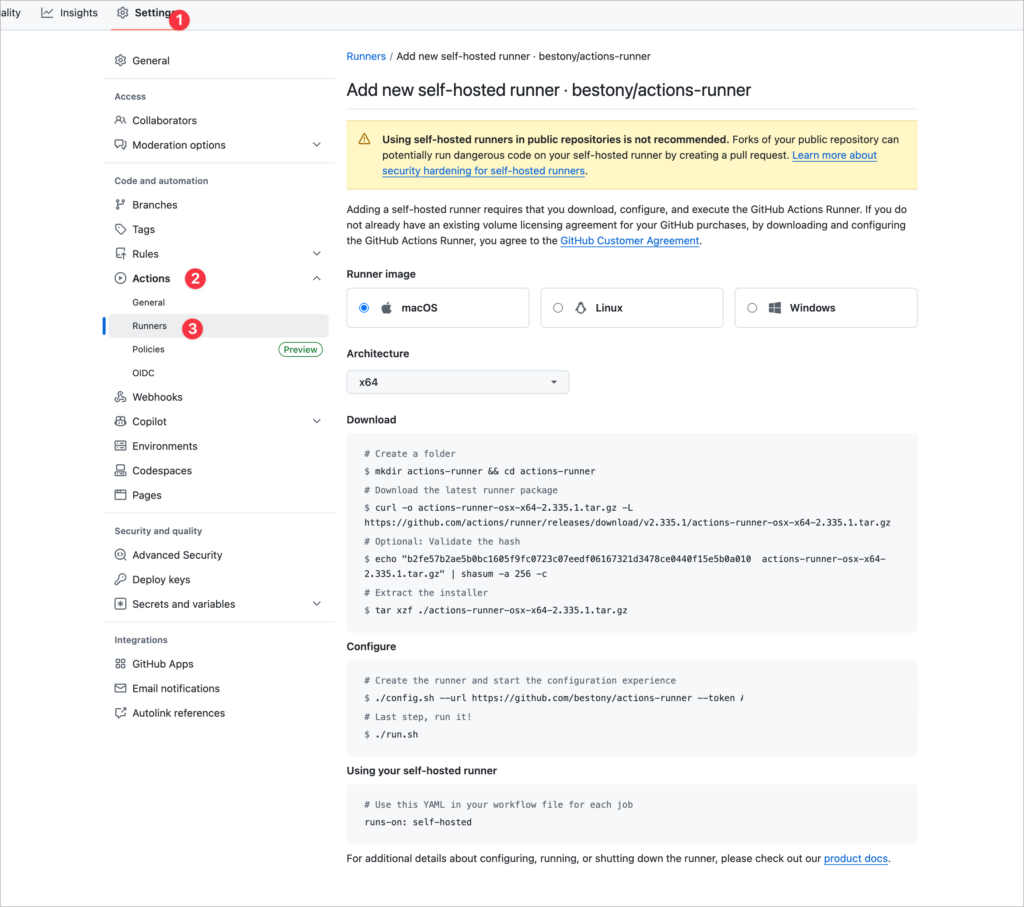
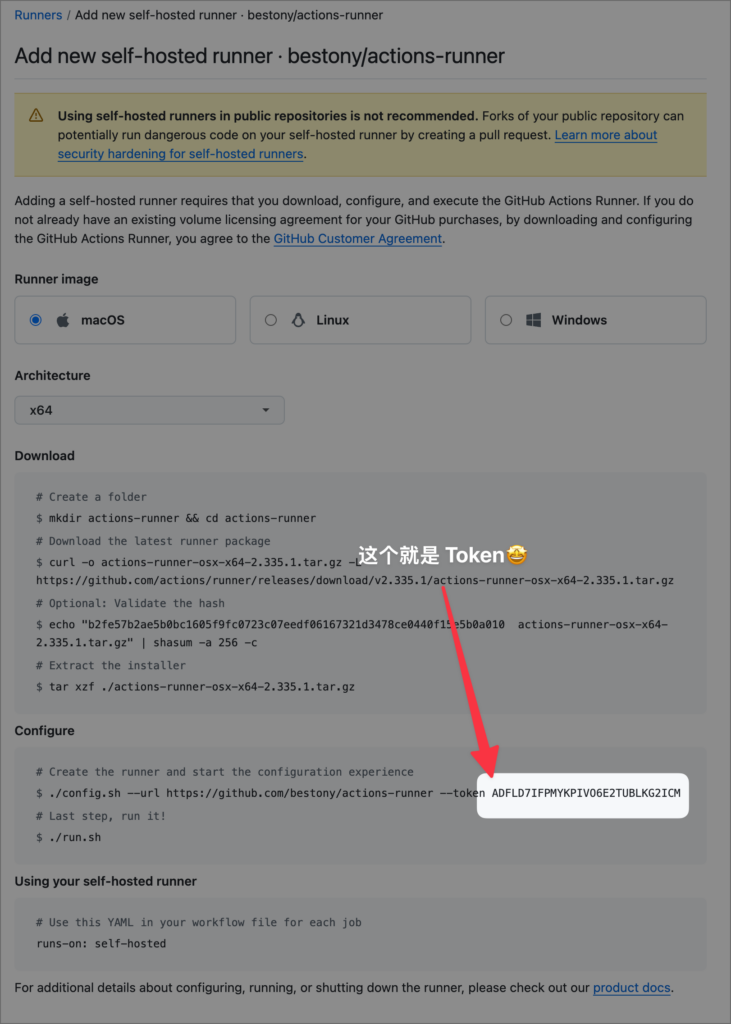
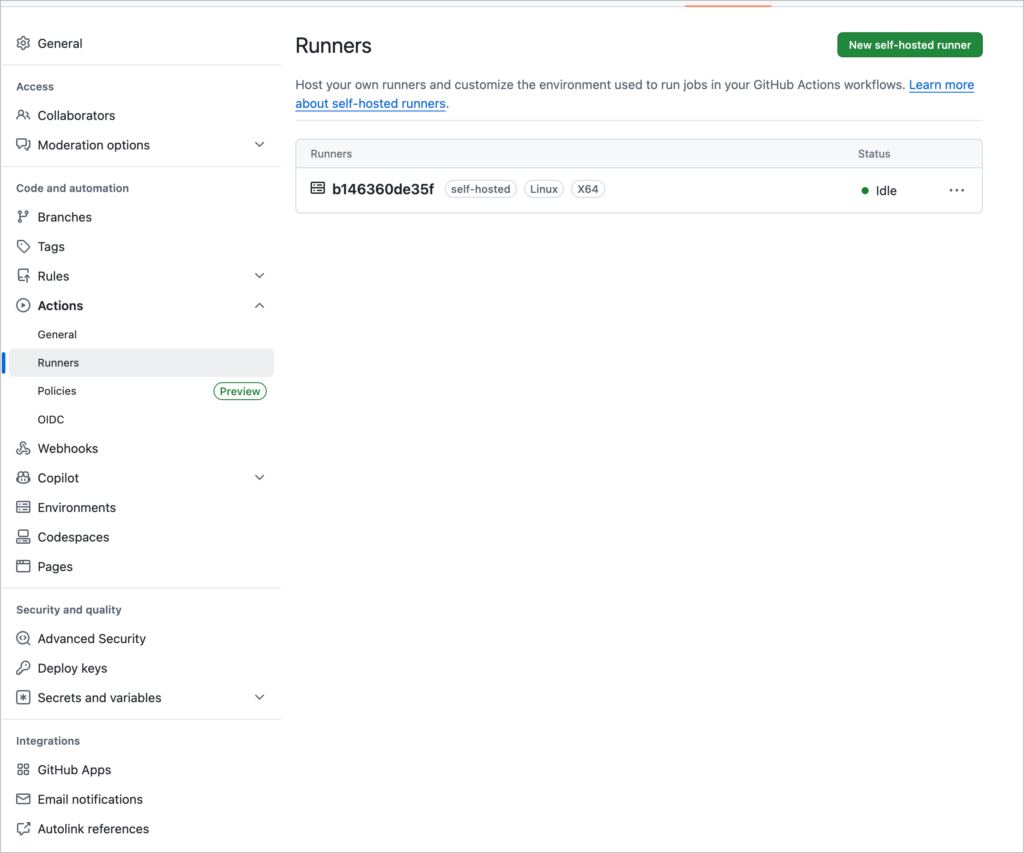
所以,我就瞄上了 Github Actions 的 self-hosted runners。其实如果你有足够的主机,配置起来挺简单的。打开 Github 仓库页面,找到 设置 – Actions – Runner 页面,就可以新增 self-hosted Runner,在新的引导页面,选择你要使用的操作系统,然后跟随下面的指引安装即可,简单易行。

不过,这个方案也有个问题,一台主机只能安装一个 Runner,而一个 Runner 只能工作于一个仓库,对于项目比较多的人来说,还是不方便,所以就有了我研究使用 Docker 化部署的方案,在研究了前人的工作之后,我对这个方案进行了一定的优化,最终形成了你所看到的这个版本。

TL;DR

如果你不想看下面的细节描述,那比较简单粗暴,直接执行下面这个命令,就可以在你的 Docker 服务上启动一个容器作为 Github Actions 的 Self-hosted Runner。

docker run -d \
  --name actions-runner \
  --restart unless-stopped \
  -e RUNNER_URL=https://github.com/<owner>/<repo> \
  -e RUNNER_REGISTRATION_TOKEN=<token-from-config-sh-command> \
  -v /var/run/docker.sock:/var/run/docker.sock \
  bestony/actions-runner:latest
Code language: Bash (bash)

其中,第四行的 Runner URL 是指你自己的 Github 的仓库地址,直接配置上就行;

而第五行的 Token 则是你在 Runner 指引页面看到的 Config 的 Token

当你执行完成后,2-3 分钟,就可以在 Github Actions 设置页面的 Runner 看到刚刚启动的 Runner 了。

接下来,就是在你所有要使用 self-hosted runner 的 job 上,修改他对应的 run-on 配置即可

# Use this YAML in your workflow file for each job
runs-on: self-hosted
Code language: YAML (yaml)

支持哪些平台

我在代码层面支持了 Linux 和 Windows ,并预打包了对应的 Docker 镜像。Linux 使用的是 Ubuntu 24.04;Windows 使用的是 Windows 2022;此外,支持了 Linux的 x64,arm x64 和 arm v7, 如果你是本地 NAS 使用,应该也可以跑。不过我自己还没测试 ARM 的环境,如果你遇到问题,也可以直接提 issue 来反馈。

打包好的 Docker 镜像放在 https://hub.docker.com/r/bestony/actions-runner ,你可以在 DockerHub 页面上看到。

原理是什么?

这个实现的原理本质上就是借助 VM 的 Container 机制,将 Github Actions 的 Runner 二进制文件放在 Docker 镜像中,并通过托管 Docker Socket,来实现让容器内的 Runner 文件可以管理 Docker 容器,从而在后续执行 Job 的时候,创建对应的容器。

代码在 https://github.com/bestony/actions-runner (欢迎来 Star)

配置缓存

Github Actions 提供了缓存能力,从而可以让不同的 job 和 不同的 run 可以使用相同的缓存,减少一部分缓存的时间和成本。 Self Runner 如果想要使用缓存,并让后续的 Runner 都可以使用缓存,你可以这样配置。关于缓存服务的自部署的更多信息,你可以参考 GHA Cache Server 的文档

创建一个网络

首先,你需要创建一个 Runner 专属的网络,从而让所有的 Runner 共享一个 Cache Server,方便后续使用。比如我们这里创建一个名为 Runner 的网络

docker network create runner

启动一个 Runner

当你已经有了提前创建好的 Repo 后,就可以根据需要来创建 Runner 了。你可以直接复制我下面的这段配置,存储成为 DockerCompose.yml ,修改环境变量配置,并使用 docker compose up -d 命令来启动,从而创建一个 Runner ,并启动相应的缓存服务器,来实现启动一个带缓存的 Runner。

services:
  runner:
    image: bestony/actions-runner:latest
    restart: unless-stopped
    env_file:
      - path: .env
        required: false
    networks:
      - runner
    environment:
      RUNNER_URL: ${RUNNER_URL:-}
      RUNNER_REGISTRATION_TOKEN: ${RUNNER_REGISTRATION_TOKEN:-}
      REPO: ${REPO:-}
      TOKEN: ${TOKEN:-}
      ACTIONS_RESULTS_URL: ${ACTIONS_RESULTS_URL:-http://cache:3000/}
      RUNNER_NAME: ${RUNNER_NAME:-}
      RUNNER_LABELS: ${RUNNER_LABELS:-}
      RUNNER_WORKDIR: ${RUNNER_WORKDIR:-_work}
      RUNNER_EPHEMERAL: ${RUNNER_EPHEMERAL:-false}
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock
    deploy:
      mode: replicated
      replicas: ${RUNNER_REPLICAS:-4}
      resources:
        reservations:
          cpus: "${RUNNER_RESERVED_CPUS:-0.5}"
          memory: ${RUNNER_RESERVED_MEMORY:-1024M}
        limits:
          cpus: "${RUNNER_LIMIT_CPUS:-2.0}"
          memory: ${RUNNER_LIMIT_MEMORY:-4096M}

  cache:
    container_name: cache
    image: ghcr.io/falcondev-oss/github-actions-cache-server:latest
    restart: unless-stopped
    networks:
      - runner
    ports:
      - "3000:3000"
    environment:
      API_BASE_URL: http://cache:3000
    volumes:
      - cache:/app/.data

volumes:
  cache:

networks:
  runner:
    external: true
Code language: YAML (yaml)

上面这段配置主要有几个核心配置需要关注:

  1. deploy 段:这部分主要是你会跑多少个 Runner,如果你的项目需要更多的 Runner 来执行 Job ,这里就可以调整的大一些;包括每个 runner 预约多少资源,能实际使用多少资源,都可以配置。
  2. networks 段:这部分核心是要使用之前创建好的 Runner 的网络,从而让后续的所有的 Runner 都统一使用一个网络。

启动一个新的 Runner

当你完成上述的配置,但发现你需要一个新的 Self-hosted Runner 的时候,就可以复制下面不包含 Cache Server 相关的配置,直接使用了。非常的方便


services:
  runner:
    image: bestony/actions-runner:latest
    restart: unless-stopped
    env_file:
      - path: .env
        required: false
    networks:
      - runner
    environment:
      RUNNER_URL: ${RUNNER_URL:-}
      RUNNER_REGISTRATION_TOKEN: ${RUNNER_REGISTRATION_TOKEN:-}
      REPO: ${REPO:-}
      TOKEN: ${TOKEN:-}
      ACTIONS_RESULTS_URL: ${ACTIONS_RESULTS_URL:-http://cache:3000/}
      RUNNER_NAME: ${RUNNER_NAME:-}
      RUNNER_LABELS: ${RUNNER_LABELS:-}
      RUNNER_WORKDIR: ${RUNNER_WORKDIR:-_work}
      RUNNER_EPHEMERAL: ${RUNNER_EPHEMERAL:-false}
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock
    deploy:
      mode: replicated
      replicas: ${RUNNER_REPLICAS:-4}
      resources:
        reservations:
          cpus: "${RUNNER_RESERVED_CPUS:-0.5}"
          memory: ${RUNNER_RESERVED_MEMORY:-1024M}
        limits:
          cpus: "${RUNNER_LIMIT_CPUS:-2.0}"
          memory: ${RUNNER_LIMIT_MEMORY:-4096M}

networks:
  runner:
    external: true
Code language: YAML (yaml)

总结

如果你和我一样,喜欢用 Github,但又没有足够多的 Github Actions 运行时长可用,或者你需要依赖一些你自己的内网环境,那么这个 self-hosted runner,就是为你准备的。

UniGetUI —— 可能是 Windows 下最好用的应用商店

UniGetUI 是一款为 Windows 提供图形界面的包管理器聚合工具。它整合了 Winget、Scoop、Chocolatey 等多个包管理器,能够集中管理软件的安装、更新和卸载。

该工具支持创建软件捆绑包,便于批量部署或恢复个人工作环境。它通过统一的界面简化了多包管理器环境下的软件管理流程。

和 macOS 一样,Windows 也提供了一个应用商店,但和 macOS 不同的是,很多 Windows 下的软件是不会选择通过应用商店来进行分发的,所以在过去很长一段时间里,我们需要使用各种各样的包管理器来管理我们的软件,比如 Scoop、Chocolatey ,或者是直接上软件的官网,下载安装。

因为这样的需求,我们看到在中国的市场上出现了各种各样的软件管家 —— 比如 360 软件管家、火绒软件管家、腾讯应用宝。但这些软件背后的商业公司的利益或者是本身只管理通过其自己安装的软件,导致使用的时候也不是很完美。

终于,让我发现了一个接近完美的应用商店 —— UniGetUI。

UniGet UI 是什么?

严格来说,UniGetUI 并不是一个应用商店,它其实是一个为 Windows 10 & Windows 11 的常用包管理器提供了 GUI 的软件工具。而得益于他支持的包管理器足够多,所以你几乎可以将它当作「应用商店」及软件管理软件来使用。

作为一个包管理器的 GUI 实现,他提供了 Windows 近年来正火的 WinGET、老牌包管理器 Scoop 和 Chocolaty,同时也针对 Windows 下的 Powershell 5 和 Powershell 7 提供了相关的包管理器;针对编程用户常用的 NPM、PIP、Cargo 和 VCPKG 也有涉猎;虽然能力不完全对其,但最基本的安装管理和卸载等能力都是有的。

图片来源:https://github.com/Devolutions/UniGetUI/#package-managers

这些包管理器的上游来源组合在一起,基本上可以覆盖你的所有日常软件使用了你电脑上的 90% 以上的软件应该都可以找到了。

如何使用 UniGetUI?

安装 UniGetUI

UniGet UI 安装的方式有多种,你可以选择直接在 Microsoft Store 中安装。但如果你的 Microsoft Store 和我的一样,时常抽风,也可以考虑使用 Winget 、Scoop 、Chocolatey 来安装。甚至是直接下载安装包,作为你的安装入口(就和我装 macOS 一定先装 Homebrew 一样)。

https://github.com/Devolutions/UniGetUI/#installation

安装软件

当你安装完成后,接下来就比较简单了,直接打开软件,进入发现软件包,搜索你要使用的软件即可;

搜索完软件后,你可以点击,并在弹出的窗口中,查看对应软件的描述信息,了解这个软件是否是你需要的,并进行安装。

不过,你可能会发现,诶,为什么我搜索到的软件不如你的多?这是因为 UniGet UI 毕竟是一个包管理器的 UI,他所能安装的软件的选项取决于你的电脑上有哪些包管理器。默认情况下,你的系统里会自带 WinGet ,所以你搜到的都是 WinGet 当中的软件包。如果你需要更多的软件,则需要你安装更多的包管理器,并开启相关支持。

更新软件

当你安装了一些软件后,接下来的每日日常就是更新软件和管理软件,在 UniGetUI 当中,这件事也变得非常简单,只需要点击左侧的菜单,软件会自动查询对应的软件版本和你已经安装的软件,并可以根据自己的需求,选择你需要的软件,对他们进行更新或者卸载。然后他们的进展会展示在底部的队列中,一个接着一个处理(当然,你也可以修改配置,来提升并发度)。

封装软件捆绑包

除了上面的安装、 更新、卸载软件之外,我觉得 UniGetUI 有一个不错的功能就是制作软件捆绑包 —— 顾名思义,这是一个帮助你将一批软件形成一个 Bundle 的能力。有了这个能力,就可以非常方便的创建出你自己的软件组合。

这样对于有自己习惯的人来说,可以维护一个简单的软件 Bundle,并不断更新这个 Bundle,这个 Bundle 将会在你下次 Setup 你的电脑的时候,作为一个非常方便的快速的包,来完成初始化。

当然,也可以是你根据需要,创建不同的 Bundle 组合,去给到他人来进行安装。

除了和 UniGetUI 强绑定的 软件 Bundle,UniGetUI 还支持导出一个 Powershell 脚本。

安装脚本还是完全和 UniGetUI 无关的,意味着你可以只交付这个 Powershell 脚本,来交付你的软件包组合,可以减少你交付时的门槛(用户不用再装 UniGetUI 了,不是么)。

总结

总体来说,我觉得 UniGetUI 是一个不错的包管理器,它提供的统一的更新UI,可以帮助你确保软件都是最新的;同时,聚合了多个包管理器后,可以让你得软件最大程度的集中在一起管理,而减少视野之外的软件。同时,其自带的软件捆绑包则给这个软件提供了更多的可能性,除了用于自己的管理,还可以是用于团队管理、业务交付、软件开发环境构建等等一系列需要批量配置一批软件的场景。

干的不错!