分类目录归档:产品

Claude Tag 产品分析

Claude Tag 这个产品市面上的仿品很多,但我看到的绝大多数的产品仿品仿其型而未有仿其神。这背后是本身绝大多数仿品的团队都是 TO C 创业者出身,导致对于他们来说,并未看出背后的很多设计的原因。而作为一个真的干过 TO B 的产品经理,我觉得大家其实做的都还是 TO C 的产品,由于实在看不过眼(觉得在座的都是垃圾),我决定自己写一篇对于 Claude Tag 的拆解,方便大家参考和使用。

对于 Claude Tag 来说,其神在于:

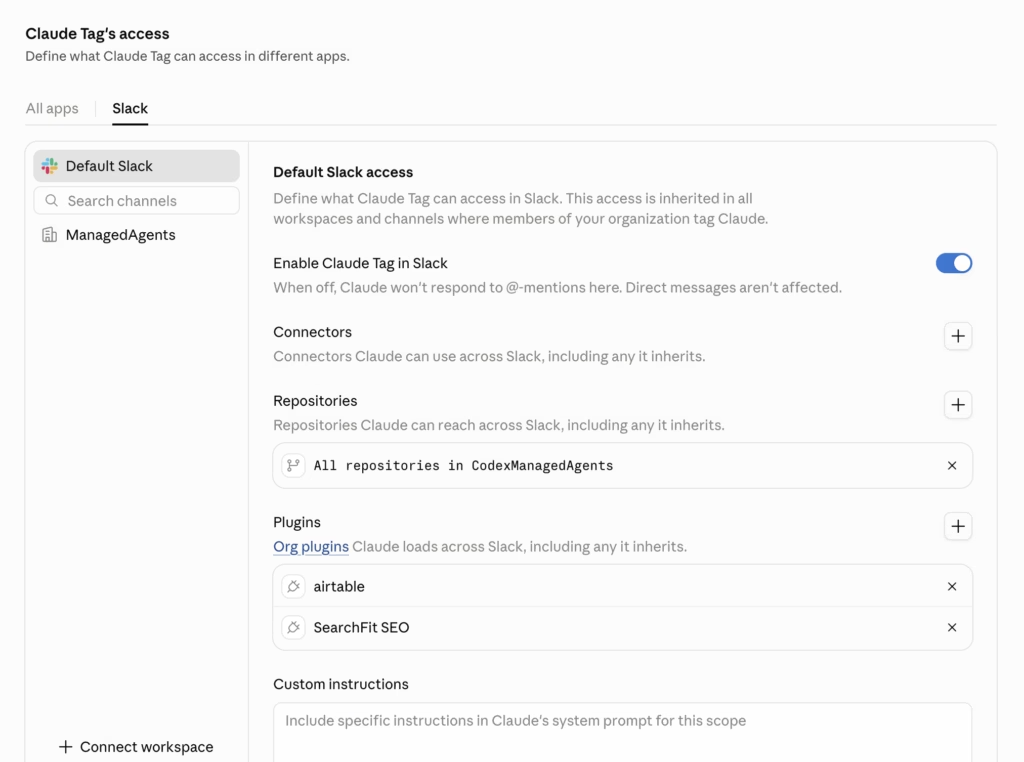
  1. 访问按地方配,不按人配。 配置的单位是 scope——整个组织(Default Slack access)、一个 Workspace、一个 Channel——Access Bundle 挂在 scope 上,往下继承;一个 Channel 拿到的是它自己、它的 Workspace、组织三层 Bundle 的并集
  2. 记忆跟地方走,不跟人走。 Memory 只有两层:Public Channel 里产生的记忆在整个 Workspace 内共享,Private Channel 只读共享层、写自己那一份;
  3. 用组合来在不同地方配置 Agent。你可以通过组合 Access Bundle, 在不同的位置,给 Agent 组合出各种用法的能力,从而让 Agent 真正解决问题。

如何开通 Claude Tag

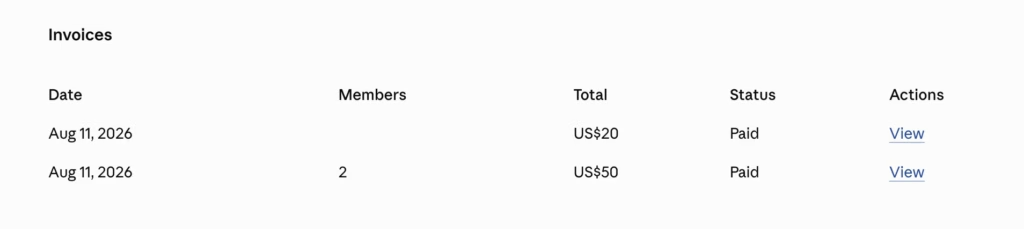
花钱就行,50 刀起步;我花了 70 刀;50 刀是用来开 Claude Teams 权限;剩下 20 刀是 Claude Tag 日常消耗的(我觉得对于很多小公司来说,Claude Tag 的一大痛点可能在于成本太高,因为不是按照订阅算的 Token,而是按照真实的消耗算的 Token,那你可能真的得思考,我真的有必要上 Claude Tag 么?以及会考虑选择使用更便宜的 Sonnet 模型作为 Claude Tag 的主模型)。
Claude Tag 怎么使用

比较简单粗暴,当你完成 Claude Tag 连接之后,接下来直接 at Claude 做事就行;过程中可能会涉及到你要去做一些前置授权等。
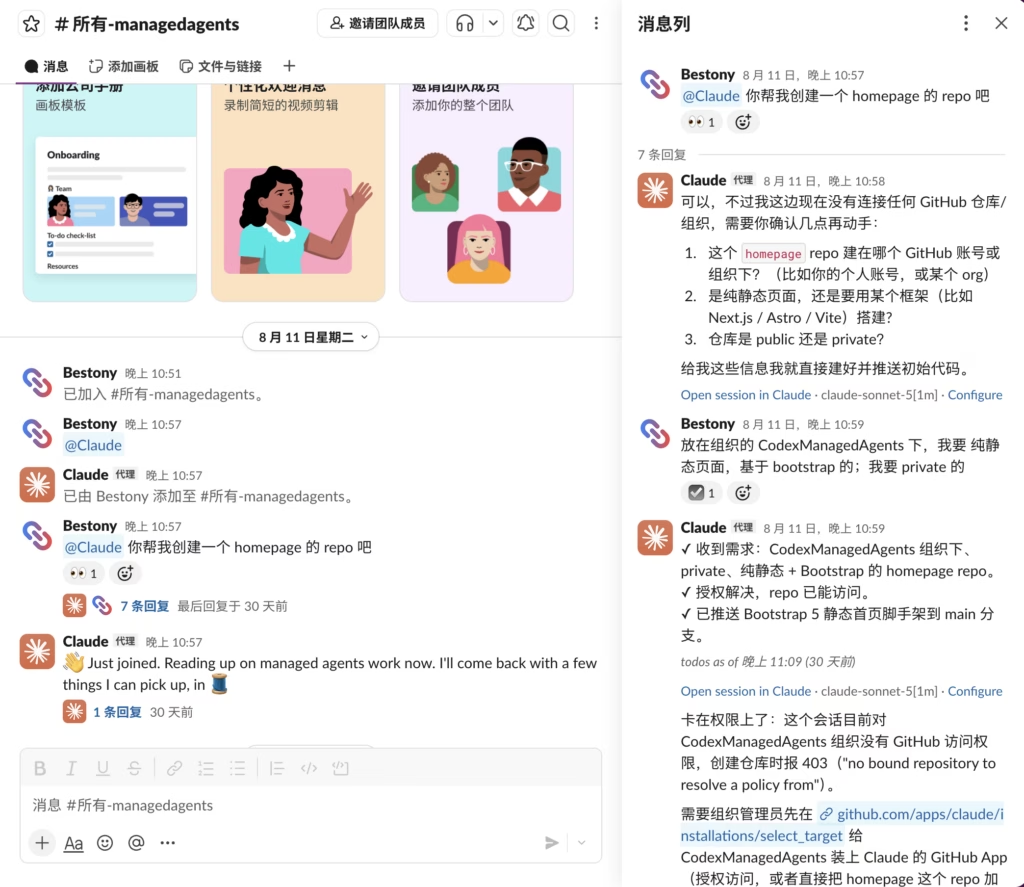
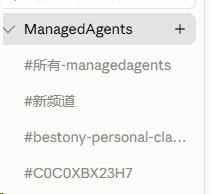
但需要注意的是,目前 Claude Tag 的所有使用必须放在 Channel 中进行;私聊是无法使用 Claude Tag 的,它只能在 Channel 中使用,你需要把它放在任何一个 Channel 中使用;不过好在是,我测试了,其实你可以在 Private Channel 中使用 Claude Tag。所以你依然可以和他一起工作。只是 Private Channel 会在管理后台看不到 Channel Name
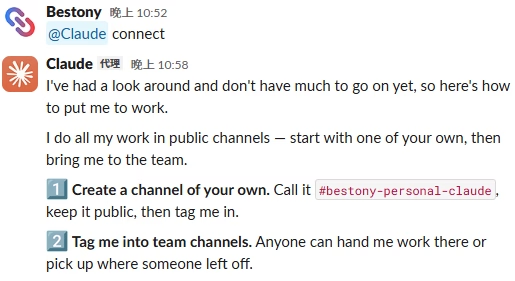
私聊 Claude Tag 的响应
看不到名字的 C0C0 隐藏频道

Claude Tag 产品原语

在看 Claude Tag 的细节功能上,我们需要先理解 Claude Tag 的产品原语,以便于我们对齐对于 Claude Tag 的理解,并且让你对于 Claude Tag 的产品理解有一个更加形象的认知,避免快速沉浸到产品的具体功能细节里。同时也更好的帮助理解不同功能的服务层级。
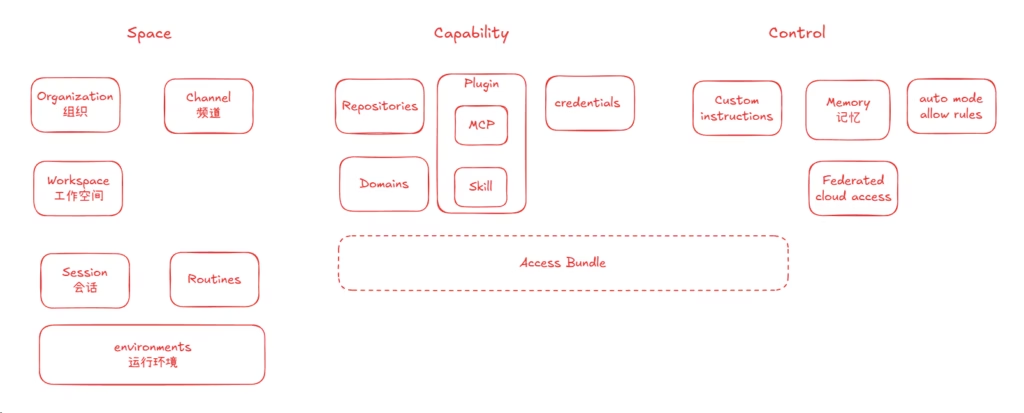
整个 Claude Tag 从产品原语上,你可以定义包括三个大类:Space(任务和行为发生在哪)、Capability(能执行和发生什么样的任务)、Control(如何控制这些任务的发生)。

Space 又可以进一步细分为 Organization、Workspace 和 Channel,后两者可以直接对应到 Slack 的相同概念(Claude Tag 如今还是和 Slack 有较深的绑定),且 Channel 是会话中的最小单元。和 Slack 一一对应可能是源自 Claude 团队自己在用,所以也就没做更多其他品类的兼容。Session 和 Routines 则是会发生在这些 Space 中的具体的会话;Session 是由人类触发的行为,而 Routines 则是由 时间触发的行为。底部的 Environment 则是两个 Session 的运行环境;

Capability 则可以细分为四个子类:Repositories、Domains、Plugin、Credentials ; Repositories 可以提供让 Claude Tag 访问的权限,你可以同时链接多个不同 Github Org 的多个 Repo,从而让 Agent 可以在多个 Repo 中协作。Domains 则给 Claude Tag 了网络访问权限, 通过 Domains 的配置,让 Claude 可以访问到目标的网站,从而获取到必要的信息,从而确保 Agent 的网络行为是可管控的,避免出现信息异常出网的情况。credentials  则提供了不同 SaaS 服务的链接能力,在完成授权后,Agent 会获取到对应的授权,以及一些预制好的 API 请求方式,从而你可以让 Claude Tag 在整个过程中,可以访问到一些外部的 SaaS,从而搞定所有的工作。Plugin 则是一个我们大家相对熟悉的概念,之前在 Claude Code 当中就有,Claude Tag 使用的 Plugin 基本上是一致的;不同的是 Claude Tag 不会执行其中的 Hook,但对于 Skill 和 MCP 都是完全支持的。

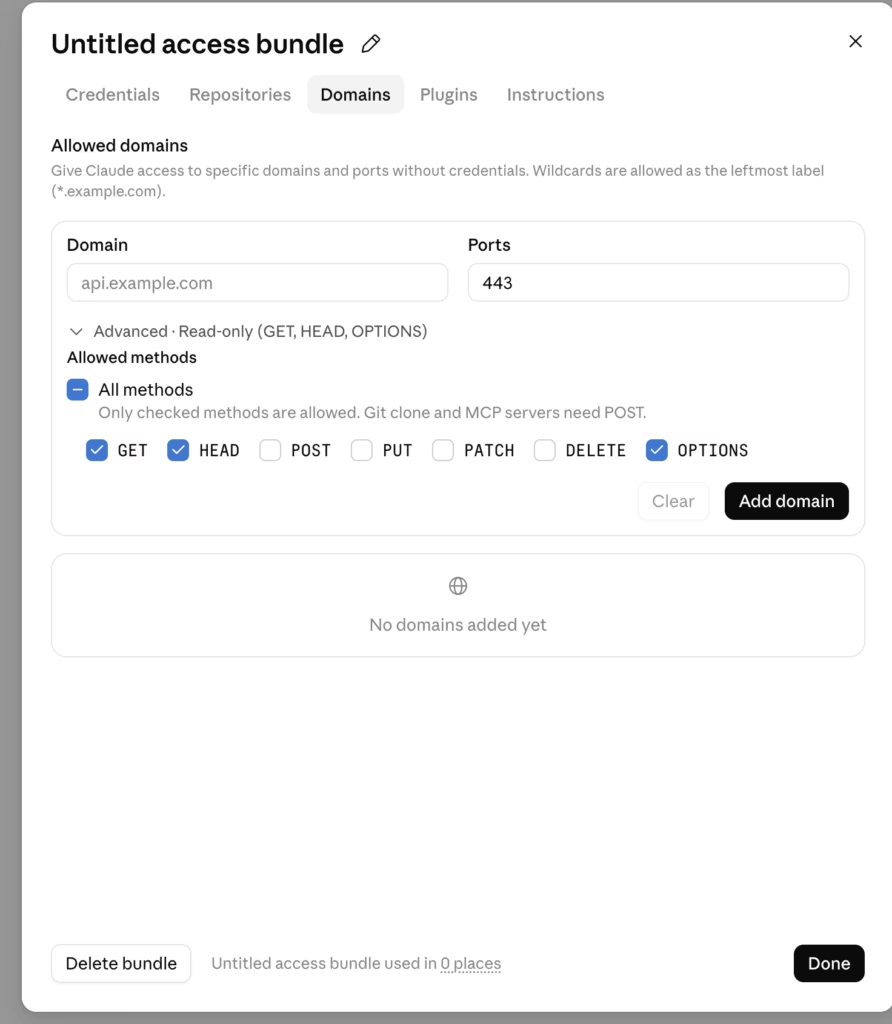
在 Capabilities 最下方,还有一个虚线的 Access Bundle;Access Bundle 是一个 Capabilities 的打包合集,其中包含了Repositories、Domains、Plugin、Credentials、Instructions。你可以在某个 Channel 中找到专属的配置,也可以直接添加一个 Access Bundle,来批量管理这些内容;从而,你可以非常快速的将一组预设好的 Access Bundle 给应用到某个特定的 Channel 上。从而快速完成不同 Channel 的配置。这里有一个特殊的是,Instruction 也是可以放在 Access Bundle 当中一起传递的;不过在产品的原语中,我将他放在了 Control 中。所以这里 Access Bundle 横跨了 Capabilities 和 Control。

在 Control 中,则汇聚了各种对于 Agent 的控制能力(aka:让 Agent 更好的做事),这里包括了我们刚刚提到的 Custom Instruction、Memory、Auto mode allow rules、Channel name rules、Channel name rulesd等一系列细节产品功能,这里比较重要的是 Custom Instruction 和 Memory。Custome Instrucion 会出现在 Org、Channel 级别的配置当中,对应的描述会出现在 Agent 的 System Prompt当中,引导 Agent 行为。Memory 则记录了你在和 Agent 之间的交互中产生的信息,支持频道级别的 Memory 和 全局的 Memory ,从而可以实现一些很有意思的用法(比如 Claude Tag 宣发中的一个 Case: 不同用户在不同 Channel 中和 Claude 聊同一件事,Claude Tag 会主动告知另外一个用户所做的决策)。其他我们就不再专门讲述,稍后会按照具体的功能细节时再说。

当你了解了 Claude Tag 的产品原语、定位和他们之间的关系之后,我们就可以来看看他的一些底层设计机制和数据状态了,能帮你更好的理解后续的一些功能设计。

Claude Tag 的一些数据设计
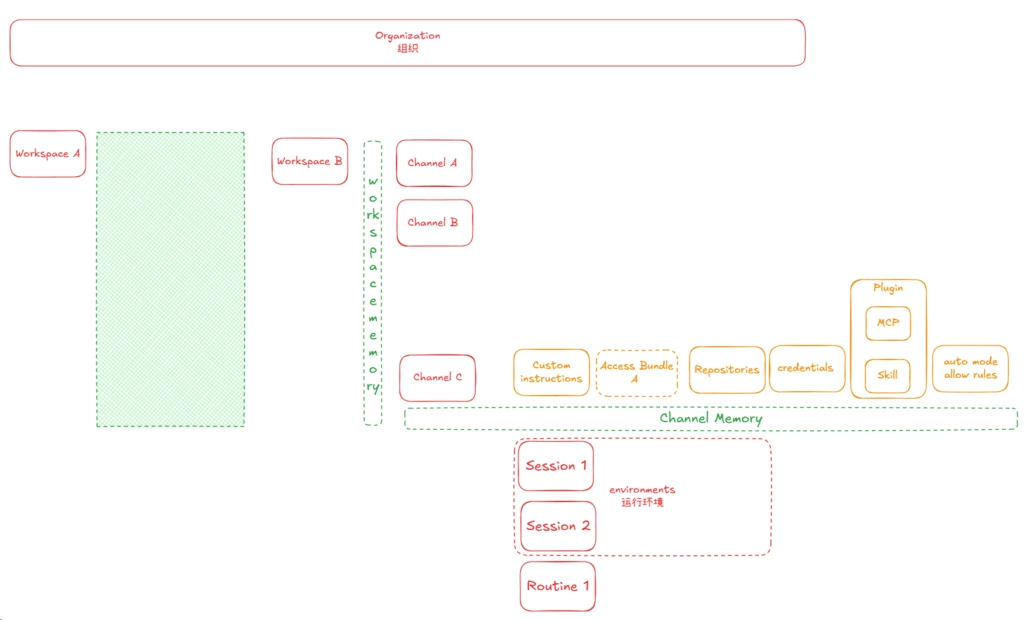
对于整个 Claude Tag 来说,你可以认为数据大概是这个样子的。

  1. 所有的数据都归属于某个特定的组织;组织下可以拆分多个不同的 Workspace(就像你可以是 Openai + 对应的 FDE 组织)。图的上部
  2. 每个 Workspace 里可以有一整套独立的 Channel、Memory 等机制;图的中左部。
  3. 当你进入到每个 Workspace 之后,你会看到 Workspace 内部的 Memory(工作区级别的),然后里面可以有不同的 Channel 来进行日常的沟通和不同工作的分配。比如有的做 A,有的做 B;有的做 C;大家分布在不同的 Channel 里;图的中下部
  4. 每个 Channel 中有自己的 Channel Memory 、Custom Instruction、Access Bundle、Plugin、Credentials、Repository 等一系列 Agent 运行所需要的信息。用户可以根据自己的需要选择合适的内容。图的中右部。
  5. Channel 内部,会同时出现多个 Session 或 Routine。且由于存在自定义 Environment 的能力,可能会出现部分运行在 Anthorpic 的 Runtime 里,部分运行在用户自建的 Runtime 里。

上面的这种数据组织方式,很好的满足企业对于数据的管理诉求:

Claude Tag 的一些产品设计细节

围绕这上述的产品原语、产品数据设计;和面向 To B 的产品设计,里面出现了大量很符合 To B 产品直觉的产品设计。

  • Claude Tag 是组织买给你的,所以组织、Workspace、Channel 当中,都要能够给你的 Channel 设定不同的 Custom Instruction,从而确保你在使用 Claude Tag 做应该做的事情。正常情况下时按照顺序一层层拼接。
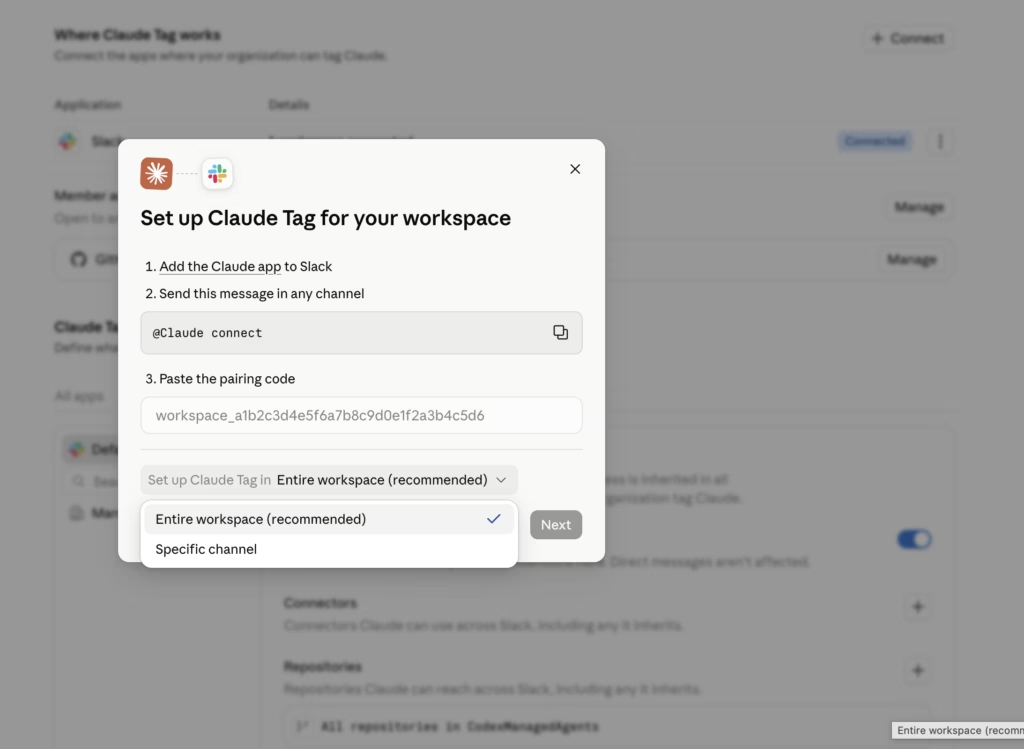
  • 一个公司可能会存在不同的部门和分公司;不同的产品团队也可能会使用不同的 Slack Workspace ,从而更好的做好权限管控。因此,要支持一个 Claude Tag 能连接多个 Slack workspace。
  • 一个 Agent 想要完整的完成一系列工作,不是简单的 Prompt 、Skill 就能解决,依赖MCP、鉴权、Skill和一定的指引。如果一个 Agent 要被持续复用(比如做客服 Channel 用),那么提供一个打包的 Access Bundle 就是必要的。
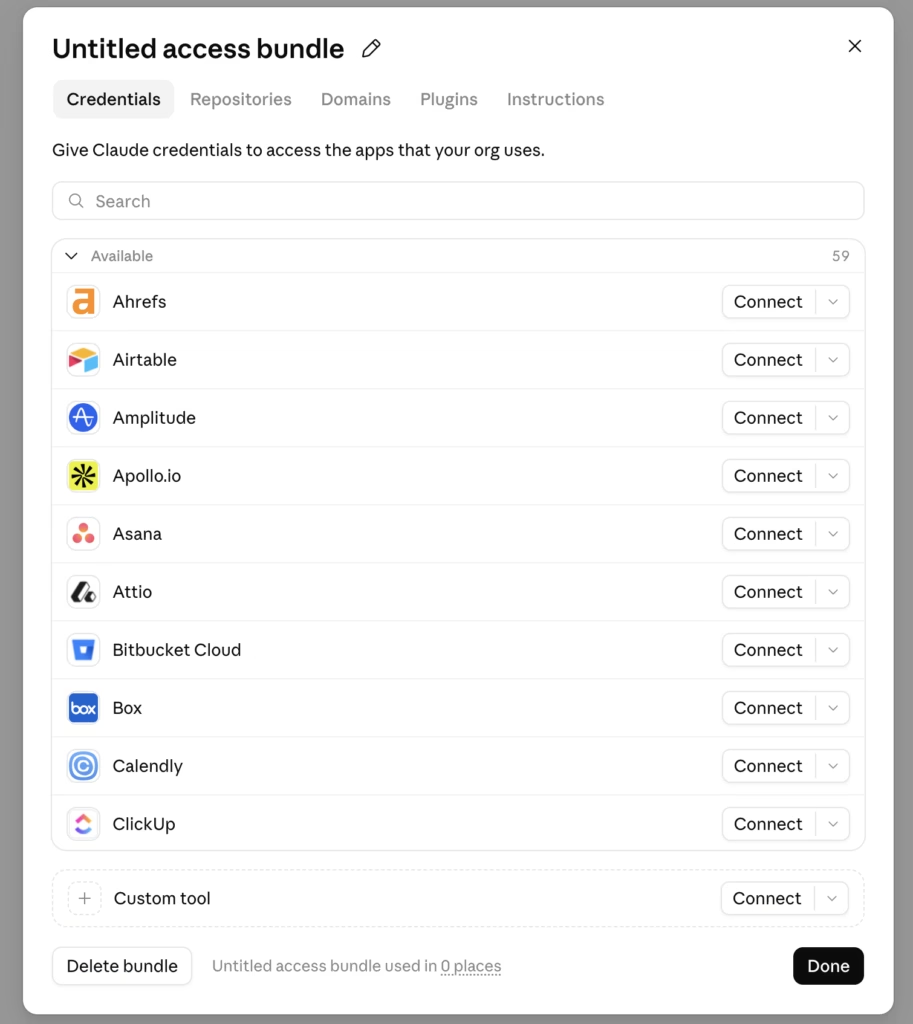
  • 由于每个 Channel 都不是从 Day 1 就开始思考 Access Bundle,和目前这种 Channel 中除了 Access Bundle 还能单独配置 Credentials(在单独Channels 里叫 Connector )、Plugin 的能力,我猜测大概率他们是先有 Channel 级别的单独配置,后面共享多了,干脆提供了单独的 Acess Bundle。目前已经出现每个 Channel,很快可能就会去掉 Channel 级别的配置,直接改 Channel 上的默认的 Acess Bundle 就行。
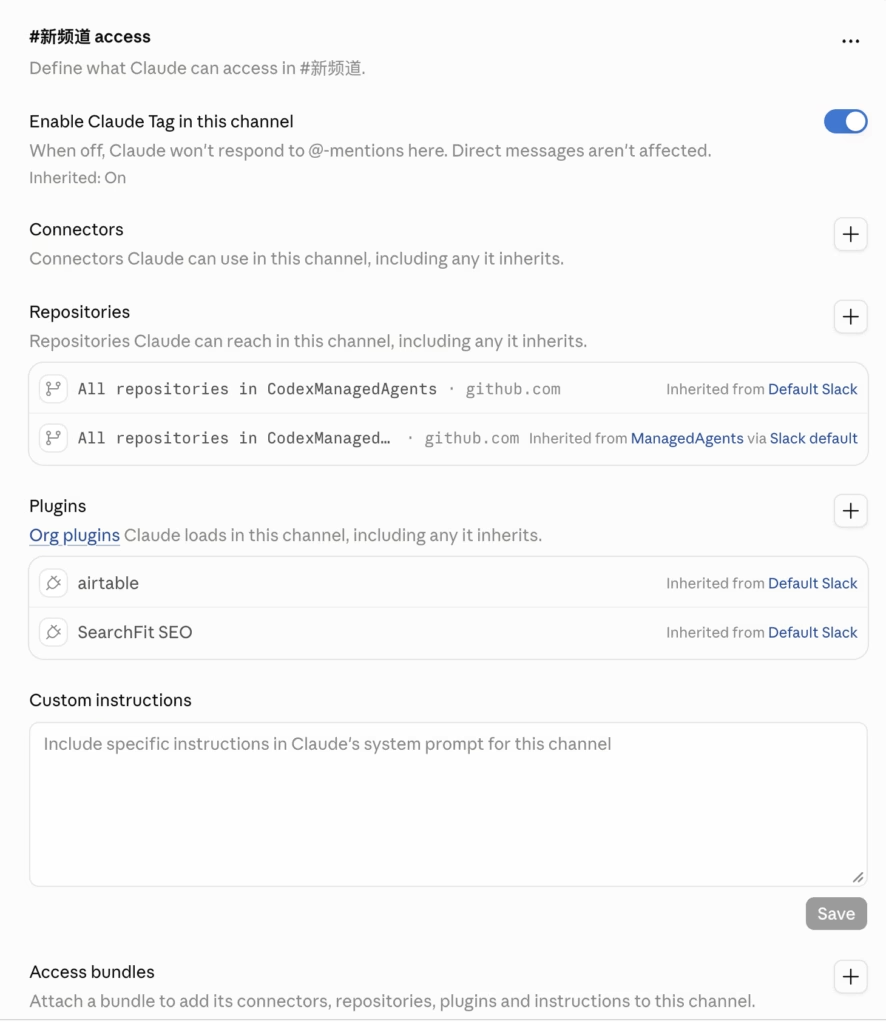
  • 在让 Agent 工作时,会涉及到一个 Agent 可能有多种职能,因此允许 Access Bundle 的叠加
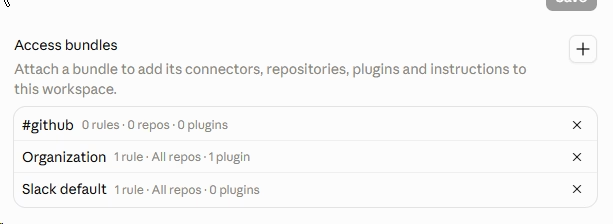
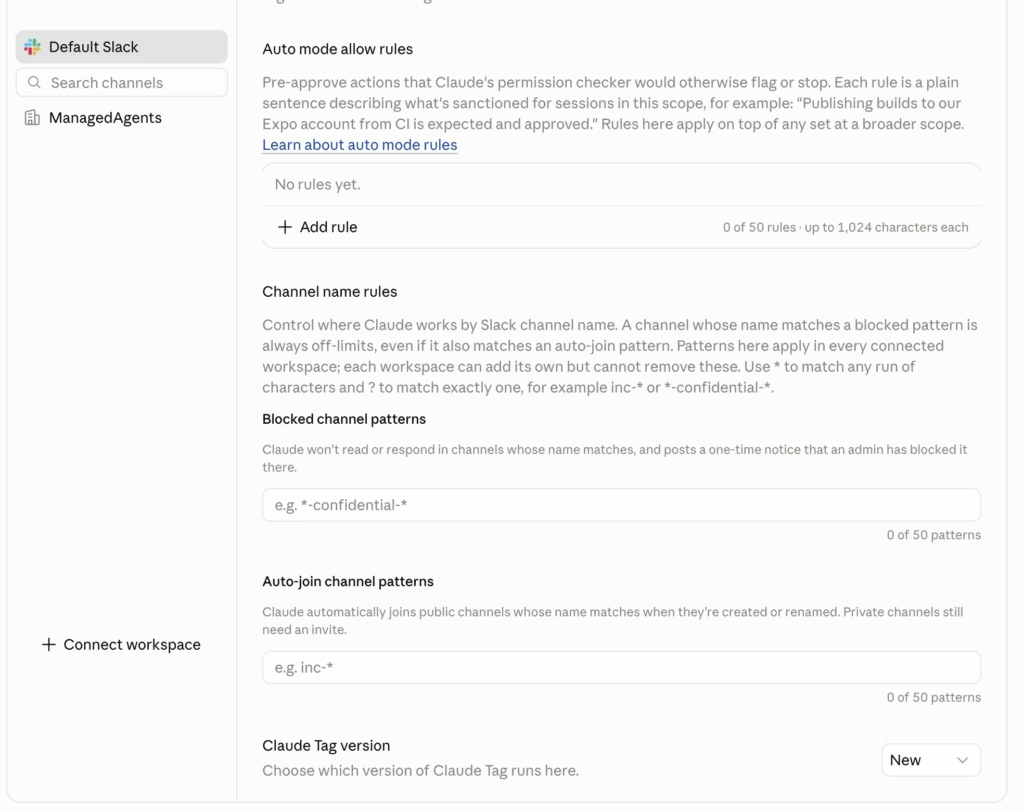
  • 由于在 Slack 的对话式交互中,进行权限审批是一个复杂和不好判断的事情,因此,设计了 Auto mode allow rules,允许用户根据需要,写一些简单的规则,来让 Agent 自己进行 Auto mode 下的判断。一方面相信 Agent 的能力;另一方面,也给了企业足够的控制权。对于 Claude 还不擅长的业务领域,提供了足够的逃生空间。
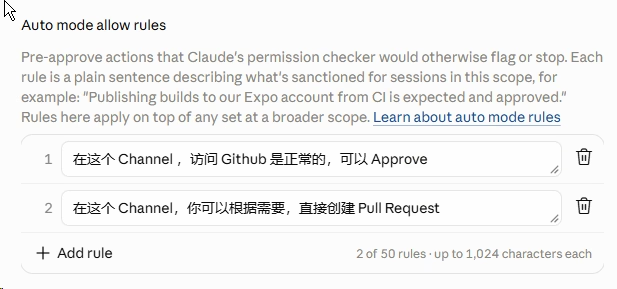
  • 因为要把 Claude Tag 用在对外客服,因此支持 Claude Tag 被 Guest 访问;但对于不把 Claude Tag 用作客服场景的企业来说,可以直接关掉这个 Feature。
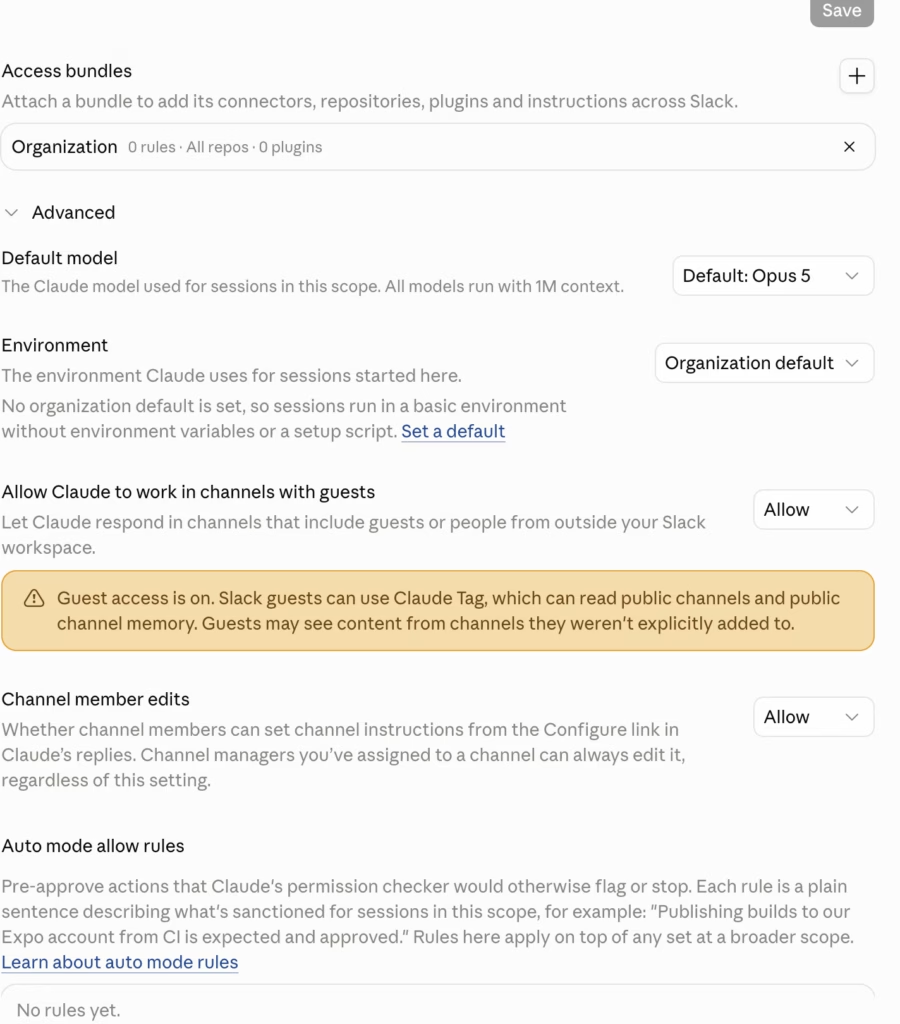
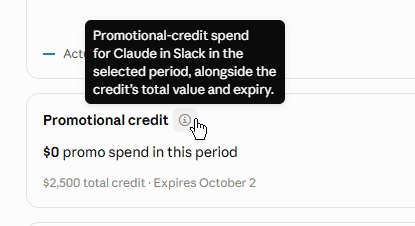
  • Claude Tag 似乎改了一次计费逻辑;在上个月我刚开通的时候,是你充值多少用多少;上个月两个任务花了我 $10 ;我赶紧把默认模型改成了 Sonnet 5 ;但今天写这个 Blog 的时候发现,似乎也变成了 Credit 的机制。如果是这样的话, Claude Tag 还蛮香的。
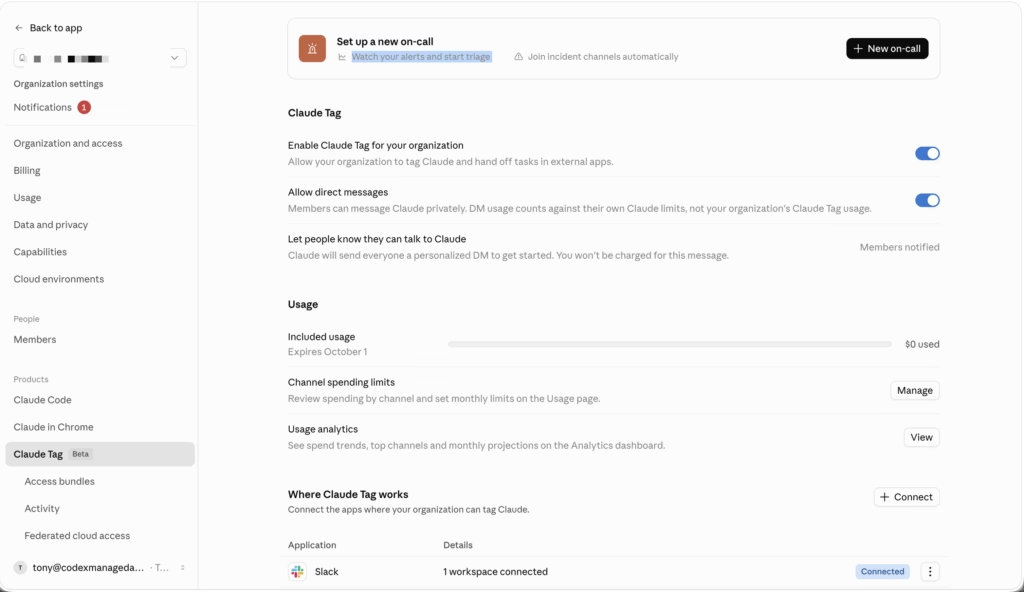
但最后发现其实是推广活动送了 2500 刀 的 credit
  • 如果是将 Claude Tag 用在客服支持等场景,可能会出现某些特定规则的群名,这些群名可能是希望 Claude Tag 加入或者不加入的,所以这里还会有专门的 Channel Name Rule;有白名单有黑名单;白名单会自动加入;黑名单则是绝不加入。对于一些做客服的场景,完全可以把 Channel 名写成 [Channel Support],然后等 Claude Tag 自己进去做支持。
Claude Tag 的 Memory

Memory 是如此的重要,以至于我认为我一定要专门开一章来写它。如果你要做仿品,只做一件事,那我认为就是做这个 Memory 体系。

Claude Tag 也为其产品设计了 Memory 的机制,
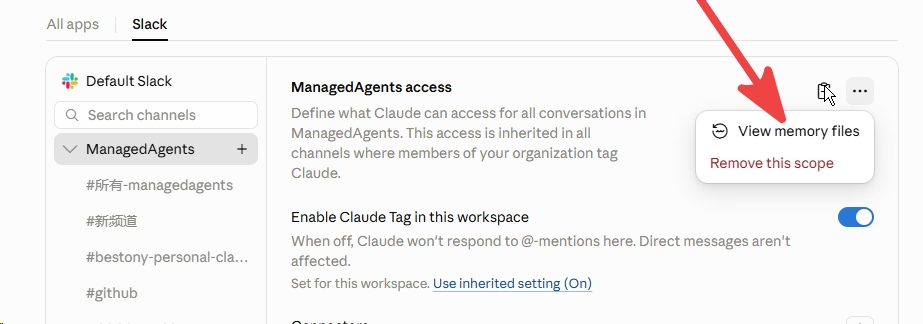
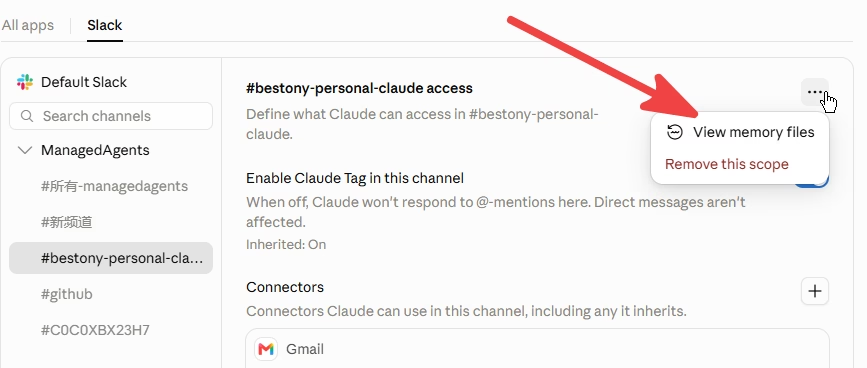
Workspace 级别入口
Channel 级别入口

你可以看到,Claude Tag 的 Memory 是以树的形式来组织的:
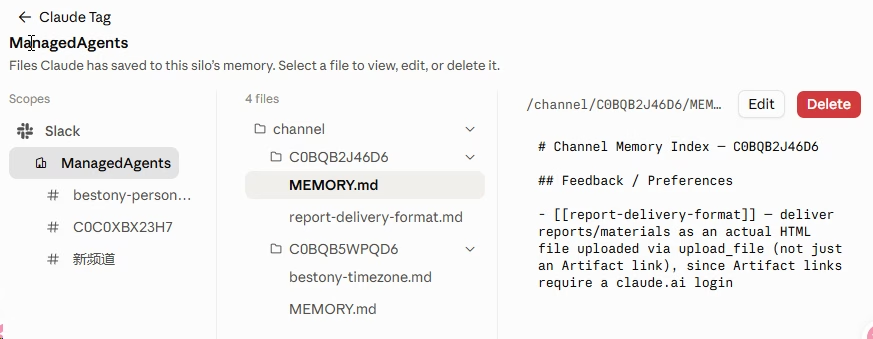
你会先在 workspace 级别的 Memory 中,看到 每个 Channel 中的 Memory ,但这里其实是各 Memory 的 Channel 的总结,更多是一个 Summary;而不是完整的 Memory;

而 Channel 级别的 Memory,你需要切换到 Channel 的选项中,查看详情。
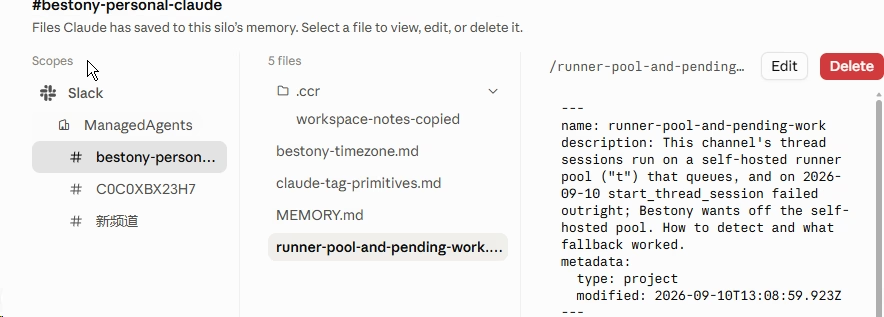
在实际的使用时,memory.md 会作为索引,加载到 System prompt 中,Agent 根据需要,自己加载别的文件
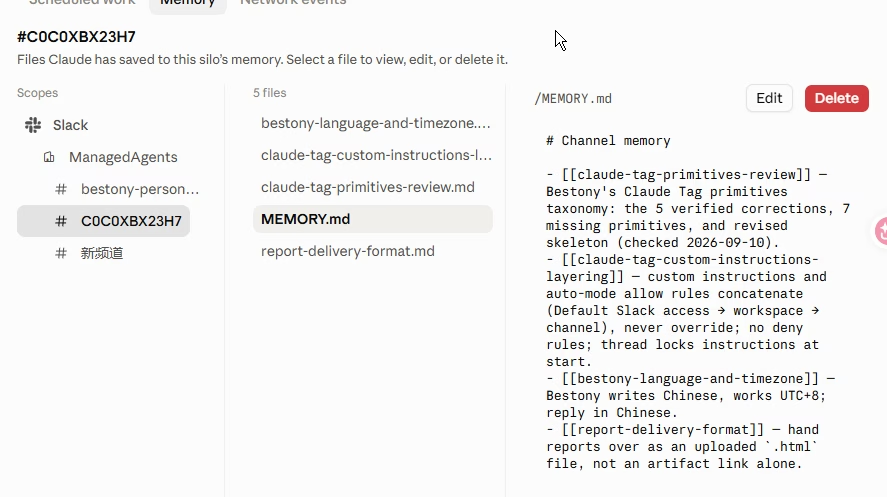
且系统会根据相关性,通过对 Description 的二次判断,正式判断是否需要加载 Memory 当中的细节,并取 前4K 放在 context 中,方便 Agent 进一步自己去读。
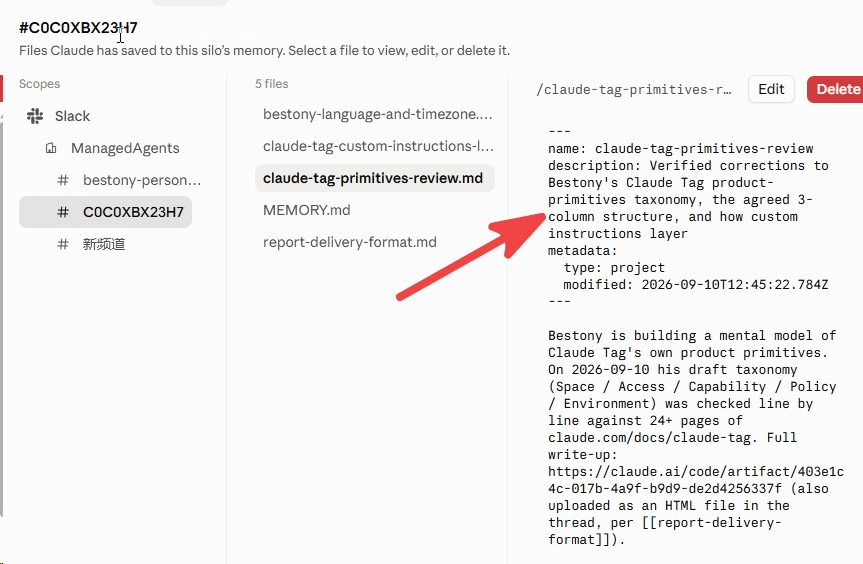
Claude 一个 Channel 中可以有多个 Session (每个 Threads 都是一个新的 Session),Claude Tag会在开始处理任务的时候加载 Memory,因此,如果某个 Threads 写入了 Memory,另外一个 Threads 大概率需要到下一次调用时才能加载到。

在写入 Memory 的时候,Claude Tag 是在本地以文件夹和文件的方式组织 Memory, Agent 在必要的时候,写入相关的 Memory,当然,你也可以自己主动和他说。

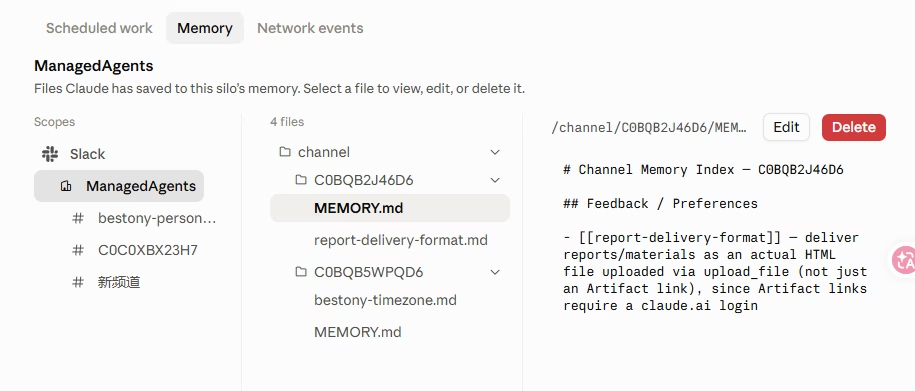
Claude 会把 Memory 写入到 Channel 和 Silo 文件夹;这两个文件夹的区别主要在于silo存储的是 workspace 级别的 Memory;而 Channel 存储的是本 Channel 自身的 Memory,这样就可以同时兼顾本 Channel 和全局的 Memory,从而确保 Agent 能及时获得必要的 Memory;同时,因为 Agent 可以同时看到两组 Memory,就可以有所取舍,将 memory 放在合适的位置。

===== 我在沙箱里看到的目录(文档未描述) =====
/tmp/claude/memory
`-- team
    |-- channel
    |   |-- .memory-sync
    |   |-- .memory-sync-basis
    |   |-- MEMORY.md
    |   |-- bestony-language-and-timezone.md
    |   |-- claude-tag-custom-instructions-layering.md
    |   |-- claude-tag-primitives-review.md
    |   `-- report-delivery-format.md
    `-- silo
        |-- .memory-sync
        |-- .memory-sync-basis
        `-- channel
            |-- C0BQB2J46D6
            |   |-- MEMORY.md
            |   `-- report-delivery-format.md
            `-- C0BQB5WPQD6
                |-- MEMORY.md
                `-- bestony-timezone.md
7 directories, 13 files

Code language: Bash (bash)

Claude Tag 的审计功能

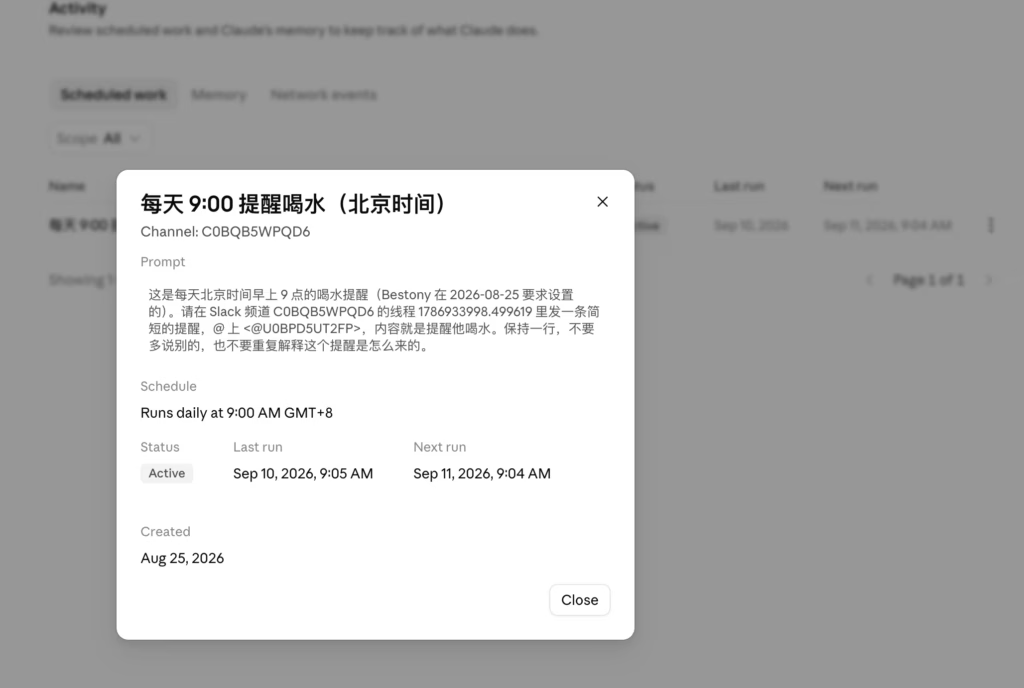
作为一个 To B 的产品,审计功能是必须的。 Claude Tag 也提供了一些基础的审计能力,分三个大类:Scheduled Work、Memory 和 Network Event。
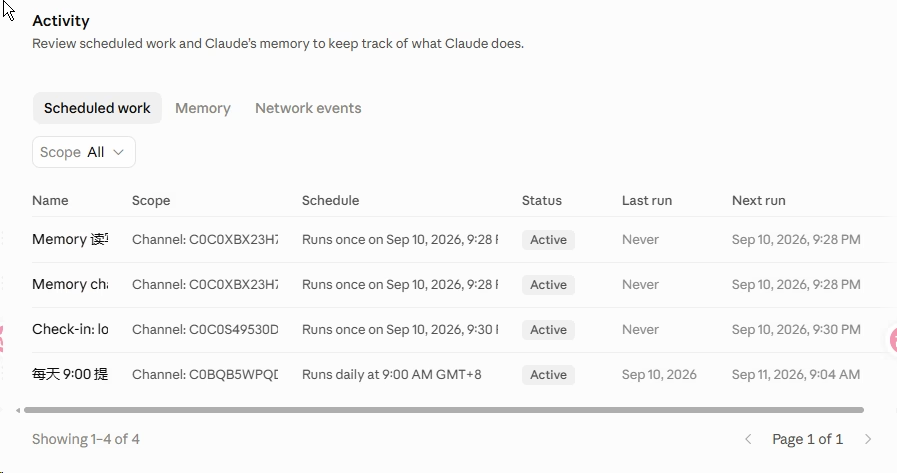
Scheduled Work 能够查看 Agent 的定时任务;不过也会发现 Agent 在执行任务的时候,也会把一次性任务当成 Scheduled Work 录入,从而导致展示在这里。
memory 则是整个 Org 级别 Memory 的展示,你可以根据需要查看和编辑某些 Memory。
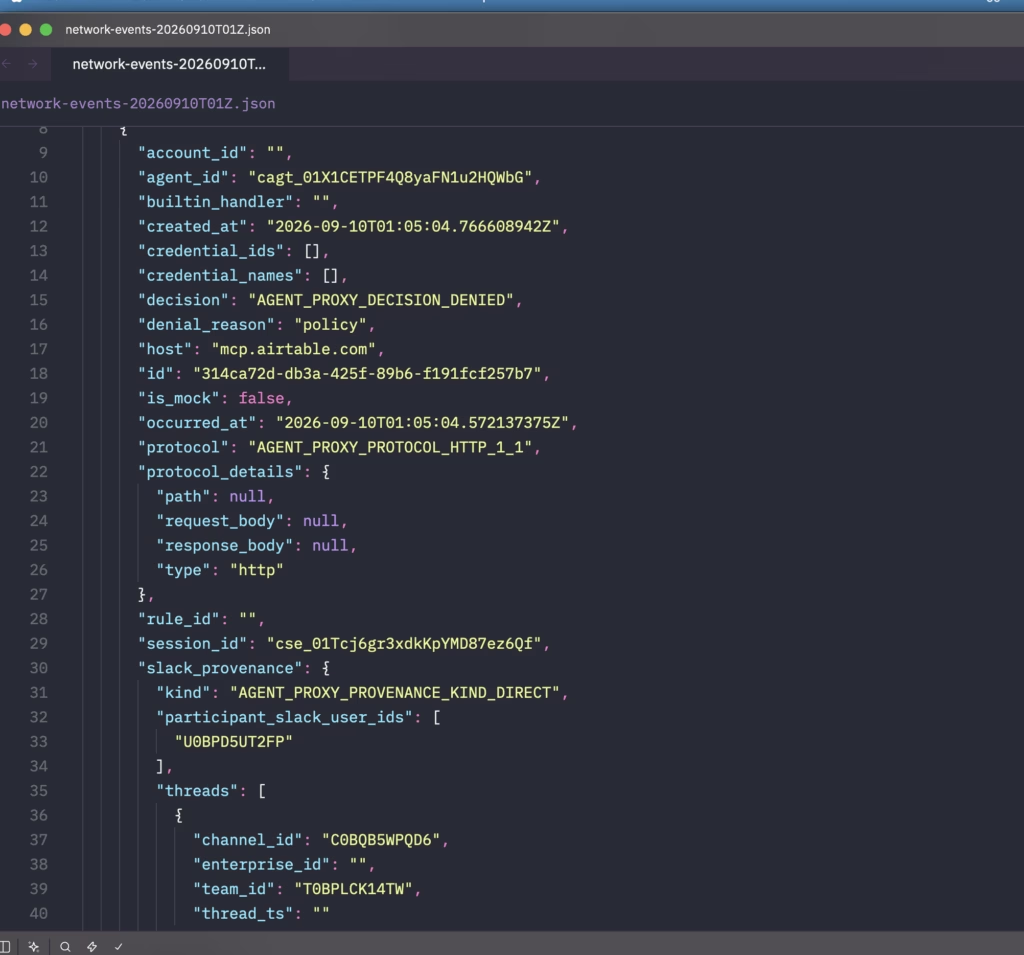
Network Event 则是可以真的查询某个 Agent 对于网络的调用情况(还记得前面配置的 DOMAIN 么?)。
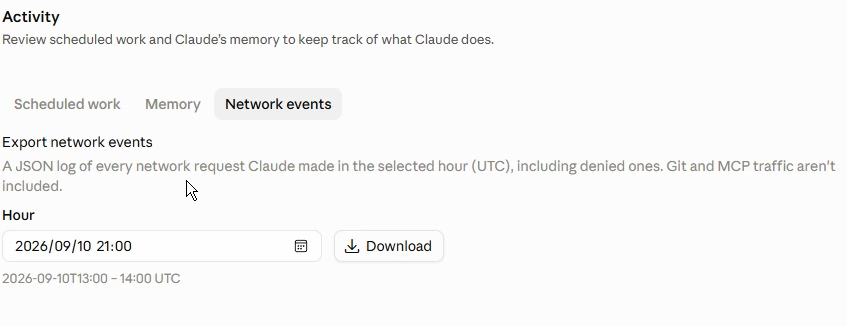
选择要查询的时间范围,就可以查询对应时间范围内的网络请求并分析。
Claude Tag 的 Custom Runtime

作为一个企业级产品,企业肯定会希望能够让运行行为发生在企业可控的网络环境,这样就可以充分利用企业内部的各项资源来完成这个目标。

Claude 支持创建一个 Self Hosted Environments ,来控制 Cloud Session 运行在哪个服务上
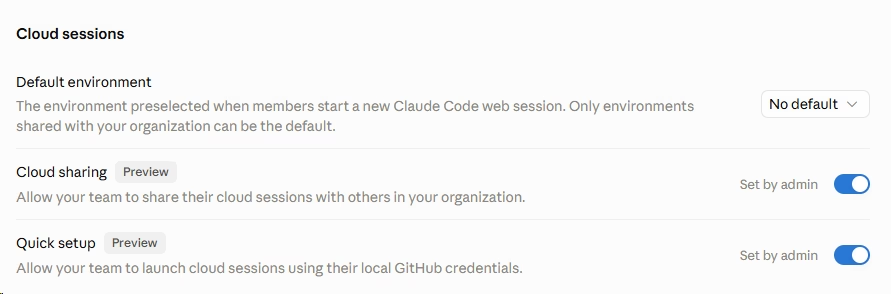
可以通过后台的配置,创建一个新的 Self Hosted Environment 来配置自己的 Runner,从而在企业内部使用的时候,就可以直接使用内网的设备来运行任务,执行各项内部基建。
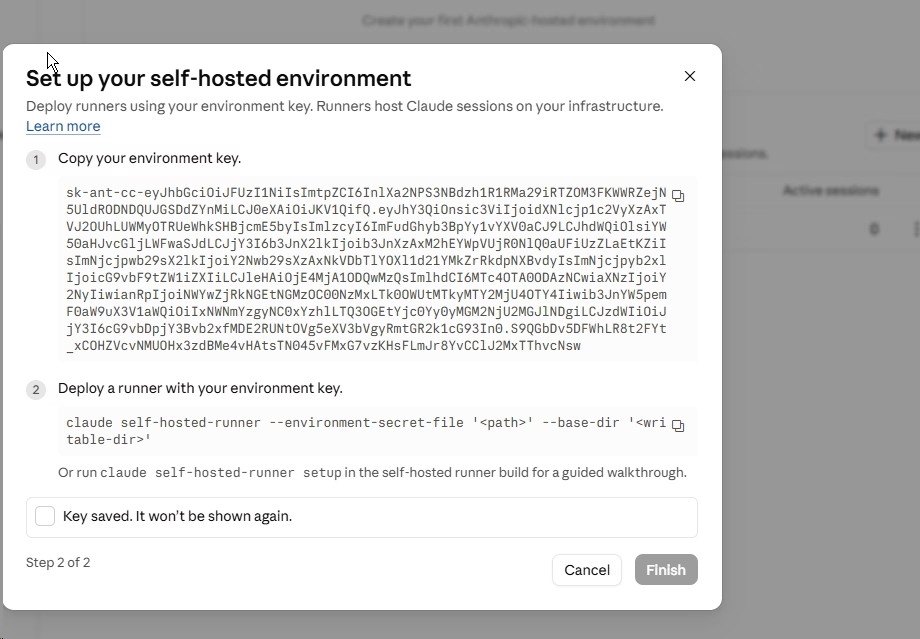
再配合 Access Bundle 中的 Domains 的配置,可以开启对内网服务的访问权限。
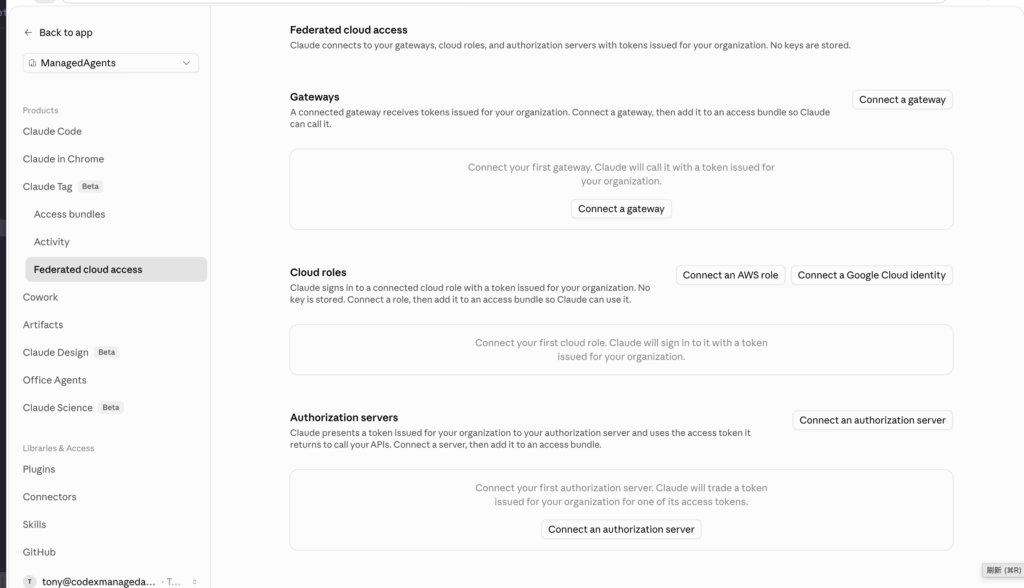
辅以 Federated cloud access 链接到内部的 Gateway、授权服务,来实现整个内部的权限管控、安全控制,从而更好的服务企业,让企业更敢于使用 Claude Tag。
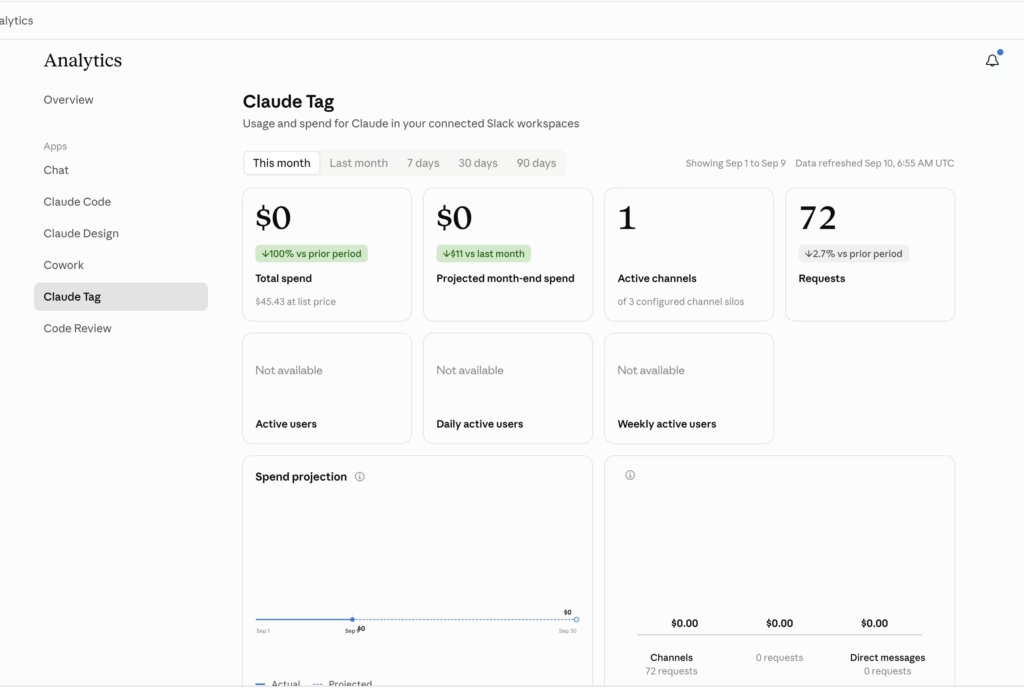
Claude Tag 的统计看板

Claude Tag 为用户提供了一个非常简单的统计看板
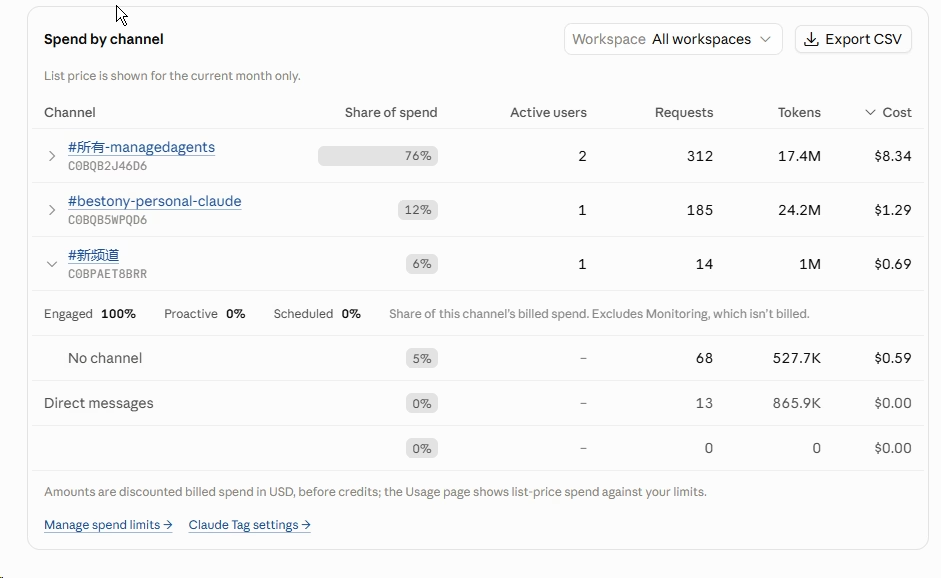
不过,最核心的 —— 哪个 Channel 最烧钱依然是有的
Access Bundle 的一些细节

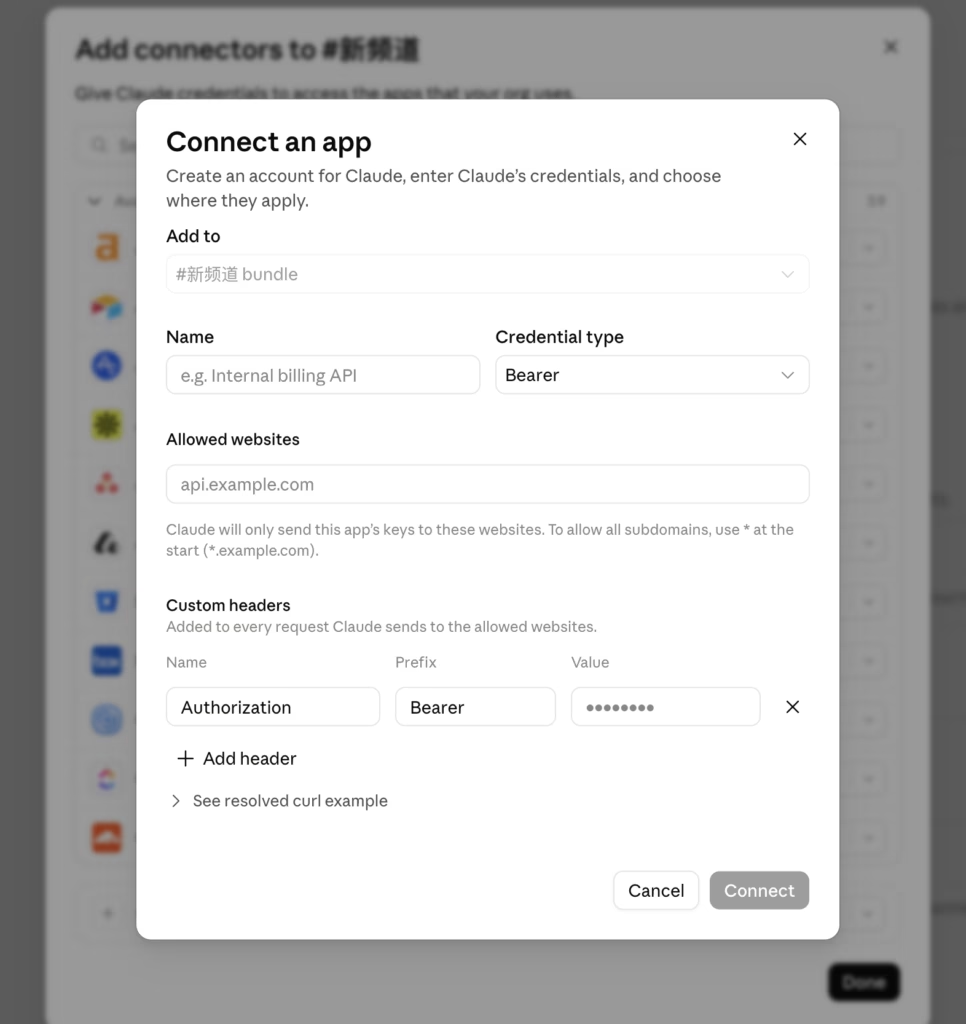
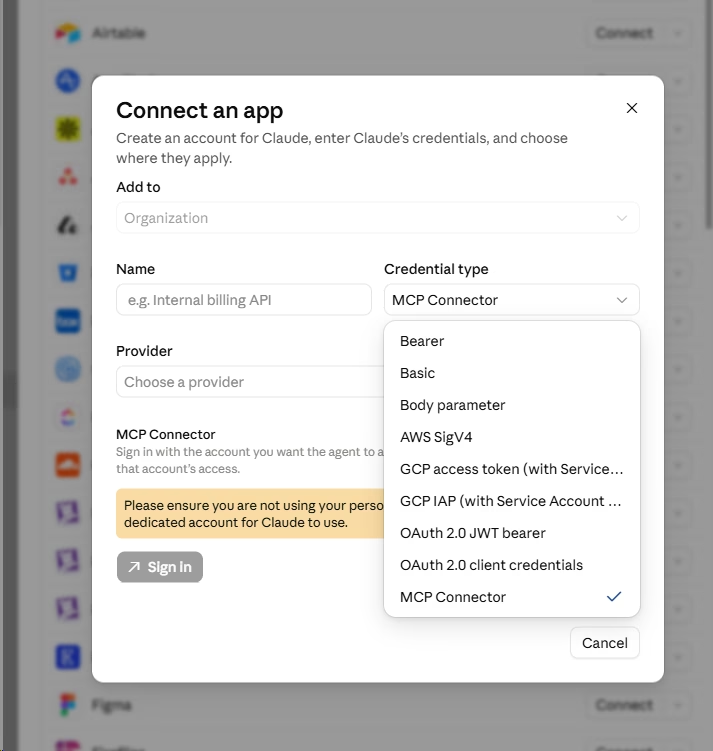
  • Access Bundle 的 Credentials 除了已经提前集成好的服务,还可以加入自己自定义的 MCP 和 API Server
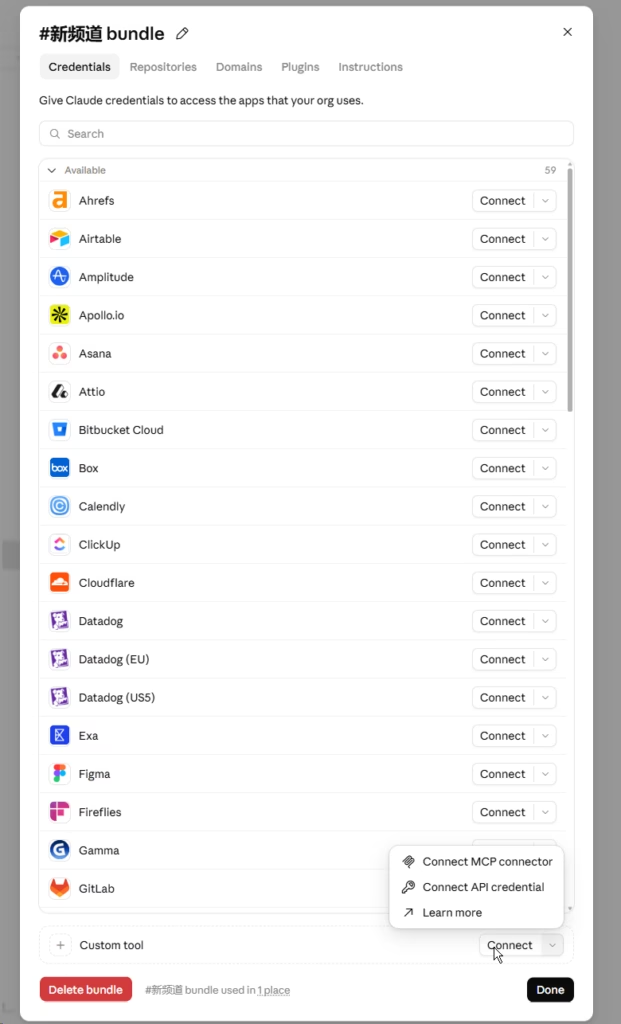
在使用 API & MCP 接入的时候,可以配置多种不同的授权方式,来满足绝大多数常见的业务场景,确保你能接入绝大多数业务。
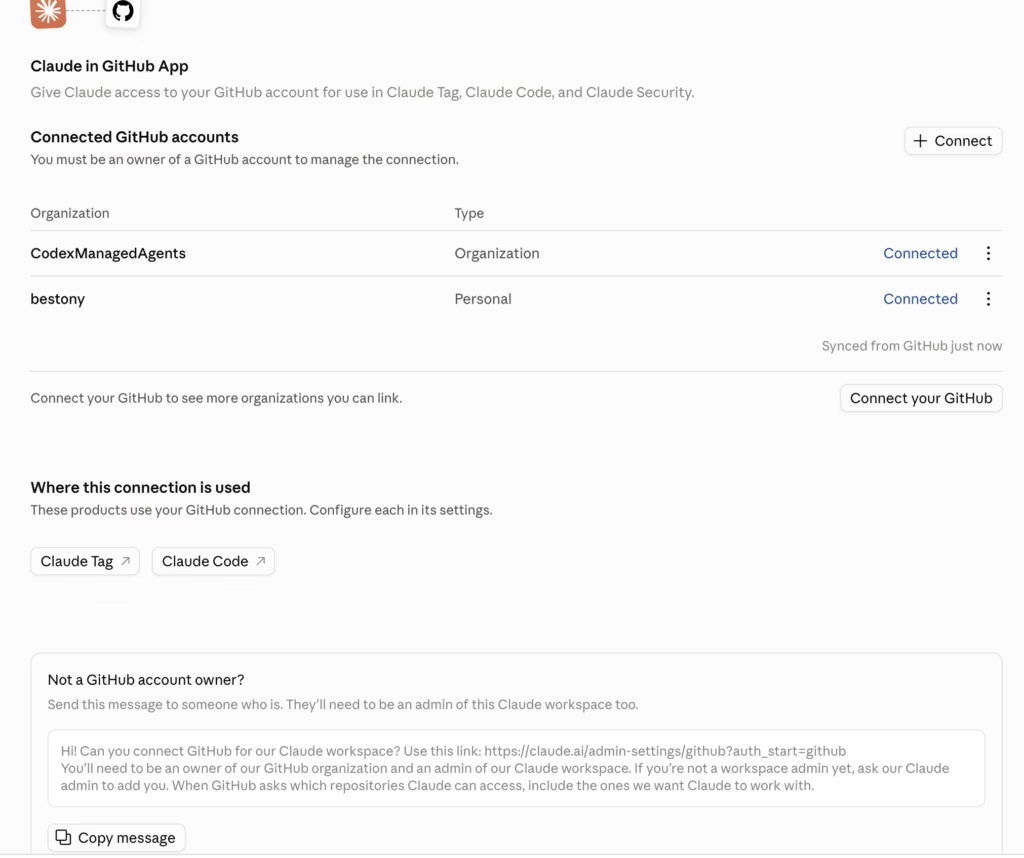
Repositories 的的支持需要你将 Claude 的 App 安装到你的 Org 里,才能使用。
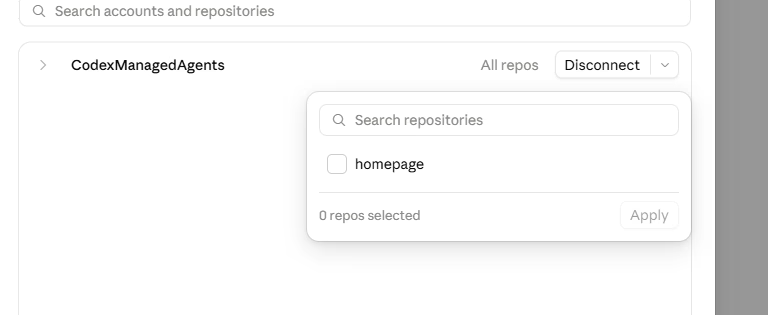
如果你有多个 repo ,也可以配置具体要用哪个 repo
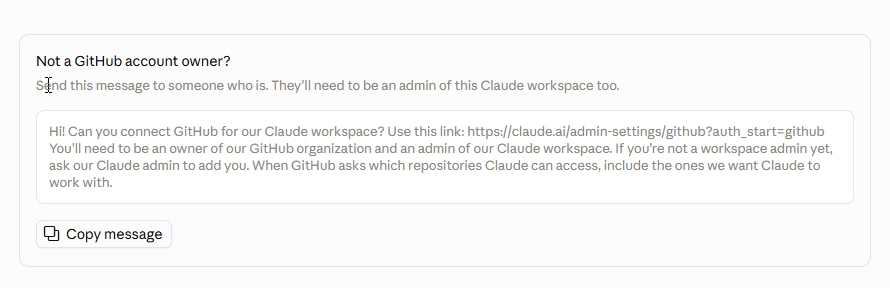
我觉得比较好玩,但觉得很合理的设计包括:给用户一个 prompt,发给 github account owner 来做 link
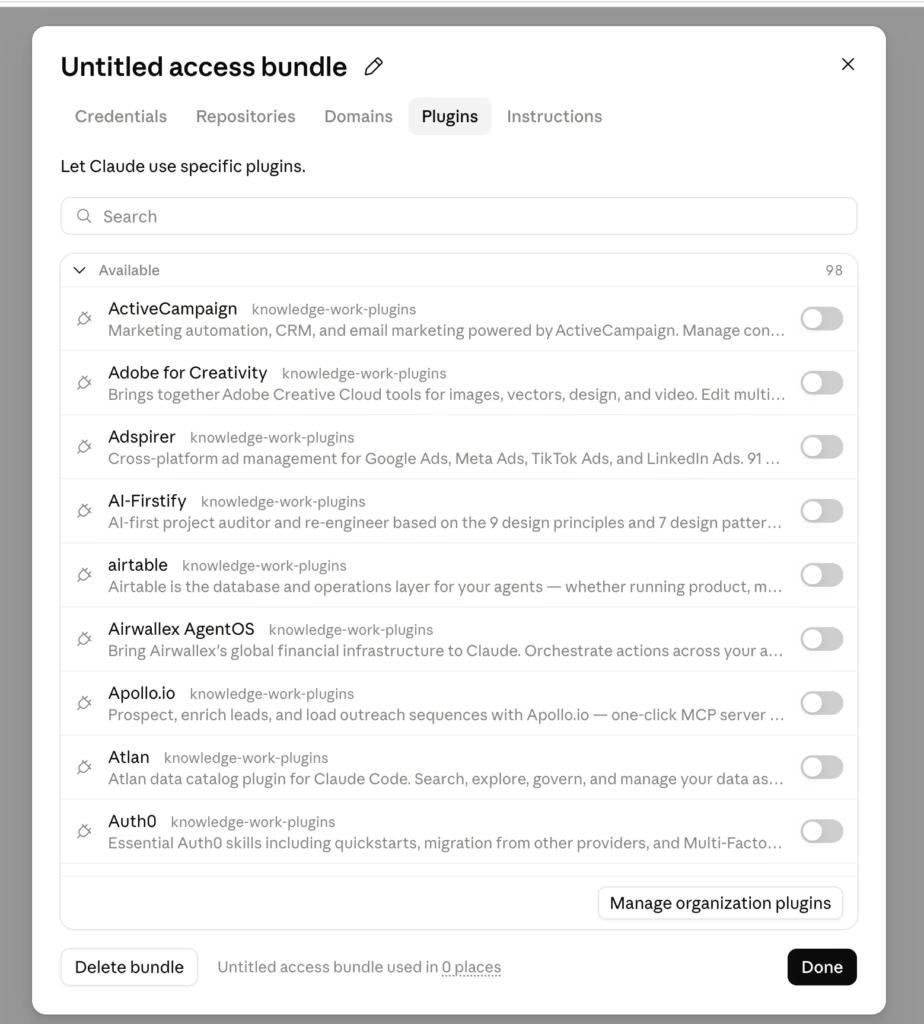
在配置 Plugin 的时候,你可以选择多个 Plugin 放在同一个 Bundle 里,来方便使用和配合。还可以接入组织自己的 Organization,来方便使用组织内部特有的 Skill & MCP。
总结

这篇文章一边写一边截图,花费了将近 3 个小时,希望内容能帮到你,更好的思考 —— Claude Tag 到底给用户提供了什么。绝不是简单的将模型链接到 Slack 上;

背后的功能、实现,对于 TO B 功能的考究,都是很值得学习的。

都看到这了,我猜你肯定想试试看这类产品?那不妨试试我最近参与开发的一个开源项目 —— https://github.com/first-tree-ai/opentag 。我承认,我们还没做到很多这篇文章中提到的 Claude 的功能,但,在路上了,不是么?也欢迎你参考进来一起开发。

我的独立开发者书单 2025 版

最近和很多朋友在聊「做个生意」的事情,也谈到了很多的书,为了方便大家按图索骥,所以整理了以下这个书单,来帮助大家快速上手,控制预期。同时,我自己也一直的观点是 —— 独立开发者最重要的是开始自己去构建,但也应该看书,来规避一些最基础的错误。因为你的资源不足,做决策就应该更加审慎

这个书单会不定期更新,本次更新时间为 2025 年 12 月 13 日。如果你希望知道这篇文章的更新情况,可以关注我的 Twitter,更新时,我会发 Twitter 说明。

声明

做生意当中有很多种不同的可能性,以下的书单仅服务于「你想有个互联网软件产品,并基于此赚钱」 这个具体的场景,帮助你更快的的上手。

具体书单

黑客与画家

豆瓣:https://book.douban.com/subject/6021440/

重点看第六章:「如何创造财富」,介绍了关于「创业」的本质;我自己觉得,近些年来,创业被说的太大了,以至于大家提起创业,满脑子就是融资、I have a Dream,很少再花自己的钱去创业、先亏一笔,然后拿一个更大的市场。大家还要知道,创业还有一种方向,我称之为「做生意」:从 Day 1 开始,这个业务就是赚钱的,就是能赚钱的,而不是依赖外部资金去赚钱的。

MakeBook

官网:https://readmake.com/

来自的 Peter Levels 的英文图书,主要介绍了他自己构建独立开发产品的经验和一些案例。我自认为这本书当中的内容对于想要走独立开发者这条路的人来说是有参考意义的价值。
举个例子,他将独立开发分为以下几个步骤:灵感、构建、启动、增长、商业化、自动化、退出;我见过绝大多数的开发者,在项目的一开始可能只想到了灵感,就开始构建,但从未思考过后续的启动增长和商业化的问题,导致辛辛苦苦做了很多事情,才发现完全没设计好商业化方案,不得已关停。

给大家看的搜索引擎营销书

豆瓣:https://book.douban.com/subject/4926710/

这本书主要介绍的是 SEM 相关的话题。在和很多朋友聊的时候,都提到了如何低成本的获取流量,然后从中盈利;那我认为你非常需要看看这本书。虽然 SEM 是花钱的,但只要你的 ROI 是正的,SEM 也未尝不可,不要抗拒花钱的(当然,应该设置止损线,特别是你刚开始的时候)。

这部分书会教你如何设计你的 SEM 方案(但不包含具体的投放方案,整体的思路可以借鉴,然后自己动手去投放)。

这本书没有电子版,也已经停止印刷了,但我强烈建议找来看看。

一个 App 的诞生

豆瓣:https://book.douban.com/subject/26865230/

这本书比较适合【只在应用生产中做过一个细分场景的人】,或者是刚毕业没几年,没经历过一个应用的生产研发全周期的人。这本书能帮助你理解整个应用构建的全生命周期,以便于后续实际开发过程中,不会搞错重心。而且这本书很浅,很快就能读完。

奔跑吧,程序员

豆瓣:https://book.douban.com/subject/30271075/

这本书实际上是被书名耽误了,他的英文书名叫《Hello, Startup: A Programmer’s Guide to Building Products, Technology, and Teams
》。所以,你看到了,实际是一个教你创业的书。

里面涵盖了很多关于创业公司的细节的内容,包括管理、数据、营销等一系列内容,对于软件工程出发的朋友们来说,可以帮你补全你的一些基础认知和概念。

书摘

那么,什么样的环境可以激励人们产生新的点子呢?因人而异,但最常见的要素有这么一些:·给自己充足的时间;·记录点子日记;·解决问题;·放下工作;·添加约束;·寻找痛点;·与他人交谈。

想要拥有好的点子,最重要的一个因素就是要先有很多很多的点子。当然,这里隐含的意思是,如果想要拥有更多好的点子,你也要有更多不好的点子。这个观点是有研究支持的,麻省理工学院和卡耐基梅隆大学的研究发现,产生不同寻常的点子的最佳方式并不是提高点子的平均质量,而是提高它们的差异性。

一人企业

豆瓣:https://book.douban.com/subject/35293067/

这本书我最早看的是台版的。推荐给大家,介绍了关于一个小规模公司和如何持续保持一个小规模的手段和问题。独立开发者毫无疑问是一人企业的 MVP。如果你能够以一人的状态发展、持续学习和发展,那么长期就一定是站在你身边的。所以,just read it。

书摘

相反,你可以建立一个小到没法倒闭的企业。你可以让一个“一人企业”度过经济衰退,不断适应客户的不同需求,通过保持小规模、保持专注力来规避竞争,以低成本来获得利润。

在确定最低可行利润时——你的企业在没有负债的情况下正常运行的界限(下称MVPr)——要记住这个数越小,你就能越快实现。所以你首先要把重心放在核心业务上,降低成本和开销,确保公司能小规模经营。

网站创富:从搭建、管理到营利

豆瓣:https://book.douban.com/subject/26676379/

在绝大多数独立开发者的语境当中,搞的都是「做产品,然后售卖产品」。但我坦诚的讲,不是每个人都具备做产品、卖产品的能力的。如果你没有能力自己做一个产品,那么不妨先从做广告营销的路径上走,先为互联网提供信息,然后售卖这些信息所带来的流量(就像你常见到的 B站视频广告、公众号广告,其实都是这个业务模式)。

如何在 Google Analytics 4(GA4) 查看 Referer URL ,获取来源地址

作为统计站的第一,这个 Blog 也挂了 GA 4 作为统计。如果你希望知道是谁在推荐你的 Blog,一个很好的办法是查看 HTTP 的 Referer 的 URL,来判断哪些人在哪些地方推荐了你。

不过 Google Analytics 在升级到 GA4 之后,查看 Referer  变得麻烦了不少,没办法直接通过预置的看板来查看。这篇文章就是帮你找回丢失 Referer URL。

具体操作步骤

一、登录 GA 4 ,找到你的站点;点击左侧的「探索」,进入到探索页面。在探索页面点击「空白」,来创建一个新的探索看板

    二、新的探索页面,选择维度这里,新增两个维度和一个指标

    维度:网页引荐来源网址网页位置

    指标:新用户数

    三、将网页位置和网页引荐来源网址配置到设置中的行,且顺序为网页位置在先,网页引荐来源网址在后;显示行数设置为 500;新用户数配置到设置中的值当中;设置过滤器为网页引荐来源网址包含 //

    四、配置完成后,你就可以看到类似我这样的界面了,在这个页面里,你就可以看到不同的来源给你带来了多少流量;从而进一步的去和对方沟通~

    PayJS 测试二维码生成工具

    简要描述

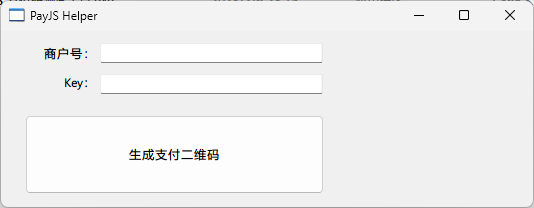
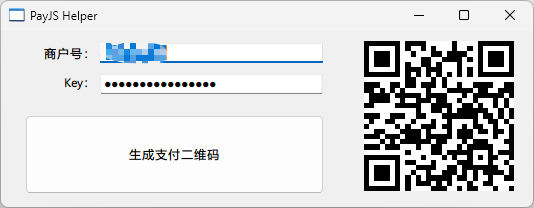
    这个工具主要用于生成 PayJS 的测试支付订单,在 PayJS 官方不提供测试订单工具之后,可以使用这个工具来生成测试订单,简化操作。

    下载地址

    截图

    未生成二维码效果
    生成二维码效果

    更新日志

    0.0.3

    • 设置 key 为密码类型,保护信息安全。

    0.0.2

    • 支持 payjs 生成 1 分钱订单,并展示二维码。

    什么是我眼中好的开发者产品的文档?(一)

    我自己作为开发者使用过很多的开发产品,也看过不少的文档。最近频繁受邀针对不同的产品的文档提出建议,单独写这样一篇文章来说明一下我觉得什么是好的文档。一方面,可以帮助更多的开发者产品变得更好,另一方面,也可以用于自省,我自己在设计产品时是否会有类似的问题。

    不过也需要注意,这篇文档仅涉及 「Guide」和「API Documentation」的部分,对于更多的 Changelog、Example、Tools 、 SDK 则没有涉及,这部分留待后续再写。

    本文当中参考了包括:Notion 开发者文档微信小程序开发者文档声网 Agora 开发者文档WordPress 开发者文档飞书开发者文档等开发者产品。

    API Documentation vs Guide

    其实不少的产品文档写的都是 API Reference ,而不是 Guide,二者在实际的使用意义上是有所不同的。

    • Guide 帮助开发者快速上手一件事,从 0 开始,完成一件事。这是「用户视角」
    • API Reference 则是告诉开发者你能使用我的产品做什么事情。这是「平台视角」

    一个好的文档应该是二者兼备的,这样才能一方面降低开发者的进入门槛(Guide 负责),另一方面, 可以让开发者可以知晓能力的范畴,帮助开发者尽可能拓展的应用边界,创造出美好的体验和新的世界。

    一个好的 Guide 应该是什么样的?

    这里我们以 Notion 的文档为例:

    1. 一个好的 Guide 应该尽可能的显眼 & 好找

    作为一个新的开发者,进入一个新的开发者平台时时迷茫的:“我应该做什么?”、“我应该看什么?“

    这时一个明确的「Guide」、「Get started」可以帮助我们快速找到一个开始的锚点,这个锚点会成为开发者在这个平台中开始进行的下一步。

    Notion 开发者文档首页中 Guides 的入口
    微信小程序开发者文档中的指南的入口

    2. 一个好的 Guide 应该有明确的步骤描述 & TOC

    开发者在进入一个新的平台时,需要的是「快速跑完流程,以熟悉平台的各项基本功能」,而不是需要了解到所有的能力(如果开发者已经非常熟悉你的产品,其实根本不会看 Guide,直接去对应的 API Documentation 查看实现了)。

    一个明确的步骤描述和 TOC 可以帮助开发者降低心理压力,并让用户找到自己所在的位置,进行下一步的推进。步骤的名称也非常的重要,一个清晰明确的步骤,可以帮助开发者快速明确自己要做什么事情,不会产生疑惑。

    Notion 文档当中对于步骤描述
    声网文档中关于步骤的描述

    此外,也需要注意,步骤不建议太多,可以移除掉那些非核心的步骤,重要的是帮助用户跑通开发流程

    3. 一个好的 Guide 应该是场景相关的

    开发者在使用产品进行产品开发时,会有明确的预期,我要做什么事情。但产品需求和平台的能力是不同的。我们很难将产品需求和平台能力直接挂钩,这时就需要开发者盲人摸象般在整个平台上搜索和查看,找到适合自己的文档。这个时候,如果有一个场景相关的 Guide,可以帮助开发者快速找到适合自己的场景,并进行文档的细分。

    在这些文档中,你的目的是帮助开发者快速了解在你平台上某个方向的能力、核心概念和如何组合你所提供的能力,帮助开发者快速实现自己的业务诉求。

    Notion 文档中的场景化文档
    微信开发者平台的场景化介绍

    一个好的 API Documentation 应该是什么样的?

    如果说 Guide 是开发者进入一个平台的时候最基础的教程文档。API Documentation 则是一个开发平台中最为核心的部分了,开发者每天都需要与 API Documentation 打交道,以完成一项工作,如果 API Documentation 做的不好,那对于开发者来说,简直就是一个灾难。

    1. 一个好的 API Documentation 应该是组织合理的

    API Documentation 当中往往包含了大量的信息,那么合理的拆分不同的 API 的模块,可以帮助开发者无需遍历所有的 API ,而是直接按照模块逐级查找自己所需的 API 即可,可以有效的提升查找的效率。

    Notion 文档当中按照业务模块拆分的 API Documentation

    2. 一个好的 API Documentation 应该具备所涉及到的各项数据结构的说明

    对于复杂的 API 接口来说,参数/返回值往往不仅仅是一个简单的 Integer 、String ,还会涉及到一些更加复杂的结构化数据的定义。

    一种选择是将这种复杂的结构化数据抽象出来,成为一个新的类型;另一种选择是每次都解释一遍。显然,根据软件工程的 “DRY” 原则,我们应当将其抽象出来。在将对应的数据结构抽象出来后,需要注意的是,将其放在一个明确的位置进行展示和说明。原则上,这些结构的说明应该先于具体的接口说明。

    Notion 文档中的 Database Object 的位置说明
    WordPress 文档中关于返回类的定义描述
    WordPress 中在返回值中说明的错误类的入口

    3. 一个好的 API Documentation 应该提供相应的 Sample Code

    对于开发者来说,Talk is cheap, show me code。而在开发领域也是同样的。你提供的 Sample Code (甚至是在线的调用测试),都可以帮助开发者更好的理解相关的能力和开发逻辑。

    所有的细节,都在 Sample Code 中一览无余。

    Notion API Documentation 中生成代码的部分

    4. 一个好的 API Documentation 应该可以提供上下游关系

    在 WordPress 文档中,有一个我非常喜欢的功能就是 Related 。Related 内部分为 Uses Used By,分别介绍了某个函数都是用了哪些函数来完成自己的功能和哪些函数使用本函数完成自己的功能。

    WordPress 文档中 Related 的部分说明
    声网文档中关于 API 上下游的描述

    伴随着 Uses 还提供了这个函数的源码(不过这个对于平台类型的产品不能直接照抄),这样我可以非常清晰的参考这个函数的 Uses 和源码,以了解这个函数是如何实现自己的功能的。这样当我需要的时候,就可以非常方便的基于这个函数,改造出一个我自己使用的函数。

    而 Used By ,则提供了其他的函数是如何使用这个函数的。对于一些我比较陌生的函数,可以直接参考其他函数的用法。从某种意义上来看,这是比测试用例更加全面的用法的说明,因为这是在“生产环境”下的用法。

    我们在开源世界如果没有文档,会看测试用例,那么在 WordPress 当中,我会看的是 Used By。

    5. 一个好的 API Documentation 可以提供用户之间的沟通渠道

    我在 WordPress 开发者文档当中,还会常用到的一个功能是 —— User Contributed Notes。这个功能为开发者提供了一个基于函数的共建笔记。开发者可以自发的在其中撰写自己针对这个函数的开发经验。

    WordPress 文档中 User Contributed Notes

    当我在不知道某个函数应该怎么使用的时候,我往往会去 User Contributed Notes 去找找看,看看别人是如何使用某一个函数的。官方的文档往往无法跳出「我有什么」的思路,而用户的共建笔记则可以共享出开发者使用某个函数的「奇技淫巧」。这些「奇技淫巧」让开发者的产品显得与众不同,也可以进一步的扩大产品的范畴。

    总结

    一个好的开发者产品文档是什么样的我很难定义,但至少上述的这些点,确实让我使用这些平台的产品在开发应用和业务的时候变得更加坚定。希望我的这些笔记,可以帮助到你,让你也可以涉及出一个好的开发者文档。

    person holding black and white electronic device

    独立开发者可用的支付方式

    我会关注一些个人可用的收款方式,核心支付要解决的问题是在开发产品过程中,必须要用到的各项基本技能。如果支付流程无法打通,独立开发者的商业模式就会遭到最直接的打击:你如何赚到钱?

    可能你会想,我难道不能使用广告的方式来赚钱么?

    当然可以,但与直接向最终用户收款的方式相比,显然,广告赚到的钱不过是蝇头小利。

    此外,我也说过,广告赚钱是非常少量的,因为你拿到的本身就是平台收益中的一小部分。此外,广告还有一个问题是与流量相关的,你必须不停的想办法获取流量,并将流量转化,这对于独立开发者而言,并不友好。因此,我并不看好以广告为基础的独立开发产品模式。

    故而,我十分在乎收款流程的通畅。

    其实想想也能明白,你会发现国内独立开发者大多出现在 iOS、Android 等移动应用开发平台上,这里很难说没有平台提供的收款渠道带来的价值。

    所以从这个角度而言,我也建议大家可以适当关注一些收款渠道,以便你自己后续使用。

    为什么不注册公司,自己接入渠道?

    当提起这些第三方渠道的时候,大家经常会说,诶呀,你这个收款平台的费率好高啊,你看看支付宝官方,只有XXX。

    我觉得,这个事情如果只对比收款费率的话,过于单纯。

    实际上,支付宝官方、微信支付官方往往需要企业资质才能开通。而你开通这些账号所支付的成本,远超你当下的收入。

    你用你前期的收入,养活了代注册公司、代记账公司。早期其实完全没有必要,你大可以用这些平台完成前期的冷启动,启动完成,有了长期收入,你的收益足以支撑你继续后续的工作,再替换不迟。

    我关注到的收款平台

    面包多 Pay

    https://mbd.pub/

    PayJS

    https://payjs.cn/

    XorPay

    https://xorpay.com/

    person using MacBook pro

    云计算的增长在 SaaS

    我一直以来,都很喜欢诸如 LeanCloud、Firebase、云开发这样的产品,这背后的逻辑是「随着云计算的成本不断下降后,下一步发展起来的是各样的 SaaS 产品」。

    这些 SaaS 产品的建设,和过去相比,基础设施的发展使得开发一个 SaaS产品变得比以前简单太多了。

    如果你需要服务器,无论是阿里云,还是腾讯云,甚至是面向全球的 AWS、Azure,都是你只需要花钱就可以买到的。

    如果你需要邮件系统,SES、Mailgun、Postmark,各种不同的产品,让你的开发变得无比的简单。

    你需要做的,只是找到你自己的 niche,然后针对这个 niche ,开发一款产品,并将你的产品推出,并发布上市,将你的产品售卖给你的客户。

    很多时候,我们在看云计算的市场的时候,如果我们关注的是 IaaS,基础设施,我们就会发现,我们面对的往往是那些旧有的,已经存在的市场,他们会使用我们的产品,来替代曾经的产品。但同样的,我们的产品也会被成本更低的 IaaS 产品所替代。

    我们要的是旧有的产业,还是那些新的产业?面向一个已经存在的百亿市场,还是一个未来会爆发的千亿市场?

    cars parked on parking lot during daytime

    好风凭借力,送我上青云

    对于如今的开发者们来说,已经处在一个很好的时代了,他们拥有着丰富的基础设施,这些基础设施,让我们可以以更加低成本的方式,来构建我们自己想要的产品和工具。

    我们站在巨人的肩膀之上,构建属于我们自己的产品。

    为什么我们一定要完全自己去构建一个产品呢?从国家的角度来说,这样情有可原,而从个人的角度来说,借助这些基础设施来构建一款产品,才是最为实际的。

    我们需要自己从 0 开始建设一个云服务么?当然没必要,我们可以使用阿里云、腾讯云、AWS、Azure,你可以使用任何一个云服务厂商为你提供的基础设施,构建自己的产品,直到他们无法满足你的那一刻。

    turned on black Android smartphone

    从给项目不买域名做起

    我是一个灵感非常丰富的人,所以我总是会有各种奇奇怪怪的想法,并且试图将其转换为一个实体的项目(工程师的身份赋予我将其从灵感变为现实的可能,而产品经理的经历让我可以关注一个产品最为重要的是,至于说运营的工作,让我可以把一个项目从 0 开始推广)。

    而我过去的一个毛病是,当我有了灵感后,会先试着去买一个域名。但,购买域名并不意味着我一定能把这个项目做完,大部分时候我会注册一个域名,然后,放一年,直到他过期。久而久之,我就有了几十个域名。。。

    我现在共持有 58 个域名

    所以,我在思考,在后续的新的项目中,我将会启用项目代号制,先不思考项目名是什么,以及应该用什么域名,而是先尽全力将自己的 MVP 跑通,以及完成功能假设和市场假设。

    所以代号从哪来呢?不妨从一些经典电影中找找灵感吧,最近看一些英文电影,然后从英文电影中寻找答案。

    person working on blue and white paper on board

    关注体验,而不是关注效率

    今天和我的广告主,芦笋的创始人晓力聊了很多,其中聊到独立开发者的工作,我提到了一个概念:

    作为独立开发者,我们需要关注产品的体验,而不是关注产品的效率。因为在效率的追求上,我们一定不如大公司能够在这个事情上做的更好,在这种情况下,做一个更具备“个人特色”的事情,会让我们在一件事上走的更远。

    个人特色意味着独特的品味和体验,这种独特的品味和体验,将会引导用户持续使用。而这些独特的品味和体验,将会是留下我们的用户的重要的部分。