分类目录归档:随笔

被滥用的云南十八怪

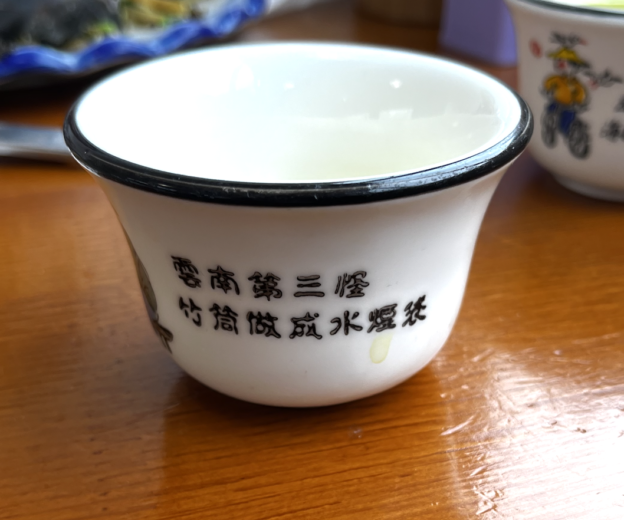
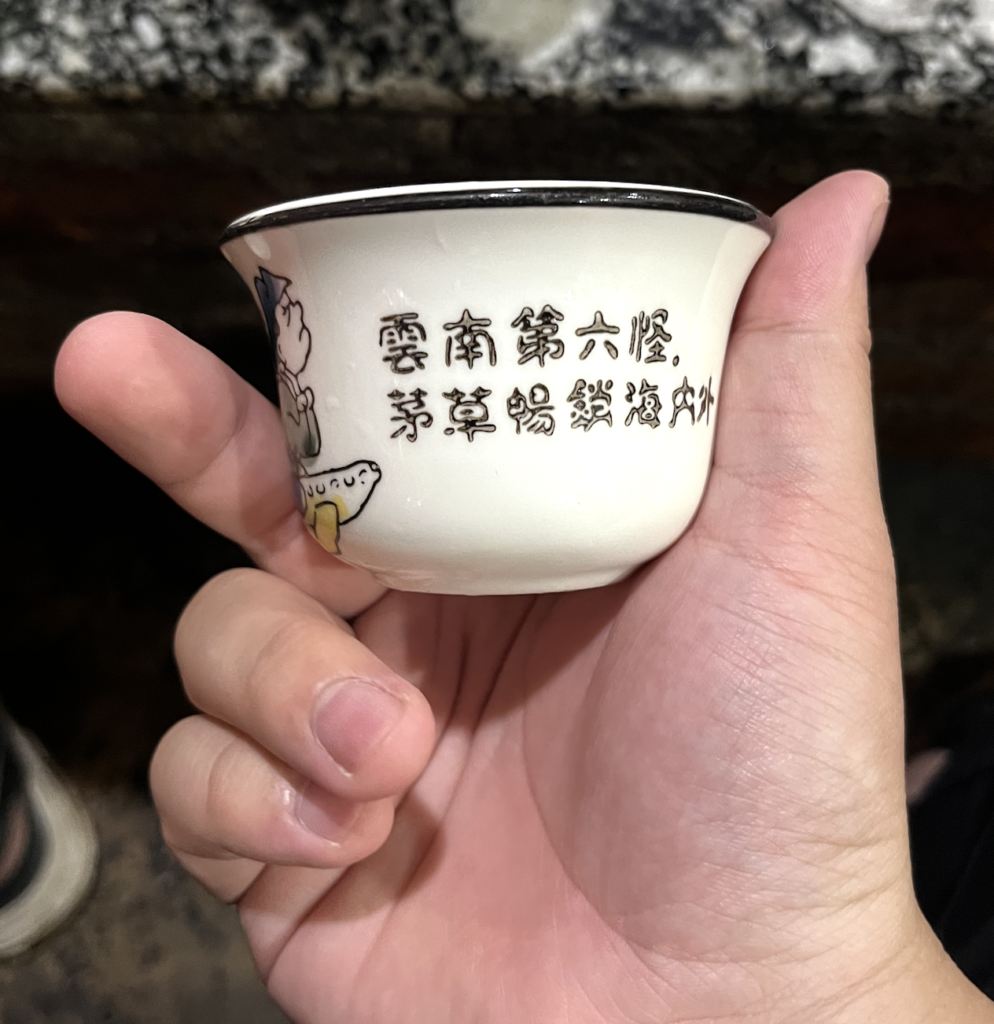
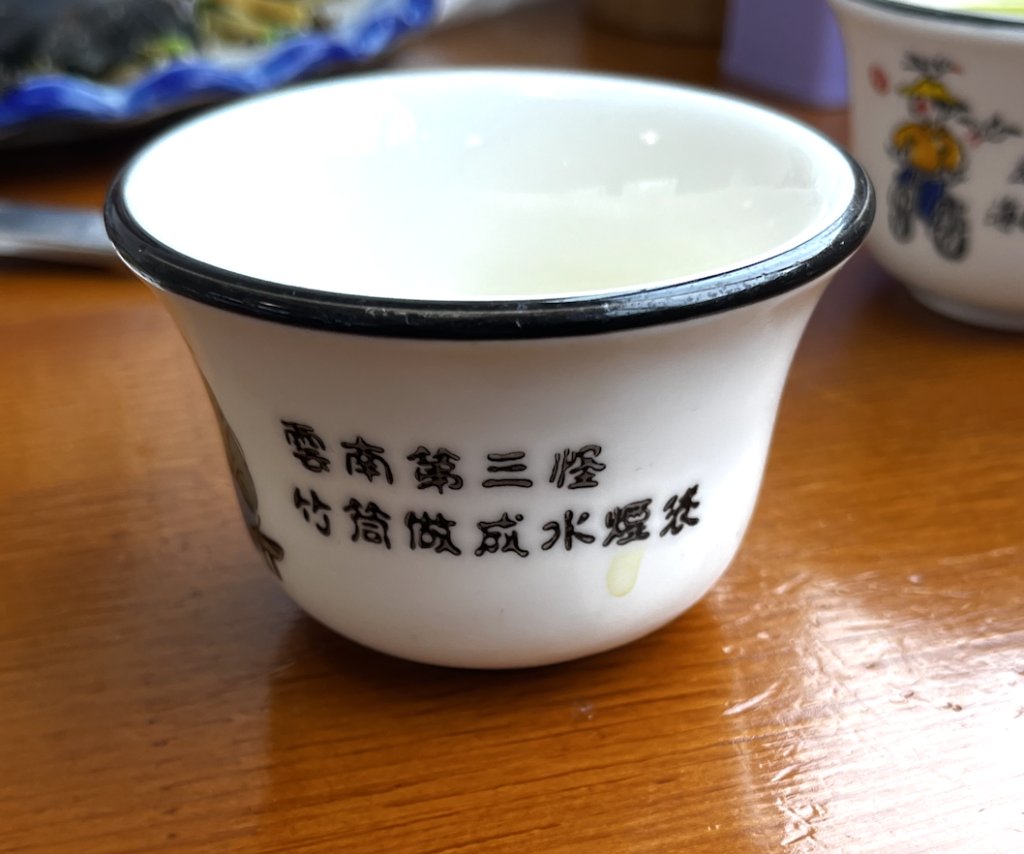
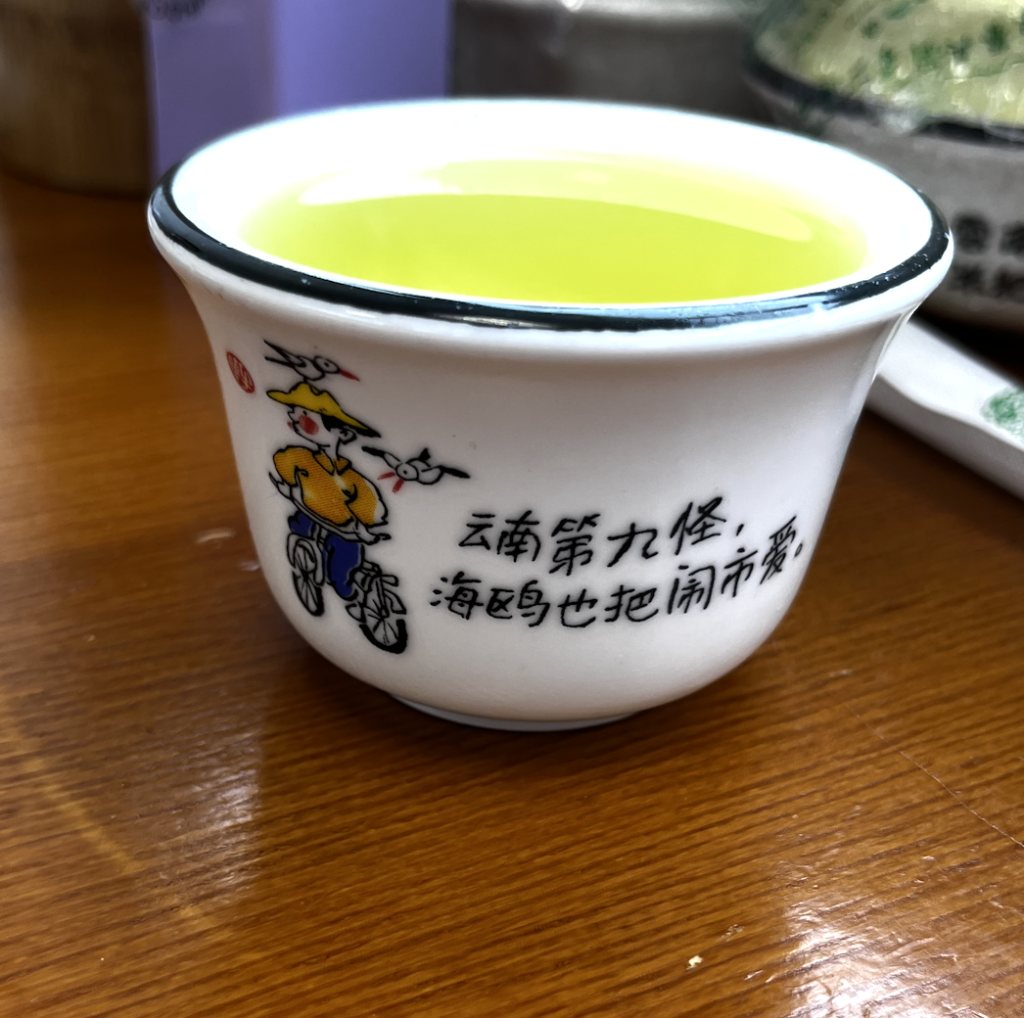
这次去云南,看到了各种各样奇奇怪怪的“云南十八怪”,让我不得不来吐槽一把。

在没去云南之前,我就知道云南有个“云南十八怪”,在解释云南各种和中原地区差异比较大的生活习惯,但说实话,一直没怎么了解过具体的细节,因为不熟悉。

根据百度百科,云南十八怪是这样的:

你说奇怪不奇怪,云南就有十八怪。
四个竹鼠一麻袋,蚕豆花生数着卖;
袖珍小马多能耐,背着娃娃再恋爱;
四季衣服同穿戴,常年能出好瓜菜;
摘下草帽当锅盖,三个蚊子一盘菜;
石头长在云天外,这边下雨那边晒;
鸡蛋用草串着卖,火车没有汽车快;
小和尚可谈恋爱,有话不说歌舞代;
蚂蚱当作下酒菜,竹筒当作水烟袋;
鲜花四季开不败,脚趾常年露在外。

百度百科

但我在云南当地,见到了各种奇奇怪怪的十八怪,甚至炒酸奶也被编进了十八怪:“酸奶炒着卖”。

flat screen monitor

如何解决 Kindle 在 M1 系列设备上无法访问的问题

问题

在使用 M1 的时候,我遇到一个很麻烦的问题是 M1 无法识别出我的 Kindle,系统无法自动加载 M1 设备,这导致习惯于导入标注并使用 Klib 管理的我来说,等于用 Kindle 的功能不齐全了。

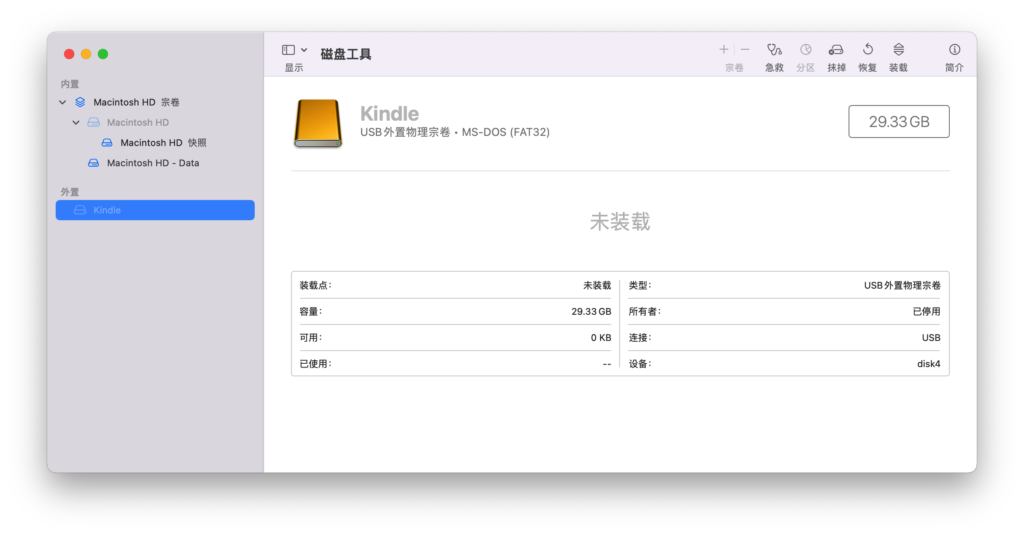
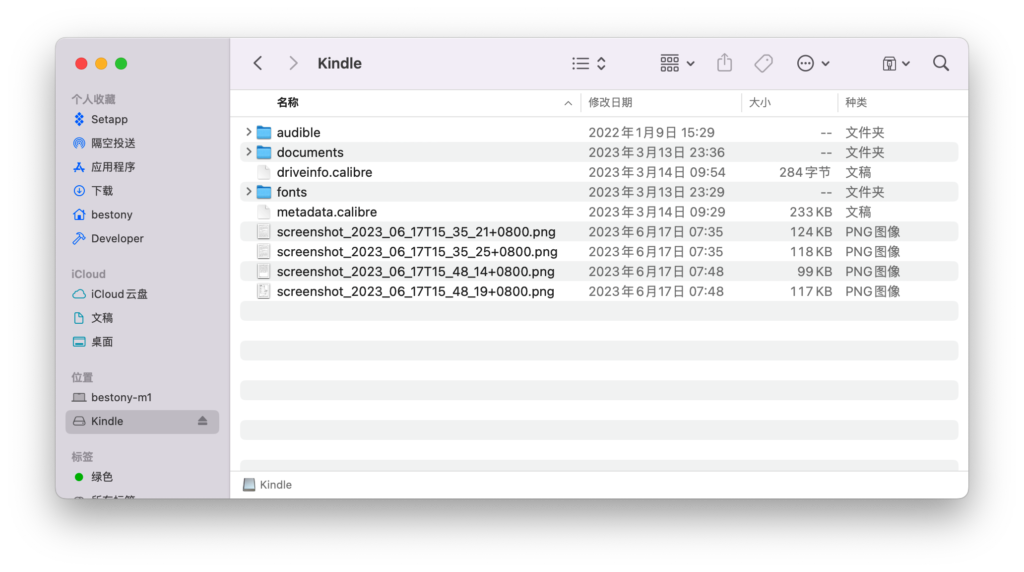
使用 macOS 自带的系统工具,也可以看到系统 Kindle 的磁盘,但无法加载。

磁盘工具的展示

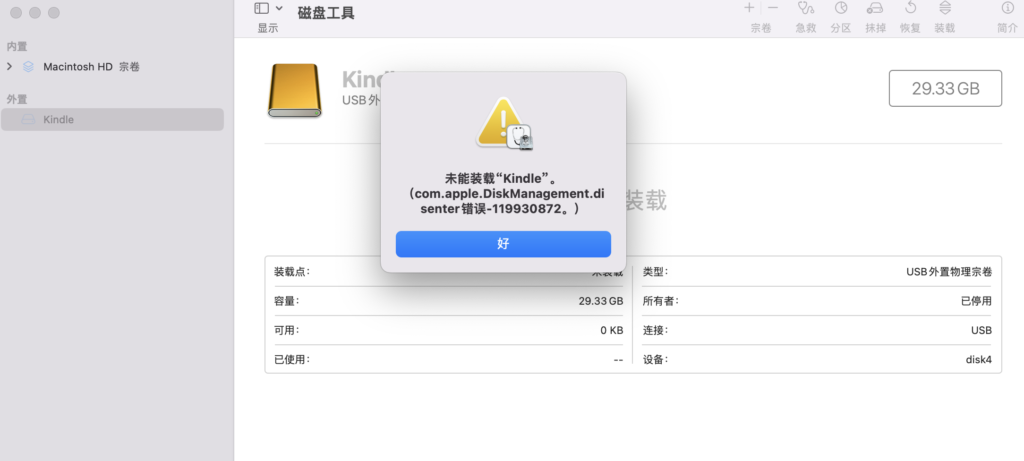
如果使用磁盘工具尝试加载,也会报错 com.apple.DiskManagement.disenter错误-119930872。

报错的提示

无法使用系统工具加载。

解决方案

在参考了 jakevin 的分享后,我使用如下方式来解决我的 Kindle 挂载问题。

查询外置设备

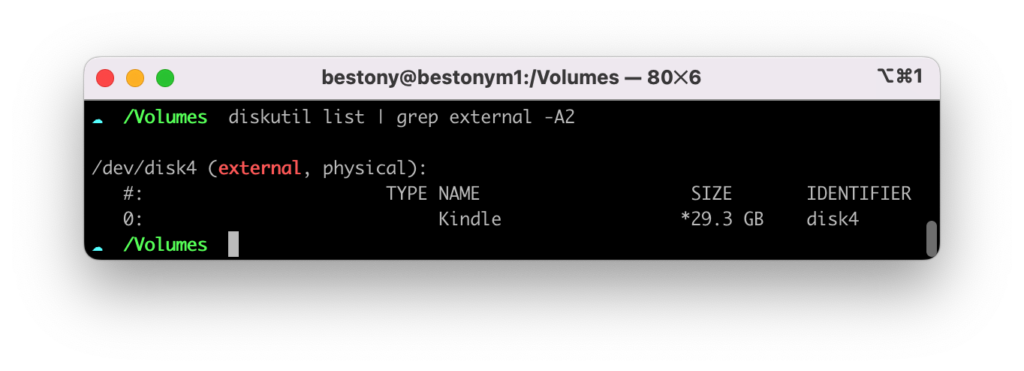
执行如下命令,可以使用系统自带的 diskutil 查看目前有哪些磁盘。我在这里补充了 grep,来筛选出只有外置磁盘的设备。

diskutil list | grep external -A2
Code language: PHP (php)

手动挂载设备

执行如下命令,来手动挂载 Kindle。

sudo mkdir /Volumes/Kindle # 创建一个新的挂载点,挂载 Kindle
sudo mount -t msdos /dev/disk4 /Volumes/Kindle/ # 使用 mount 命令,挂载 /dev/disk4(你根据需要换成你自己的设备。)
Code language: PHP (php)

一般来说, Kindle 的默认格式化是 fat32 格式,所以用上面的命令就行,但如果你的 Kindle 是 ex-fat 格式,则可以使用如下命令挂载。

sudo /sbin/mount_exfat /dev/disk4 /Volumes/Kindle/ #这里使用的是 mount_exfat。
Code language: PHP (php)

如此操作,便可以让 M1 识别 Kindle 了。

Read More

Feed 订阅调整说明

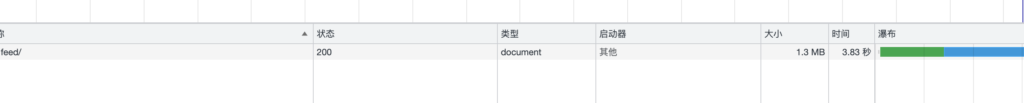
本站一直以来,都开放了 Feed 的全文订阅,方便读者阅读,不过由于博客时间较长,文章越来越多,导致 Feed 越来越大,目前已经到达了 1.3 MB

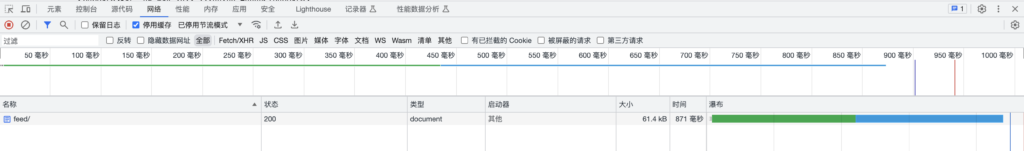
较大的 Feed 文件会导致在进行新读者加载时耗费较多时间,因此,我将 Feed 输出的条目调整为 50 条,内容依旧保持全文开启,以方便使用 Feed 订阅的同学。

调整后,Feed 大小只有 64 KB,加载速度也更快。

如果你希望看到我所有的历史文章,可以直接访问本站的归档页面查看。

question mark neon signage

疑问,是更好的提问方式

我是一个比较反感“反问”的人。

总的来说,是因为我对于反问的感观不太好,特别是反问背后所表现出的挑战(这可能源自我是一个不那么自信的人)。反问带给我的感受更多的是“不认可”、“不信任”,从而激起我的反抗。反问,拥有一定的攻击性。

而疑问,则是一个更好的选择,特别是在人多、鱼龙混杂的时候,能够更好的隐藏自己的意图,将自己保护起来。反问则会更加暴露出你的倾向,并不适合自我保护,过于锋芒毕露。

提醒自己,不要做一个总是”反问“的人。

selective focus photography of monk at corridor

大部分中国人没有信仰

大部分中国人是没有信仰的。

你可能会问,中国人不是也去寺庙去拜佛,也到教堂去做礼拜。为什么说中国人没有信仰呢?

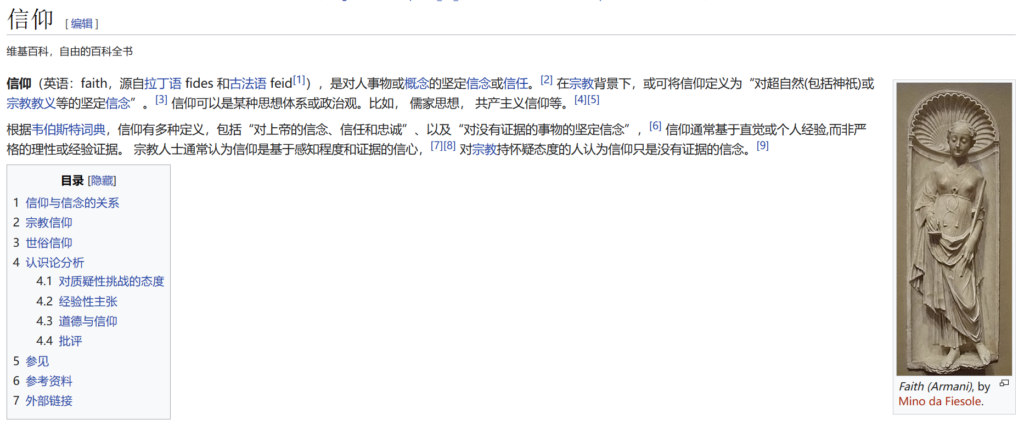
在维基百科中,对于信仰的定义是“人事物或概念的坚定信念或信任。”,但对于那些去寺庙拜佛、去教堂礼拜的人来说,他们可能并不坚定的认为这些“神”的存在的,他们关注的也不是自己对于“神”的信仰,而是关注神到底能为自己解决多少问题?

这也是为什么我们发现,财神庙总是香火最旺。

推荐一个最近发现的好东西 — Save To Notion

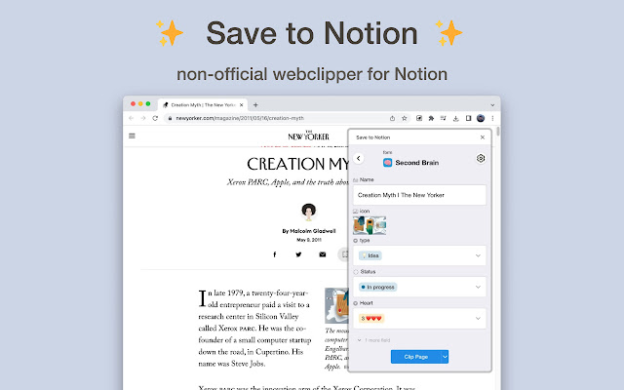
这个工具是我在研究别人的的 Notion 工作流时发现的,一个支持从网页中提取核心数据的 Notion Saver 插件 —— Save To Notion(官网)

和绝大多数 Notion Saver 类似,Save To Notion 也支持直接存储一个书签到 Notion 当中,对于平时需要大量阅读的人来说,这是一个和其他产品无法形成差异化的 Feature。

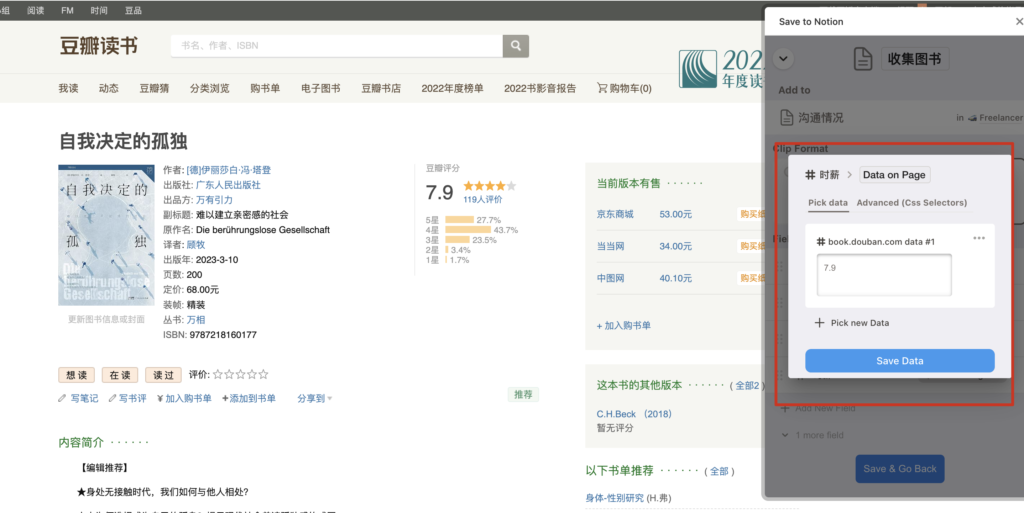
但 Save To Notion 一个非常厉害的功能,是你可以在你的保存表单中,设置从网页中提取数据,它应该是采用了 XPath 来实现这个 Feature,你可以根据自己的需求,从页面中选择数据来提取,从而可以基于 Notion 完全实现一套自己的数据库。相比于其他 Saver,多了一步解析数据的能力,而这个能力,可以帮助你节约许多的时间。

Just Use IT!

a person stacking coins on top of a table

Flomo 收购幕布 – Win-Win Game

Flomo 收购了幕布,这是个我难以相信的事情。但仔细想想,其实很合理,也很有价值。

作为幕布的原持有方,字节跳动面临着业务需要收缩,战略需要聚焦的现状,养着一个幕布团队没有太大的意义,只不过是因为之前和用户的协议所迫,不得不继续维护。能过将幕布卖出去,对于字节跳动来说,是利大于弊的。且字节跳动收购产品一般是来收购团队的,而在字节跳动的产品飞书当中,已经实现了类似幕布的能力,对于字节跳动来说,幕布的历史使命已经完成,继续留着只不过是鸡肋,刚好 Flomo 要收购幕布,就可以顺利成章的将其出售出去。

而作为幕布的收购方 Flomo,则更是一个好的选择,Flomo 本身的调性和幕布十分匹配,对于 Flomo 的用户来说是利好,对于幕布的用户来说,也不算差。而对于 Flomo 团队来说,Flomo + 幕布的组合,可以让其在知识管理上进一步拓展,挺好。

一个难得的 Win-Win 的收购。当然,对于我来说还是难以想象的,毕竟,都是字节收购别人家的产品,第一次碰到从字节收购产品的。

少楠厉害!👍。

photo of silhouette photo of man standing on rock

2023, 松弛

2022 年,为了保持对自己的压力,我保持了为期一年的高密度更新。回过头去看,我觉得这些更新有价值,将我思维中的碎片都展现出来了。但同样的,这些碎片过于简单和不集中,可能对于绝大多数人来说,其实很难有比较大的帮助。对于我自己来说,也只是将我的思维碎片提前拿出来,而不是在我自己的脑海里发酵一下。

在 2023 年,我对自己的定位是松弛,不再逼自己去做一些事情(即使这些事情的确很好),而是更加随性,不强求,看命,看运。

MacBook Pro on brown wooden table

ChatGPT-FeiShu 为什么能火?

自 复盘 – ChatGPT-Feishu 项目 之后,我的项目也经历了一些迭代,OpenAI 也将最新的 ChatGPT 所使用的 API 版本进行了开放,对于我们开发者来说,无疑是一场狂欢。

而在这个过程中,ChatGPT-Feishu 也收获到了不少的关注,用户越来越多,在这个时候,我开始思考 Why?

一方面,是 ChatGPT 本来就很热,毕竟是一个 AI 新物种,看起来比过去的各种 NLP 产品都更有意思。再加上各种媒体的渲染, ChatGPT 成功的出圈了。

另一方面,是 ChatGPT 在注册和使用上存在限制,大部分的普通人是无法直接使用的,所以使得 ChatGPT 又有了一些神秘感。这种限制使得我们这些能够将 ChatGPT 的能力提供出来的项目得到了更多的关注。

而最后,则是 ChatGPT 和企业协作场景的契合,如果你将 ChatGPT 接入到企业的聊天工具中(如飞书、企业微信),就可以让一个企业的人用起来 ChatGPT,且可以在不损失企业上下文的场景下使用,可以达到非常好的日常使用的效果。

说起企业协作的场景契合,让我想起了多年前的 ChatOps。我前几天去看,Hubot 项目已经被 Archive 掉了,真的是时代的眼泪💧。

MacBook Pro on brown wooden table

OpenAI 的 API 使用的三种层次

随着 ChatGPT 的逐步推广,我看到了大量基于 OpenAI 的产品出现,如果要将其分层,我认为可以分为三层:

Connect 层:只是在使用 OpenAI 的 API ,并没有做太多的功能提升

比如我自己做的 ChatGPT-Feishu,其实就是在这个层次,更多是将 ChatGPT 和一些现成的应用进行连接,所以差异性不大,大家大多是在技术上卷一些新的 Feature。

在我看来,这个层次的卷动是非常有限的,因为现成的应用和场景就这些,大部分时候我们能做到的也就是将 ChatGPT 和现有的生态更好的结合,但没有什么本质上的变化。

Prompt Engineering 层:预制 Prompt,帮助用户问出好问题

当我们仔细去看社交网络上的那些 ChatGPT 的用法之后,其实你会发现, 大多数人对于 ChatGPT 的用法是非常简单粗暴的 —— 问一些过去问搜索引擎的问题。ChatGPT 会给你一个看起来还不错的答案。

这个问题背后其实是大部分人是问不出一个精确、明晰、易于理解的好问题的。

而 Prompt Engineering 层的产品则可以实现对于问题的解构,将一个复杂问题拆解为一套模板 + 一些用户可以理解和输入的内容,从而降低提问的难度。

这一层的应用更多是在卷不同的场景以及对于 Prompt 的优化,以实现更加精准和优质的返回内容,从而帮助用户解决问题。

Finetune 层:对模型进行微调,以符合应用和业务的场景

OpenAI 对于模型提供了 Finetune 的能力,开发者可以准备自己的数据集,将其上传至 OpenAI,由 OpenAI 对模型进行微调,后续开发者可以使用经过微调的模型来进行自动的补全。

这个层面大家卷的就是行业领域认知和干净的数据了,就回到了 AI 经典的行业落地场景了:收集行业数据 – 清晰数据 – 训练模型 – 实际应用。只是 OpenAI 将这件事的难度给降低了。对于开发者来说,可以更加低成本完成整个流程。

如果你只是玩票,那我觉得第一层和第二层都是不错的。但如果你打算正经做个事情,那么第二层可能是必备的基础。