乐观和悲观是一个人自小到大所接受的教育、自身基因所带来的。而这种乐观和悲观可以造就非常不同的做事的方法和做人的视角。
同样一个问题,乐观者遇到后思考的是解决问题的办法,如何通过努力使得问题变成一个可以被解决的问题,乐观者总是在不断的尝试一种可能,来完成要做的事情。
而悲观者则更多的关注着一件事的不可能性。如果一件事有一百种方式可以实现,那就有一万种方式不可以实现。
这就是我们常说的,悲观者往往正确,但乐观者往往成功。
乐观和悲观是一个人自小到大所接受的教育、自身基因所带来的。而这种乐观和悲观可以造就非常不同的做事的方法和做人的视角。
同样一个问题,乐观者遇到后思考的是解决问题的办法,如何通过努力使得问题变成一个可以被解决的问题,乐观者总是在不断的尝试一种可能,来完成要做的事情。
而悲观者则更多的关注着一件事的不可能性。如果一件事有一百种方式可以实现,那就有一万种方式不可以实现。
这就是我们常说的,悲观者往往正确,但乐观者往往成功。
我的博客相比于互联网上的众多博客来说,其实没什么特别的,甚至我的博客其实还不如很多技术的博客,能够专注在某一个技术领域上。
我的博客则显得随性许多,当我最近在研究某个技术的时候,我就会开始快速的、集中式的撰写我在相关领域踩过的坑、我自己的心得总结(比如之前有段时间频繁的写 VSCode,主要其实是因为当时我在研究 VSCode 插件)。当我最近在生活中有了新的东西,我也会集中的写一些内容(比如之前买了车,连续更新了不少关于车的内容)。
但实话说,我的博客可能比很多人的博客的流量要好很多了,每天基本上可以保证 100UV(相关数据可以看 博客 2023 年广告招商 中的数据)。
到底是因为什么呢?何其荣幸能让大家来看我的博客呢?
如果有原因,我想可能便是坚持。
虽然我的博客文章可能比较零散,风格也没有那么集中,但长时间的写作,让我的博客累计了不少的读者,大家或是在网站中直接查看我的博客,或是通过 RSS 阅读我的文章,已经习惯了我的文章更新。
时间,让我成为了大家那个能一直更新的朋友,你知道,来到这里,总是可以看到我写的文章,我最近的变化。
对于我来说,写作不为别人读,更多的是为了让我自己可以更好的梳理我内心的所思所想。甚至我现在还有写日记的习惯,便是为了能够让自己每天记录下自己纷乱的思绪。我能做的,便是一直写下去,不停的写下去,直到我写不动了,不愿意再写了,不能再写了。便停下自己的脚步。

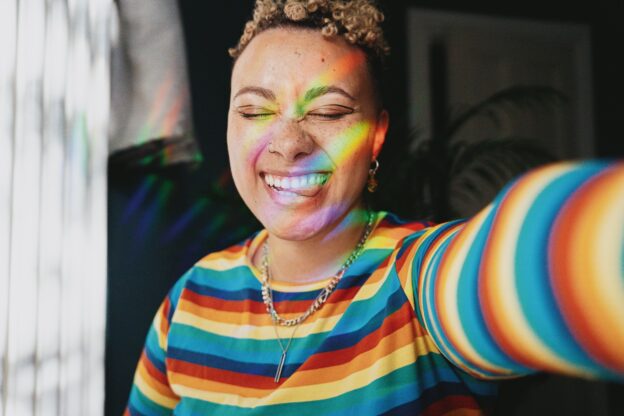
周末去拾光秀照相馆拍了照片,中间被摄影师引导微笑,摄影师描述我的笑就像是“职业假笑”。
回想一下,近几年我的确很少再笑了,嘴角反而是习惯性的下撇,看起来人有点凶,笑起来幅度也没有那么大,就会显得很像假笑。
甚至于在某些我不笑的形象照中,如果的确需要笑的照片,我会选择用一些 AI 的工具,来把不笑的我变成在笑的我。
今天照着镜子看了看,可能主要是因为胖…因为胖了一笑脸上肉就会堆起来….还是要减肥….
随着 ChatGPT 的出现,我们发现,很多工作似乎不再需要人来做了。写博客?ChatGPT 可以写的 比你更好,写的更快,写的更多。写代码?ChatGPT也能干,甚至比你可能写的要标准。
不少人因此恐慌,觉得自己的工作已经失去了意义和价值 ,自己即将被 ChatGPT 所替代。
对于从事重复性劳动的人而言,平心而论,确实将要被替代。我们不再需要人来做重复性的劳动,机器人可以全年无休,永无止境的工作下去,且随着技术的不断演进,机器的成本将会不断的降低。如果你的工作只是低水平的重复,那么你终将被替代,无非是现在,或者是未来。
能让我们持续的工作下去的,是我们对于事情美好的认知,这些认知源自我们从社会上习得的上下文,为了保证美好,企业愿意为此付出成本,来养活我们。想要持续的有价值,培养自己的审美,是必不可少的。
很早之前,我就看过雷 · 达里奥的视频《经济机器是怎样运行的》。在我看来,任何现代人都值得看看这个视频,即使你对于经济完全不了解,也没有兴趣了解,你知道应该知道我们这个社会的经济是如何开始运转的,从而以此来引导你的生活。
经济机器是怎样运行的我之前就推荐过一次。
在这个视频中,其实有说明,我们的经济中的钱其实是一部分人花钱,另一部分赚钱。而疫情之后,对我来说则更加证实了其对于经济的理解。
疫情之后,我们经常发现大家对于经济没有信心,从而消费水平下降,消费降级,更多存钱。这是好事,我们都更加关注给自己留出安全边界。这也不是好事,因为我们中一部分人花掉的钱,则是另一部分人挣来的钱。如果一部分不花钱,则另外一部分没办法挣钱。毕竟,钱只有流转起来,才有其价值,不然不过是废纸一张。
这也是为什么我们看到了大量的国家政策希望提振经济(虽然我觉得发文也没啥用),因为只有我们当中的一部分人敢于花钱,才有可能让另外一部分人赚钱。才能盘活整个经济机器。
当然,国家的预期和我们个人的预期未必一致,我们可以反过来想想,既然我们花掉的钱是别人挣的钱,那么我们的消费当中,哪一部分是应该花、值得花,那一部分是我们无意中消费掉的,除了给国家贡献 GDP,没有别的价值?
朋友问我:“你支持LGBTIQA+么?”
我的答案是,我不会反对。
对我来说,我始终能够感受到“有毒的男子气概”,也支持平权。但具体到某一个名词、一件事上,决策又不是那么的简单。
比如,LGBTIQA+ 对我来说,并没有什么特别的(就像美国某一个 KFC 换了一个接线员一样,对我来说可能毫无变化,当然,从蝴蝶效应的视角来看,依然有影响,但我有限的认知里,可能对我来说毫无影响),所以我既可以支持,也可以中立。
但如果落实到身边的朋友,我会选择支持。理由也很简单,既然对我来说,支持和中立一样,那我为什么不选择让朋友更开心的“支持”呢?
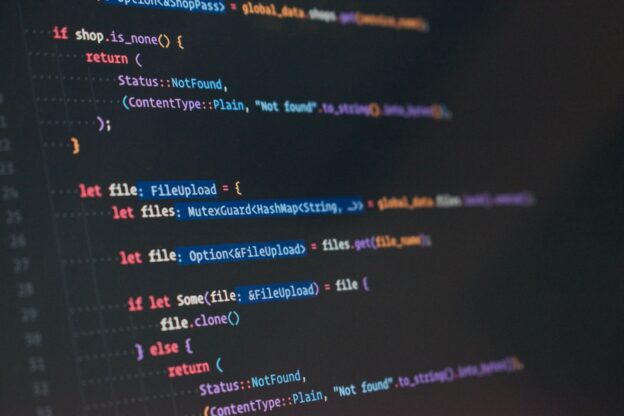
由于 Gitbook 长期不维护,为了保障整个架构持续可用,所以导致我不得不从 Gitbook 迁移到 mdbook。
在使用 mdbook 的时候,有个问题是,我的不少电子书域名都是备案过后的,mdbook 又不像 gitbook 支持可以在目录里跳转外链,因此我需要自己实现给 mdbook 添加一个外链。
由于没办法直接通过在 Markdown 当中实现跳转外链,那么一个比较简单粗暴的方法就是直接在模板当中添加,刚好 mdbook 在文档中有说明具体的操作方法。
你只需要在 mdbook 的根目录中创建一个 theme 文件夹,并生成一个 index.hbs 文件,用于渲染页面。
接下来,你只需要在适当的位置添加上你需要的代码即可(下方的 toc 后面的 有序列表便是我手动添加的)
   <nav id="sidebar" class="sidebar" aria-label="Table of contents">
            <div class="sidebar-scrollbox">
                {{#toc}}{{/toc}}

                 <ol class="chapter">
                    <li class="chapter-item expanded "><a href="https://beian.miit.gov.cn/" target="_blank">这里是你的备案号</a></li>
                </ol>

            </div>
            <div id="sidebar-resize-handle" class="sidebar-resize-handle"></div>

        </nav>
Code language: HTML, XML (xml)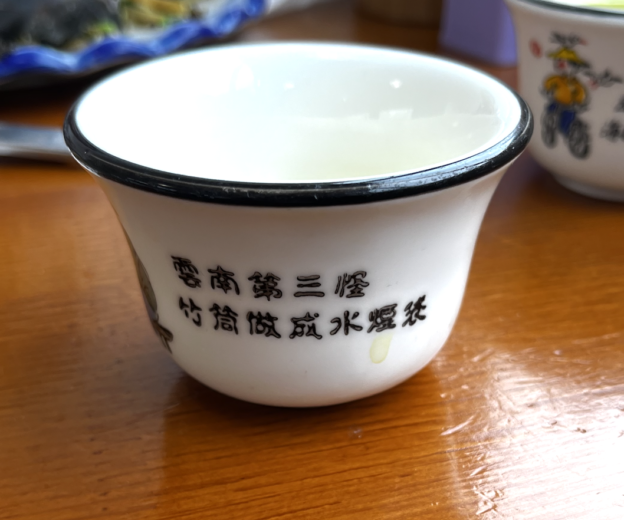
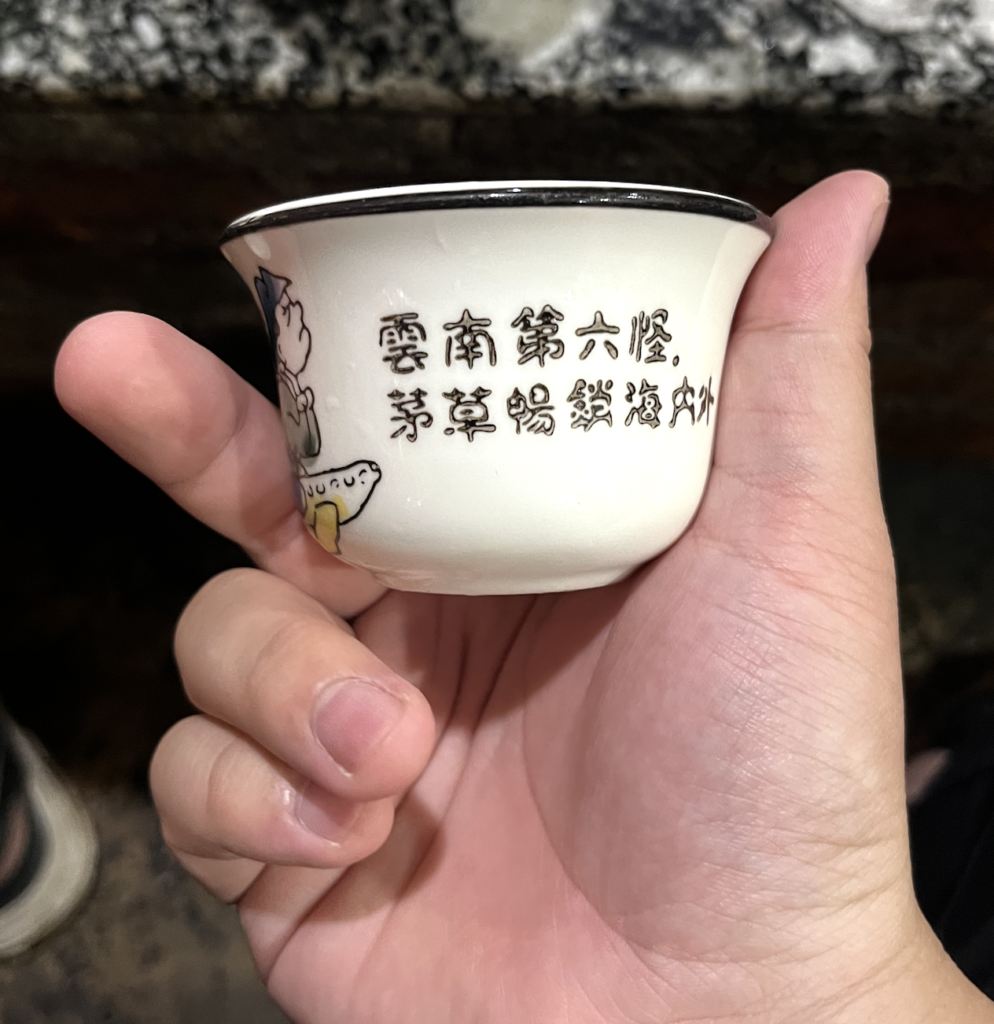
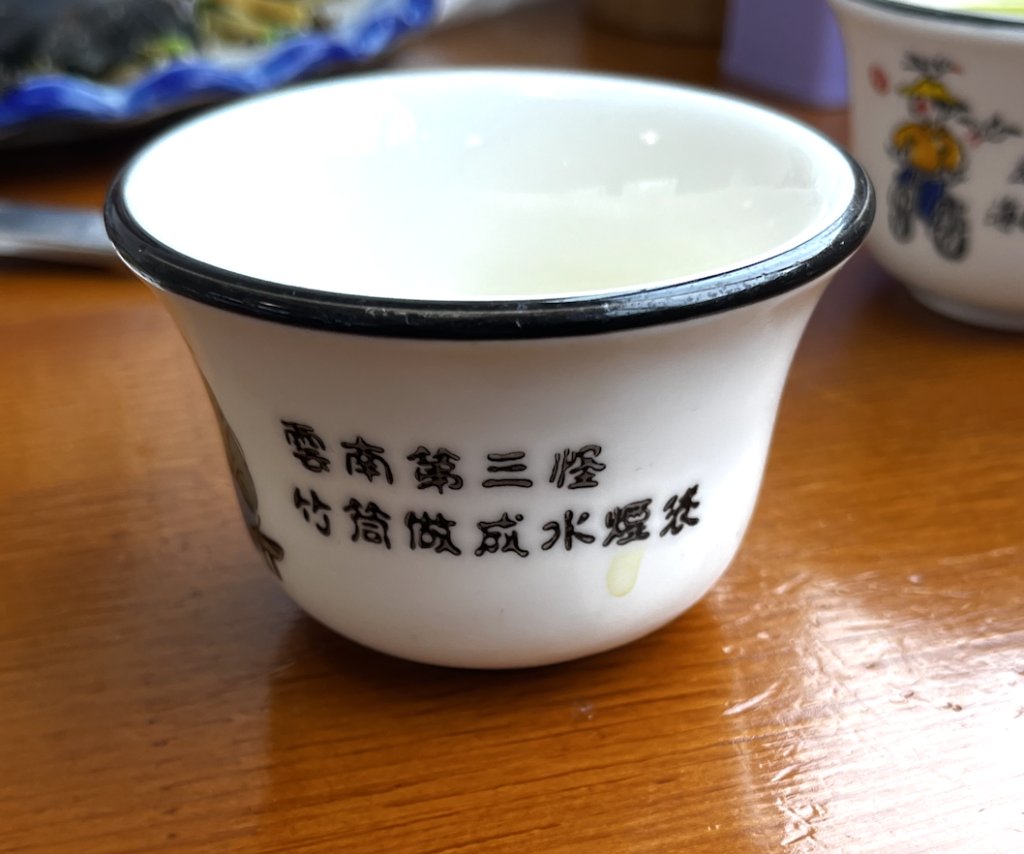
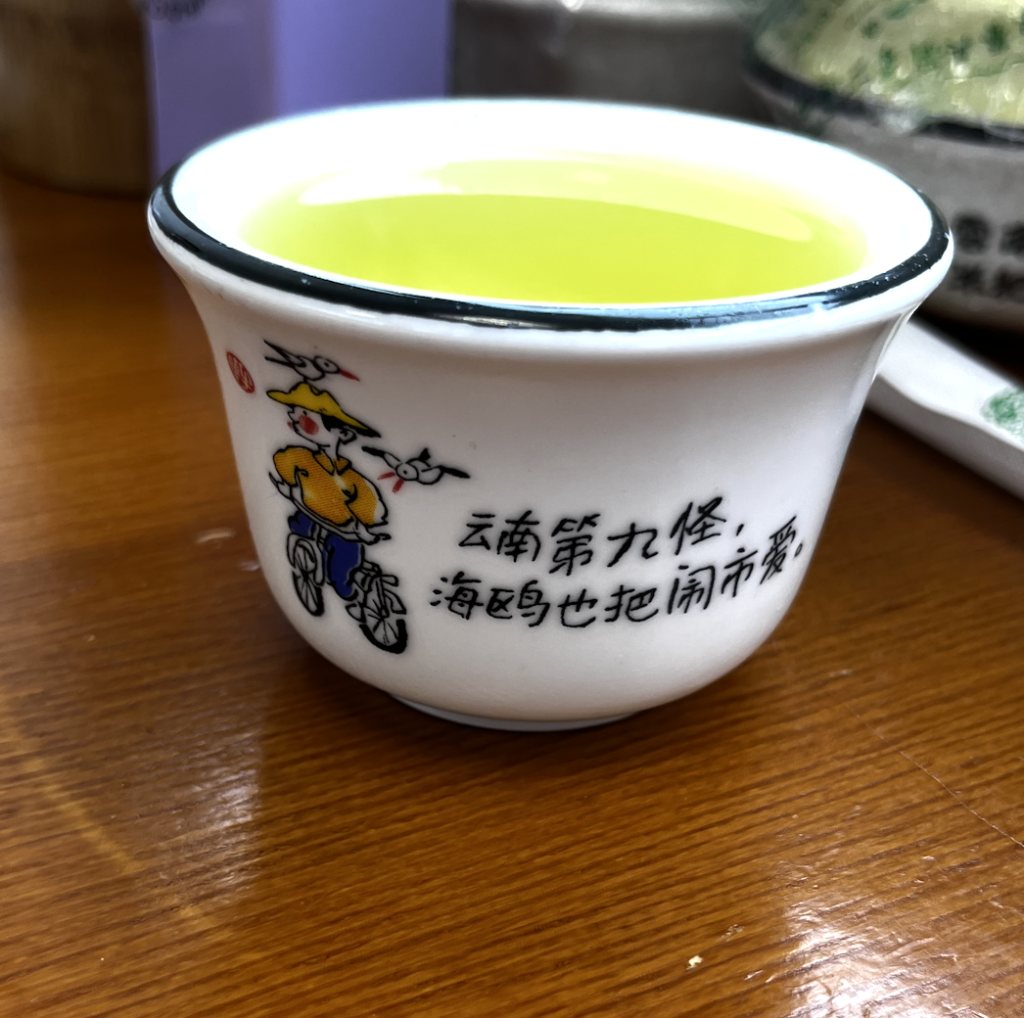
这次去云南,看到了各种各样奇奇怪怪的“云南十八怪”,让我不得不来吐槽一把。
在没去云南之前,我就知道云南有个“云南十八怪”,在解释云南各种和中原地区差异比较大的生活习惯,但说实话,一直没怎么了解过具体的细节,因为不熟悉。
根据百度百科,云南十八怪是这样的:
你说奇怪不奇怪,云南就有十八怪。
百度百科
四个竹鼠一麻袋,蚕豆花生数着卖;
袖珍小马多能耐,背着娃娃再恋爱;
四季衣服同穿戴,常年能出好瓜菜;
摘下草帽当锅盖,三个蚊子一盘菜;
石头长在云天外,这边下雨那边晒;
鸡蛋用草串着卖,火车没有汽车快;
小和尚可谈恋爱,有话不说歌舞代;
蚂蚱当作下酒菜,竹筒当作水烟袋;
鲜花四季开不败,脚趾常年露在外。
但我在云南当地,见到了各种奇奇怪怪的十八怪,甚至炒酸奶也被编进了十八怪:“酸奶炒着卖”。
在使用 M1 的时候,我遇到一个很麻烦的问题是 M1 无法识别出我的 Kindle,系统无法自动加载 M1 设备,这导致习惯于导入标注并使用 Klib 管理的我来说,等于用 Kindle 的功能不齐全了。
使用 macOS 自带的系统工具,也可以看到系统 Kindle 的磁盘,但无法加载。
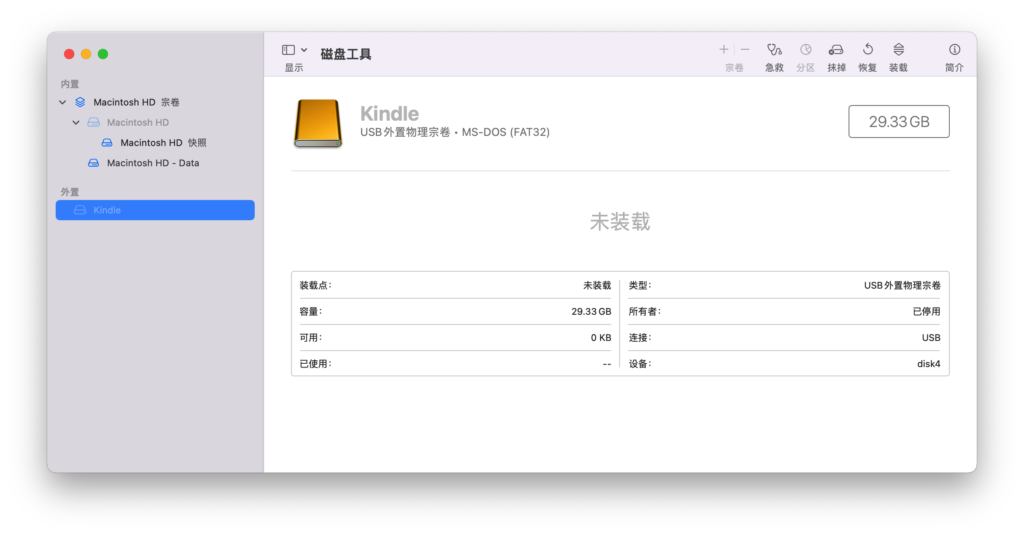
如果使用磁盘工具尝试加载,也会报错 com.apple.DiskManagement.disenter错误-119930872。
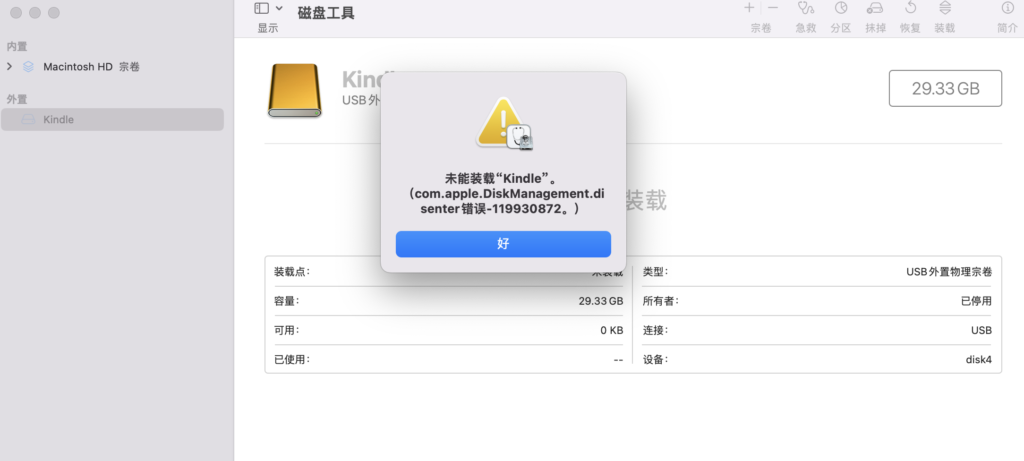
无法使用系统工具加载。
在参考了 jakevin 的分享后,我使用如下方式来解决我的 Kindle 挂载问题。
执行如下命令,可以使用系统自带的 diskutil 查看目前有哪些磁盘。我在这里补充了 grep,来筛选出只有外置磁盘的设备。
diskutil list | grep external -A2
Code language: PHP (php)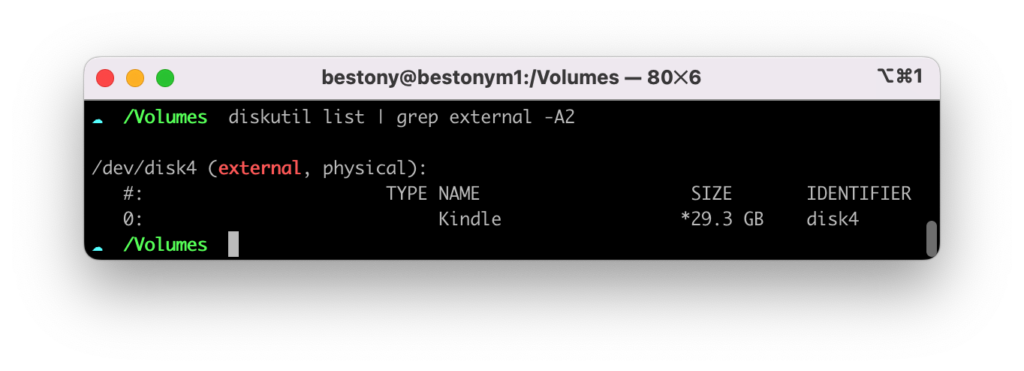
执行如下命令,来手动挂载 Kindle。
sudo mkdir /Volumes/Kindle # 创建一个新的挂载点,挂载 Kindle
sudo mount -t msdos /dev/disk4 /Volumes/Kindle/ # 使用 mount 命令,挂载 /dev/disk4(你根据需要换成你自己的设备。)
Code language: PHP (php)
一般来说, Kindle 的默认格式化是 fat32 格式,所以用上面的命令就行,但如果你的 Kindle 是 ex-fat 格式,则可以使用如下命令挂载。
sudo /sbin/mount_exfat /dev/disk4 /Volumes/Kindle/ #这里使用的是 mount_exfat。
Code language: PHP (php)
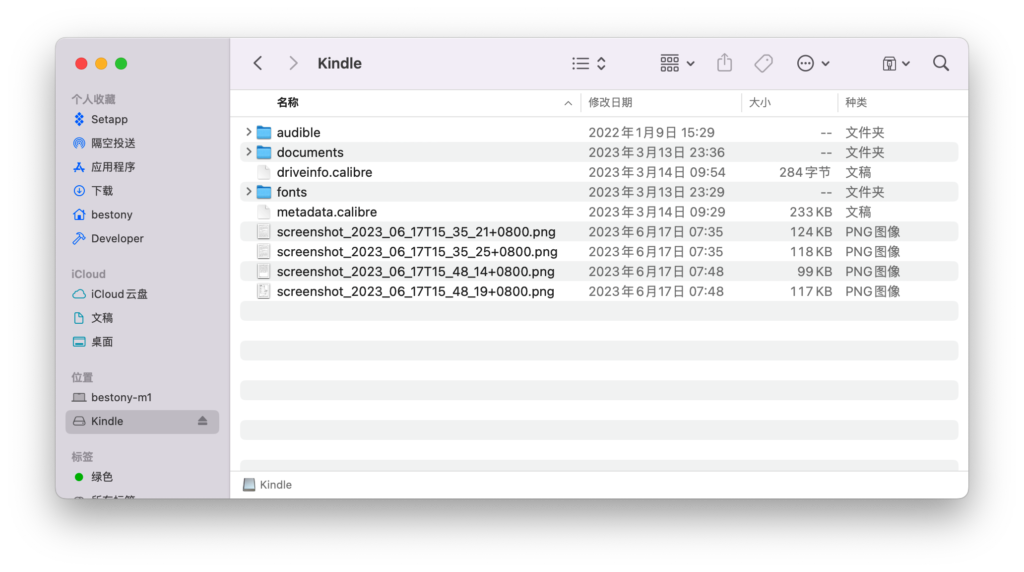
如此操作,便可以让 M1 识别 Kindle 了。
在开发服务端应用的时候,由于服务端应用本身的特性,其实是没有一个明确的版本的概念。毕竟不需要专门下载,理论上每次都是最新的,所以也没有版本的概念。
但在实际开发调试过程中,我们又的确需要关注版本的概念,因为会影响具体的表现形态,所以就需要有一个前后端协调的版本号概念,来帮助我们更好的定位问题,避免前后端之间的扯皮。
一个比较好的思路是,虽然服务端没有版本号概念,但大部分时候会有一个对应的 Commit ID(毕竟现在开发项目完全不用版本控制工具的还是挺少见的)。所以,你可以选择将 Commit ID 作为版本号,进行输出,从而让协作者知道当前线上跑的版本,便于 debug。
在具体实现时,有两种方式:
我自己平时会把 Vercel 和 Next.js 提供的 API Route 作为一个简单的 Serverless FaaS 环境来使用,因此一个诉求便是在 API Route 当中返回具体的 Commit ID。而为了避免对代码的侵入,将其放在 Response Header 当中是比较合适的。
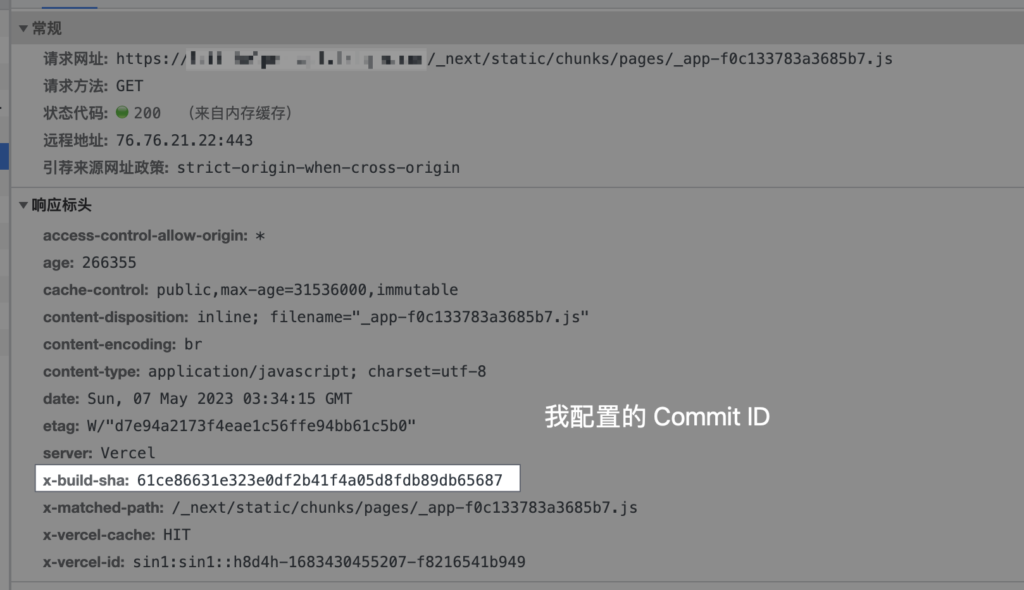
而如果你希望和我一样,达成对特定路由下的返回结果添加特定的 Header(比如上面截图中 x-build-sha 就是我添加的 Commit ID 的 Header),则需要借助于 Next.js 提供的自定义 Header 能力。
通过在 next.config.js 当中的 header 属性中添加具体的配置,来实现对特定的路径下添加自定义 Header。
module.exports = {
  async headers() {
    return [
      {
        source: '/about',
        headers: [
          {
            key: 'x-custom-header',
            value: 'my custom header value',
          },
          {
            key: 'x-another-custom-header',
            value: 'my other custom header value',
          },
        ],
      },
    ];
  },
};
Code language: JavaScript (javascript)
这里面比较关键的是 source 字段,这个字段定义了究竟哪些路由下会返回特定的 Header。比如上面的这段配置就是只给 /about 添加具体的 Header。你可以使用 /:path* 来匹配所有路由,从而实现给所有路由都添加上具体的 Header。
以我为例,我在线上跑的配置实际上是下面这段配置:
/** @type {import('next').NextConfig} */
const nextConfig = {
  reactStrictMode: true,
  async headers() {
    return [
      {
        source: '/:path*',
        headers: [{ key: 'X-Build-SHA', value: process.env.VERCEL_GIT_COMMIT_SHA }]
      }
    ];
  }
}

module.exports = nextConfig
Code language: JavaScript (javascript)
在上面这段配置中,我给所有的路径都配置了一个 x-build-sha 的 header ,并从进程的变量中提取出 VERCEL_GIT_COMMIT_SHA 变量(这个变量在 Vercel 的部署环境中指向具体的 Commit ID)的值,将其返回。
除了在 Header 中返回,如果你是需要去 Debug UI 的话,版本号同样重要,这个时候,你可以选择将 Commit ID 放在界面上,从而实现快速找到 Commit ID。
在 Vercel 部署的 Next.js 上,有一批 Next.js 框架所属的环境变量, 可以直接在 UI 当中引用(上面的 VERCEL_GIT_COMMIT_SHA 是不能在 UI 中直接引用的)。
只需要在特定的位置,加入SHA: {process.env.NEXT_PUBLIC_VERCEL_GIT_COMMIT_SHA} ,就可以展示具体的 Commit ID。
(除了 Next.js,其他框架也有类似的框架变量可以使用,你可以根据自己的需求来选择)。
在服务端 Debug 时,将你的 Commit ID 以某种方式返回可以有效的帮助快速定位问题,试着给你的 Next.js 添加上这个 Commit ID,来加速你的问题排查吧~